
Тендеры и лиды
Информация
Информационные технологии и интернет
Май 2026
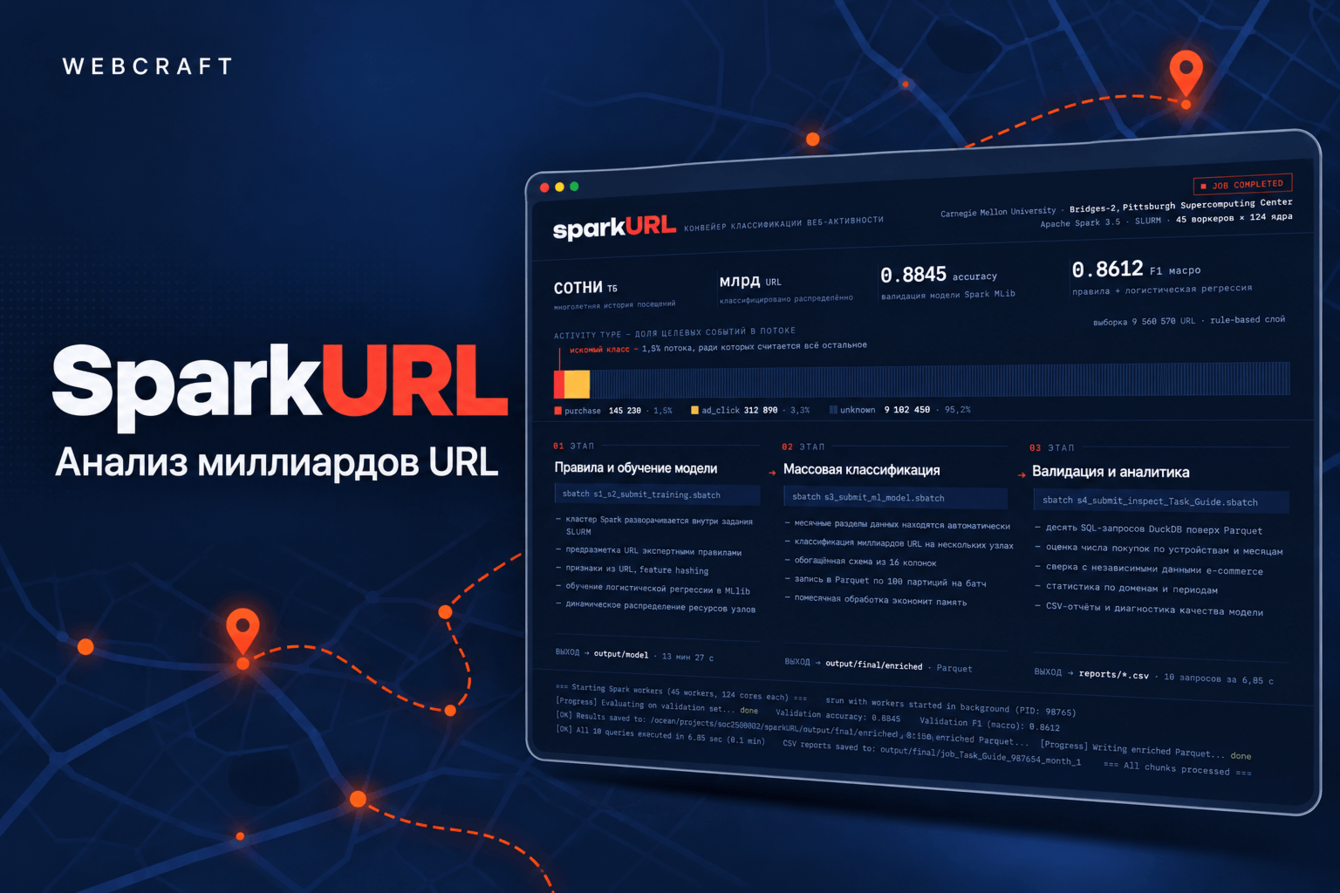
Для исследовательской работы Carnegie Mellon University нужно было найти покупки и переходы по рекламе в многолетней истории посещения сайтов. Исходные данные содержали сотни терабайт информации и миллиарды URL. Мы разработали конвейер, который классифицирует события по адресам страниц, обрабатывает данные на вычислительном кластере и помогает проверить, насколько достоверны полученные оценки.
Подготовили экспертные правила для разметки URL, извлечение признаков и обучение модели Spark MLlib. Apache Spark разворачивается внутри задания SLURM, поэтому обучение и обработка запускаются в общей вычислительной среде.
Система автоматически находит новые месячные разделы данных и распределённо классифицирует URL. Результаты сохраняются в Parquet. На Bridges-2 использовались 45 воркеров по 124 ядра с динамическим распределением ресурсов.
Построили агрегаты в DuckDB: покупки по устройствам, доменам и периодам. Сверили оценки с независимыми данными электронной коммерции и подготовили отчёты для изучения завышения и занижения подсчётов.
Собрали три задания SLURM: обучение, массовую классификацию и аналитическую проверку. Исследователь может повторить процесс от сырых логов до отчётов. Использованы Python, PySpark, MLlib, SQL и DuckDB.
Конвейер классифицирует миллиарды URL и формирует данные для исследования покупок и рекламных переходов. На валидационной выборке модель показала accuracy 0,8845 и macro F1 0,8612.
Заказчик получил воспроизводимый процесс обработки и отчёты для проверки качества оценок. Можно анализировать покупки по устройствам, доменам и периодам и разбирать случаи, в которых подсчёт расходится с независимыми данными.
 Bright Data: развитие сервисов и снижение нагрузки на базу данных
Cultural Quest: AR-квест с компьютерным зрением в мобильном браузере


