Тендеры и лиды
Информация
Пока команда ищет источник сбоя, сервис продолжает деградировать.
Проблема может быть где угодно: в приложении, Kubernetes-кластере, сети или базе данных. Когда метрики, логи и трассировки находятся в разных системах, время уходит не на устранение инцидента, а на сбор контекста и проверку гипотез.
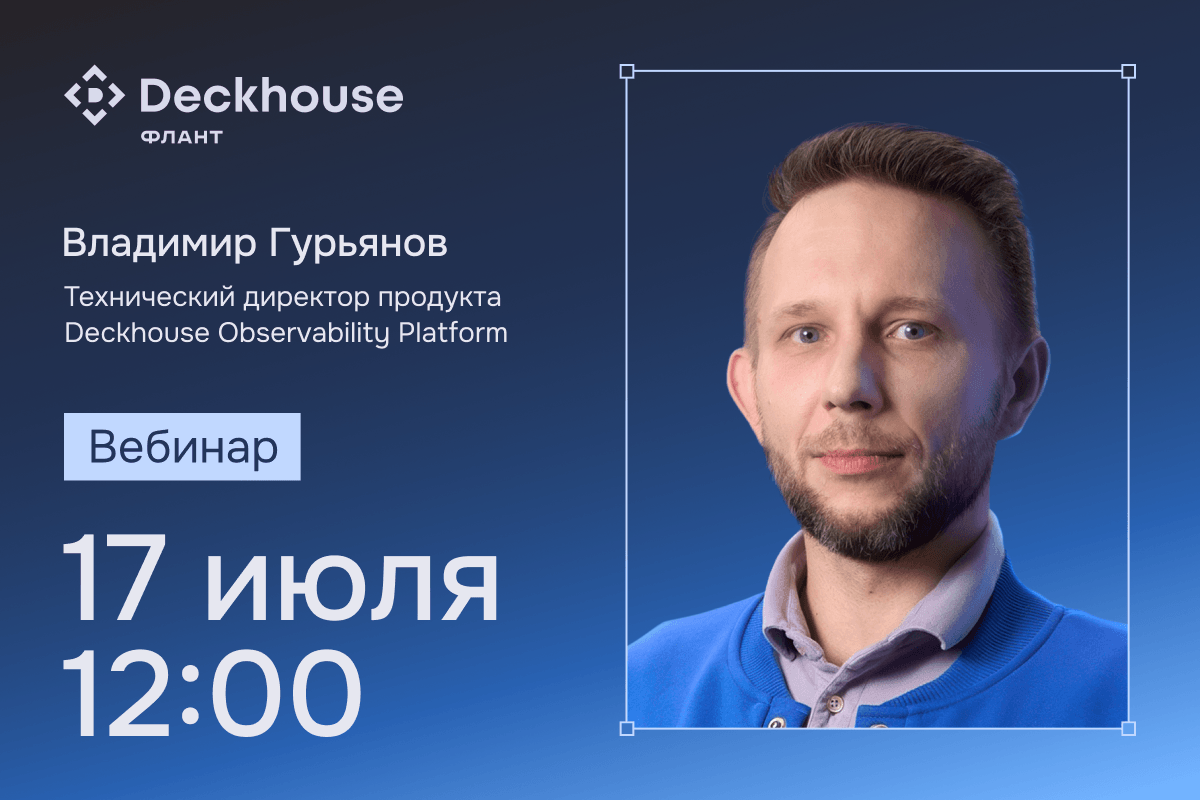
На вебинаре 17 июля покажем, как Deckhouse Observability Platform помогает пройти этот путь быстрее: от алерта до понимания, какой сервис затронут, какие зависимости участвуют в инциденте и где искать первопричину.
Разберём, что такое Deckhouse Observability Platform и как связать технические события с состоянием бизнес-сервисов, а также покажем live-демо — от настройки DOP до диагностики инцидента и поиска первопричины.
Спикер: Владимир Гурьянов, технический директор продукта Deckhouse Observability Platform.
Зарегистрироваться бесплатно: https://clc.to/web_dop19.