

Тендеры и лиды
Информация
Владельцы бизнеса, техдиректора и продакт‑менеджеры регулярно спрашивают нас:
«Нам точно нужна высоконагруженная архитектура? Мы же не маркетплейс с миллионами посетителей…»
«Сколько это будет стоить? Хотя бы примерно, чтобы понять, потянем ли мы»
«Как понять, что мы уже high‑load, а не просто “чуть‑чуть тормозим”?»
Мы в АЙТИФОКС специализируемся на высоконагруженных системах и на реальных проектах убедились: high‑load — это не про миллионы пользователей. Это про то, когда один из параметров системы становится узким местом и требует специальных решений, чтобы бизнес не страдал.
В этой статье — без воды, только факты, цифры и примеры из нашей практики.
Универсального значения RPS (запросов в секунду), после которого система автоматически становится высоконагруженной, не существует.
В одном проекте проблемы начинаются при 500 RPS из‑за тяжёлых операций с базой, в другом — при 10 000 RPS всё летает. Мы смотрим на совокупность параметров:
количество и характер запросов;
объём обрабатываемых данных;
время ответа системы;
нагрузка на базу данных;
количество внешних интеграций;
пиковые нагрузки;
требования к доступности;
возможность масштабирования;
влияние отказа одного компонента на остальные.
Критерий: high‑load — это состояние, когда один из этих параметров требует специальных архитектурных решений.
Если вы узнаёте хотя бы один пункт — пора действовать.
Не обязательно вся система. Может тормозить оформление заказа, поиск, формирование отчёта, загрузка большого массива данных или синхронизация с внешней системой.
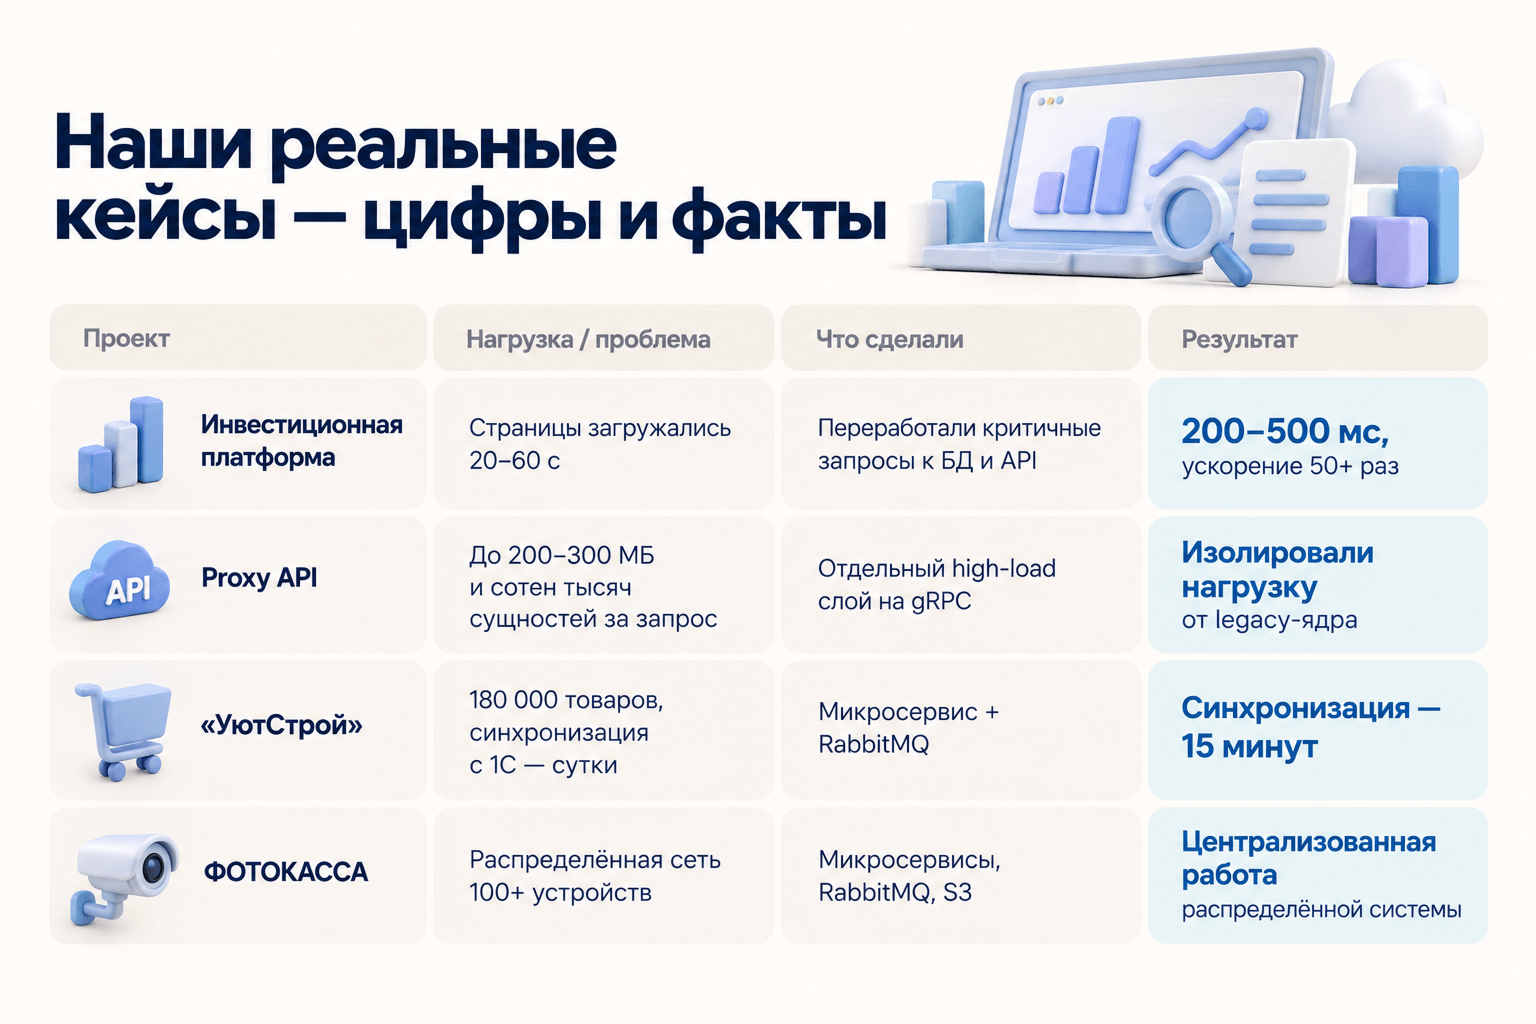
Пример: инвестиционная платформа, где страницы грузились по 20–60 секунд. После переработки критичных запросов к БД и API время сократилось до 200–500 мс — ускорение в 50+ раз.
Распродажи, массовые рассылки, старт продаж билетов — вы знаете о них за месяц, но всё равно готовитесь к коллапсу. Если рост нагрузки — чрезвычайная ситуация, а не рядовое событие — архитектура не готова.
Формирование большого отчёта нагружает базу так, что обычные действия пользователей тормозят. Процессы недостаточно изолированы.
Решения: разделить операции, поставить тяжёлые задачи в очередь, использовать кэширование, вынести ресурсоёмкие задачи в отдельные сервисы.
RPS — не единственный показатель. В нашем проекте Proxy API один запрос содержал 200–300 МБ данных и сотни тысяч сущностей. Мы сделали отдельный high‑load слой на gRPC, чтобы не нагружать legacy‑ядро.
Если при росте каталога, числа клиентов или интеграций вы постоянно вручную добавляете ресурсы и правите конфиги — система плохо масштабируется. Правильная архитектура позволяет наращивать мощность отдельных частей без переделки всего продукта.
Наша система сама подберет вам исполнителей на услуги, связанные с разработкой сайта или приложения, поисковой оптимизацией, контекстной рекламой, маркетингом, SMM и PR.
Заполнить заявку
13755 тендеров
проведено за восемь лет работы нашего сайта.
Многие думают: «Проблемы с нагрузкой — надо переходить на микросервисы». Это заблуждение.
Микросервисы полезны, когда:
нужно масштабировать разные части независимо;
требуется изолировать критичные процессы;
вы работаете с большим количеством внешних интеграций;
сбой одного компонента не должен обрушить всё.
Но они усложняют инфраструктуру, мониторинг, тестирование и поддержку.
В большинстве проектов мы начинали с оптимизации базы данных, добавления индексов и кэширования — это давало 80% прироста без сложной архитектуры.
Реальный пример: интернет‑магазин «УютСтрой» с каталогом на 180 000 товаров и синхронизацией с 1С. Мы не переписывали монолит, а вынесли обмен с 1С в отдельный сервис с очередью RabbitMQ. Время обновления каталога сократилось с суток до 15 минут — ускорение в 96 раз.
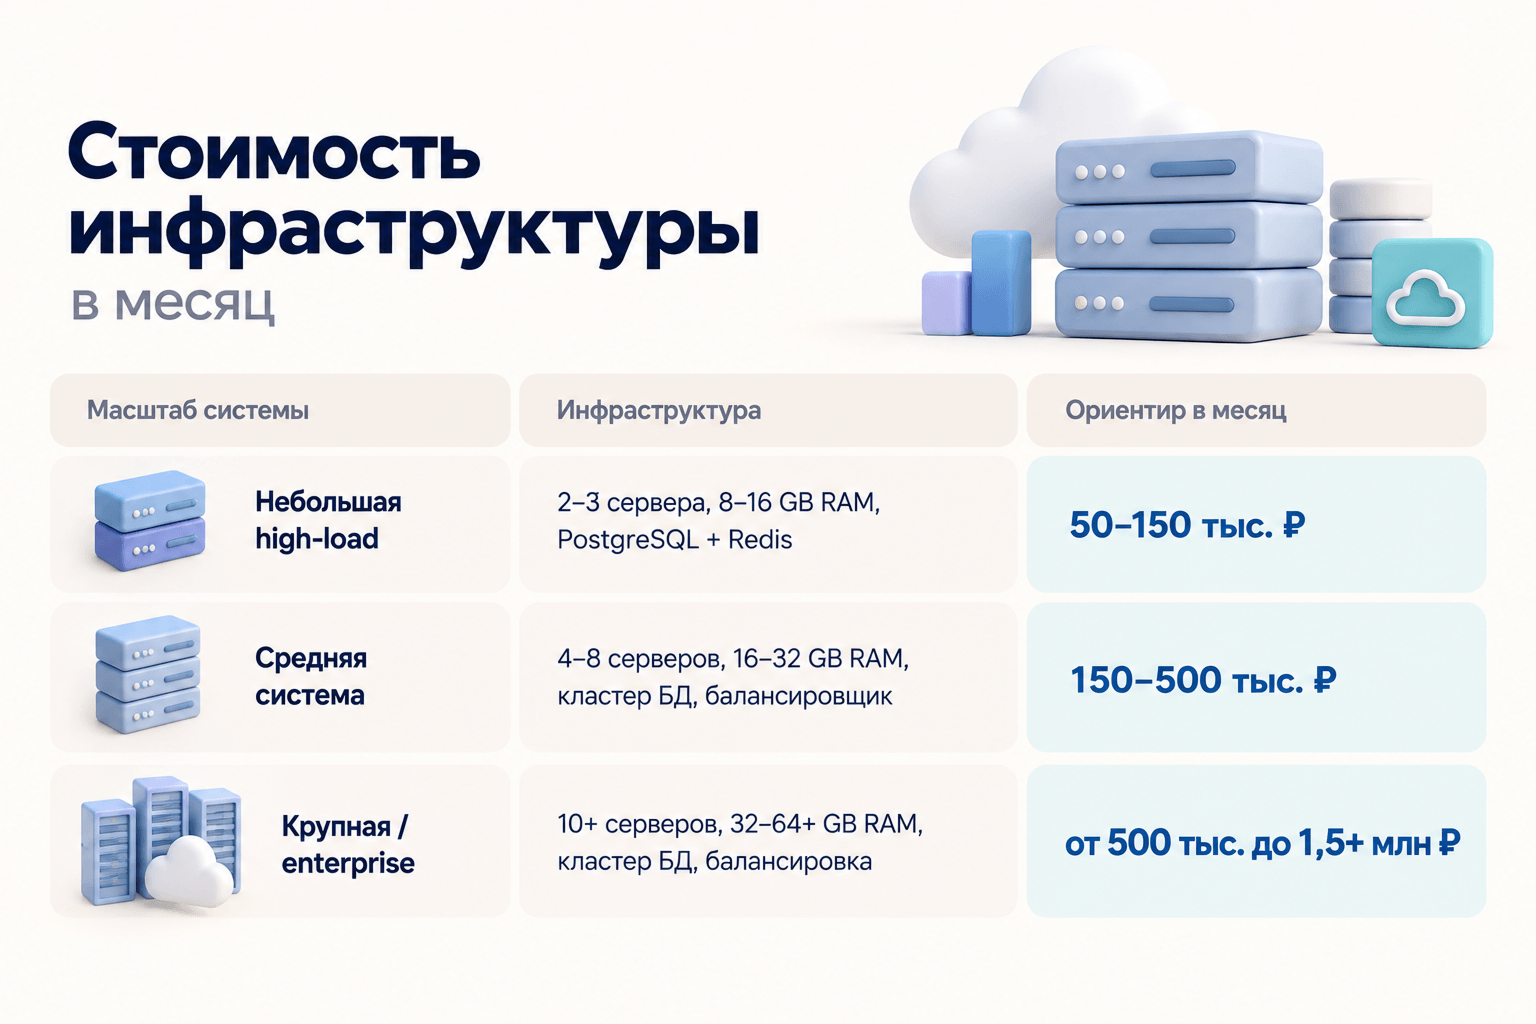
Каждый случай уникален, но вот порядок цифр, чтобы вы понимали бюджет.
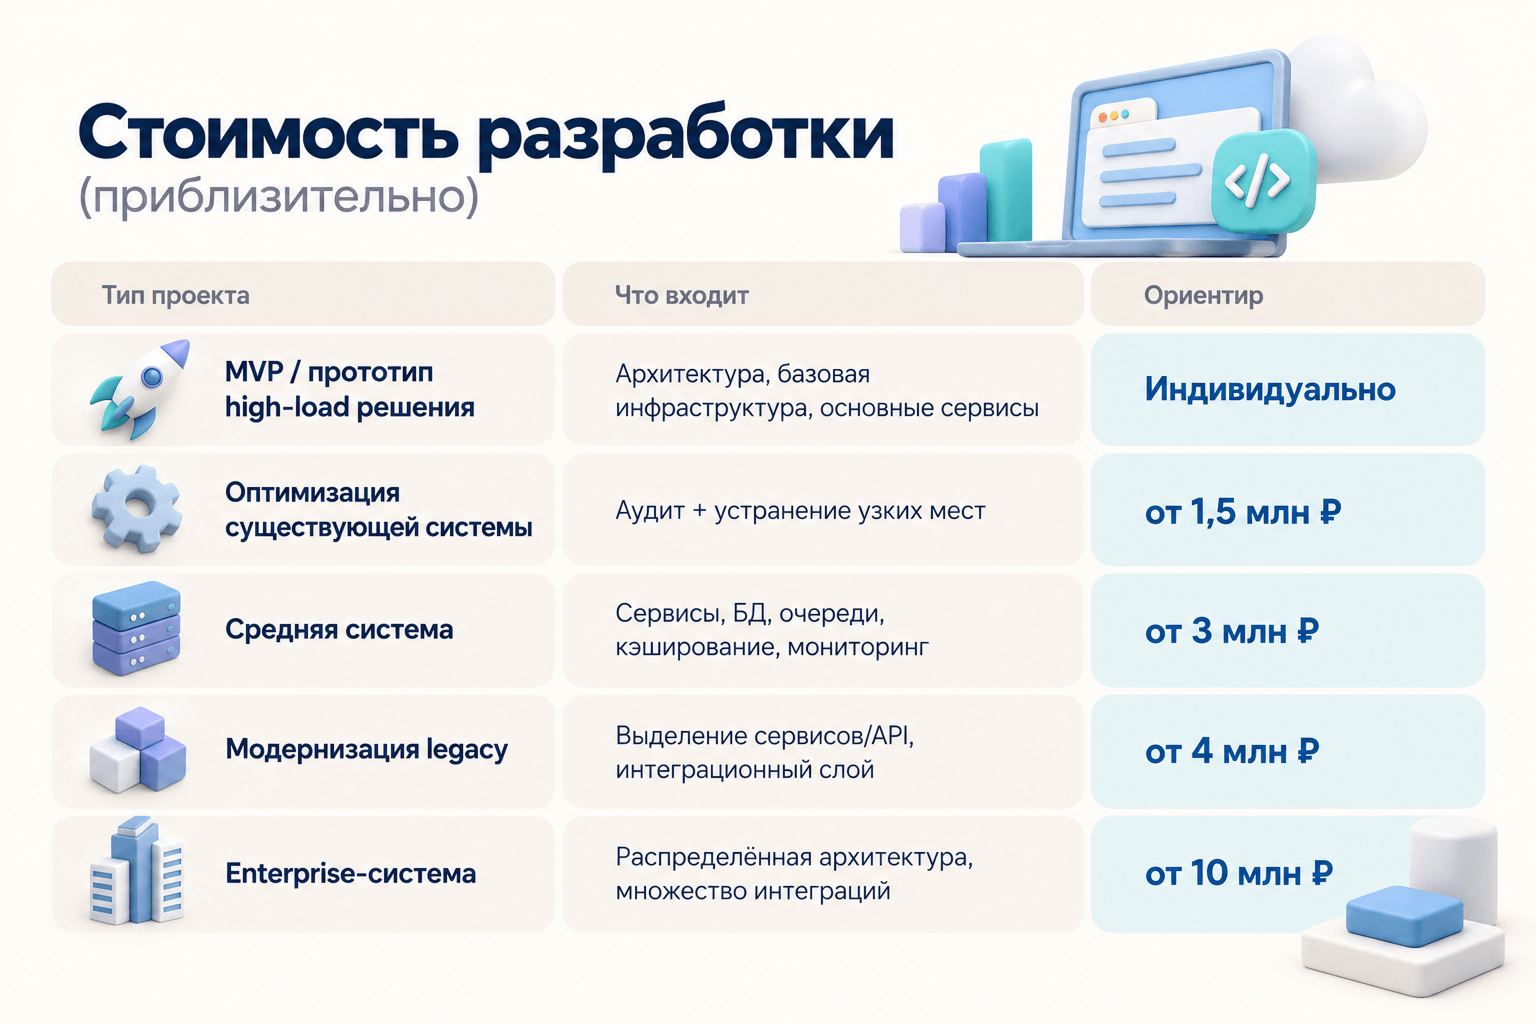
Два проекта с одинаковым количеством пользователей могут отличаться в разы из‑за характера операций, объёма данных и требований к инфраструктуре.
Главное: иногда дешевле заплатить за оптимизацию кода, чем покупать новые серверы. Правильно написанный запрос даёт больше, чем дополнительные мощности.
Мы придерживаемся чёткой последовательности, чтобы не потратить бюджет впустую.
Анализ нагрузки — измеряем самые тяжёлые операции, точки задержек, объём данных, пики, узкие места.
Проектирование — решаем, нужны ли микросервисы, где применить очереди, что кэшировать, как масштабировать БД.
Разработка критических компонентов — API, очереди, кэш, новый слой работы с БД.
Нагрузочное тестирование — проверяем RPS, время ответа (p50, p95, p99), ошибки, поведение при пиках.
Мониторинг после запуска — постоянно следим за временем ответа, ошибками, нагрузкой, состоянием БД.
High‑load — это не архитектура «спроектировал и забыл». Нагрузка и продукт меняются, поэтому система требует постоянного внимания.
Не верьте обещаниям «выдержать миллионы пользователей». Вот на что обратить внимание:
Просите конкретные кейсы — не список технологий, а цифры: нагрузка, узкое место, решение, результат.
Спрашивайте про опыт с legacy — часто high‑load делается на базе работающего бизнеса без остановки системы.
Пусть объяснят архитектурное решение — если аргумент «так современнее» — это красный флаг.
Уточните про нагрузочное тестирование и мониторинг — производительность должна измеряться, а не оцениваться на глаз.
Работа начинается с анализа — если подрядчик предлагает архитектуру до изучения вашей нагрузки — задумайтесь.
High‑load архитектура нужна не тогда, когда вы достигли магического числа RPS. Она нужна, когда текущая система перестаёт справляться: тормозит, работает нестабильно или не даёт бизнесу расти.
Правильный порядок: измерить → найти узкие места → определить требования → выбрать решение → протестировать → масштабировать.
Первый вопрос должен звучать не «а не пора ли перейти на микросервисы?», а «где сейчас ограничение и какое решение поможет его убрать?».