

 Alekzo
Тендеры и лиды
Информация
Сайт теряет позиции в поиске, а вложенный в контент и ссылки бюджет не приносит результата? Частая причина — дубли страниц. Поисковые системы видят несколько адресов (URL) с одинаковым или очень похожим содержимым. Это запутывает робота, заставляет его впустую тратить лимит сканирования (crawl budget) и размывает ссылочный вес. В итоге страницы могут выпадать из индекса, а трафик — снижаться.
Screaming Frog SEO Spider — профессиональная программа для технического аудита, которая позволяет быстро находить дубли страниц на сайте. Она анализирует все страницы так же, как поисковый бот.
Дубль — это ситуация, когда один и тот же контент доступен по разным адресам. Например:
site.ru/catalog/ и site.ru/catalog (со слешем и без);
site.ru/page и site.ru/page?utm_source=google (с UTM-метками);
HTTP- и HTTPS-версии одной страницы (зеркала);
страницы пагинации (site.ru/catalog?page=2), которые могут дублировать основную.
Наличие дублей создает проблемы:
Конфликт индексации. Робот не знает, какую версию считать оригинальной (канонической), и в выдачу может не попасть ни одна из страниц.
Пустой расход краулингового бюджета. Робот тратит время на сканирование копий вместо важных страниц.
Потеря ссылочного веса. Внешние и внутренние ссылки делятся между дублями, ослабляя целевую страницу.
Для начала скачайте, установите и активируйте Screaming Frog.
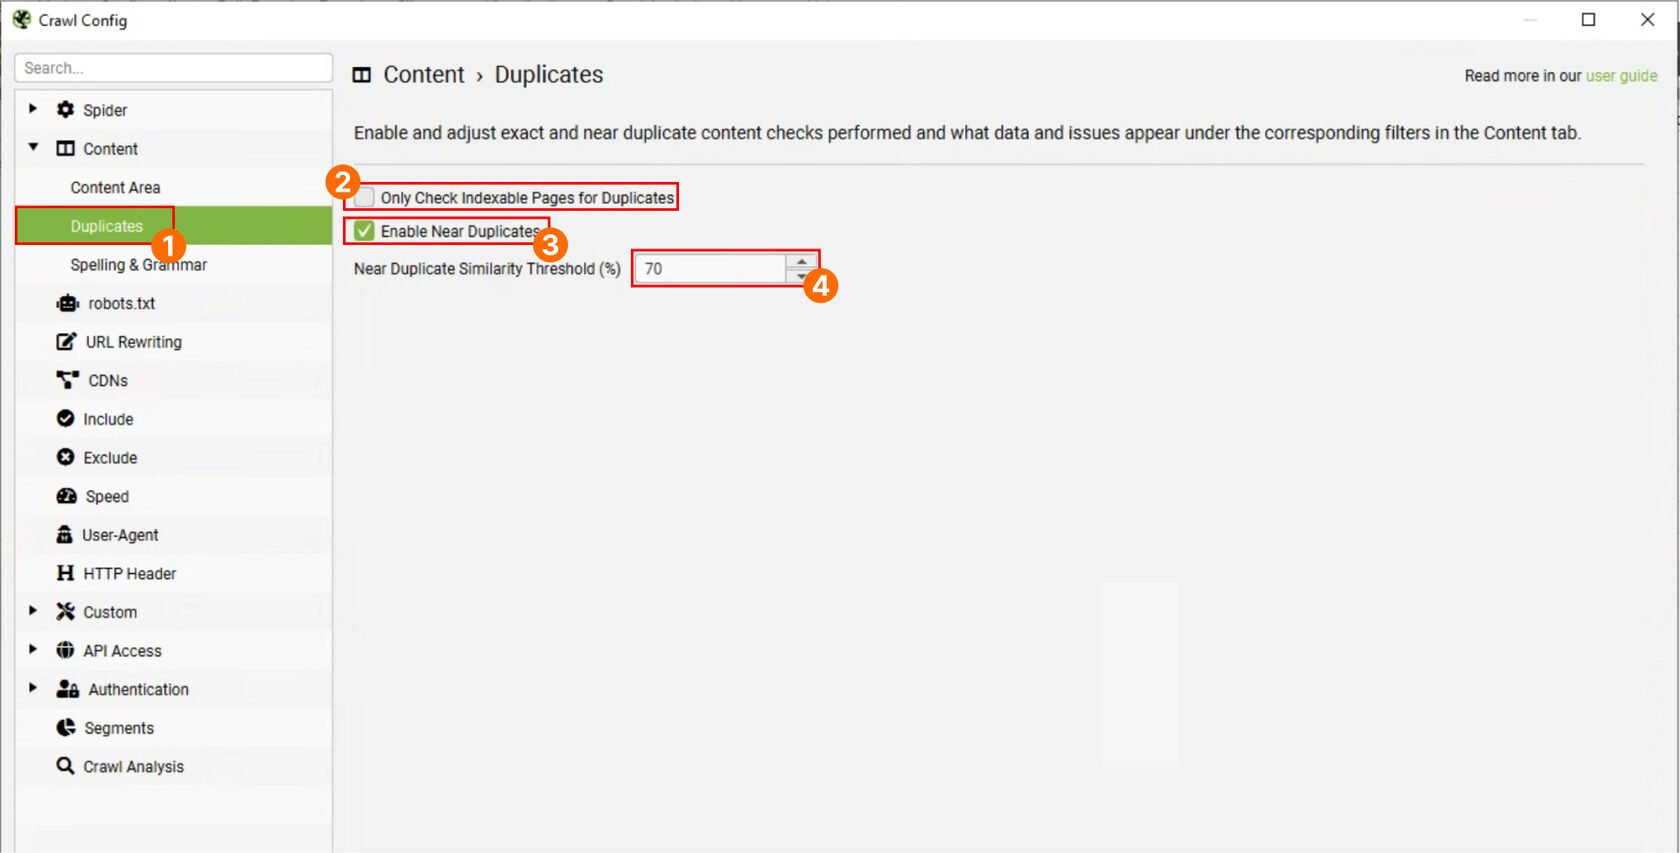
Переходим в раздел «Configuration» → «Content» → «Duplicates»;
Убираем галочку напротив «Only check indexable pages for duplicates», чтобы выявить все страницы-дубли и по возможности удалить их — так бюджет сканирования будет расходоваться правильно;
Ставим галочку «Enable Near Duplicates» — она активирует поиск неявных дубликатов;
Near duplicate similarity threshold (%) — от какого процента похожести считать страницы частичными дублями. Рекомендую ставить 70%.
Наша система сама подберет вам исполнителей на услуги, связанные с разработкой сайта или приложения, поисковой оптимизацией, контекстной рекламой, маркетингом, SMM и PR.
Заполнить заявку
13772 тендера
проведено за восемь лет работы нашего сайта.
В правом меню во вкладке Crawl Data → Content вы увидите результаты по найденным дублям. Щелкните по любой группе, чтобы детальнее изучить список всех адресов (URL), которые в нее входят, и значение схожести.
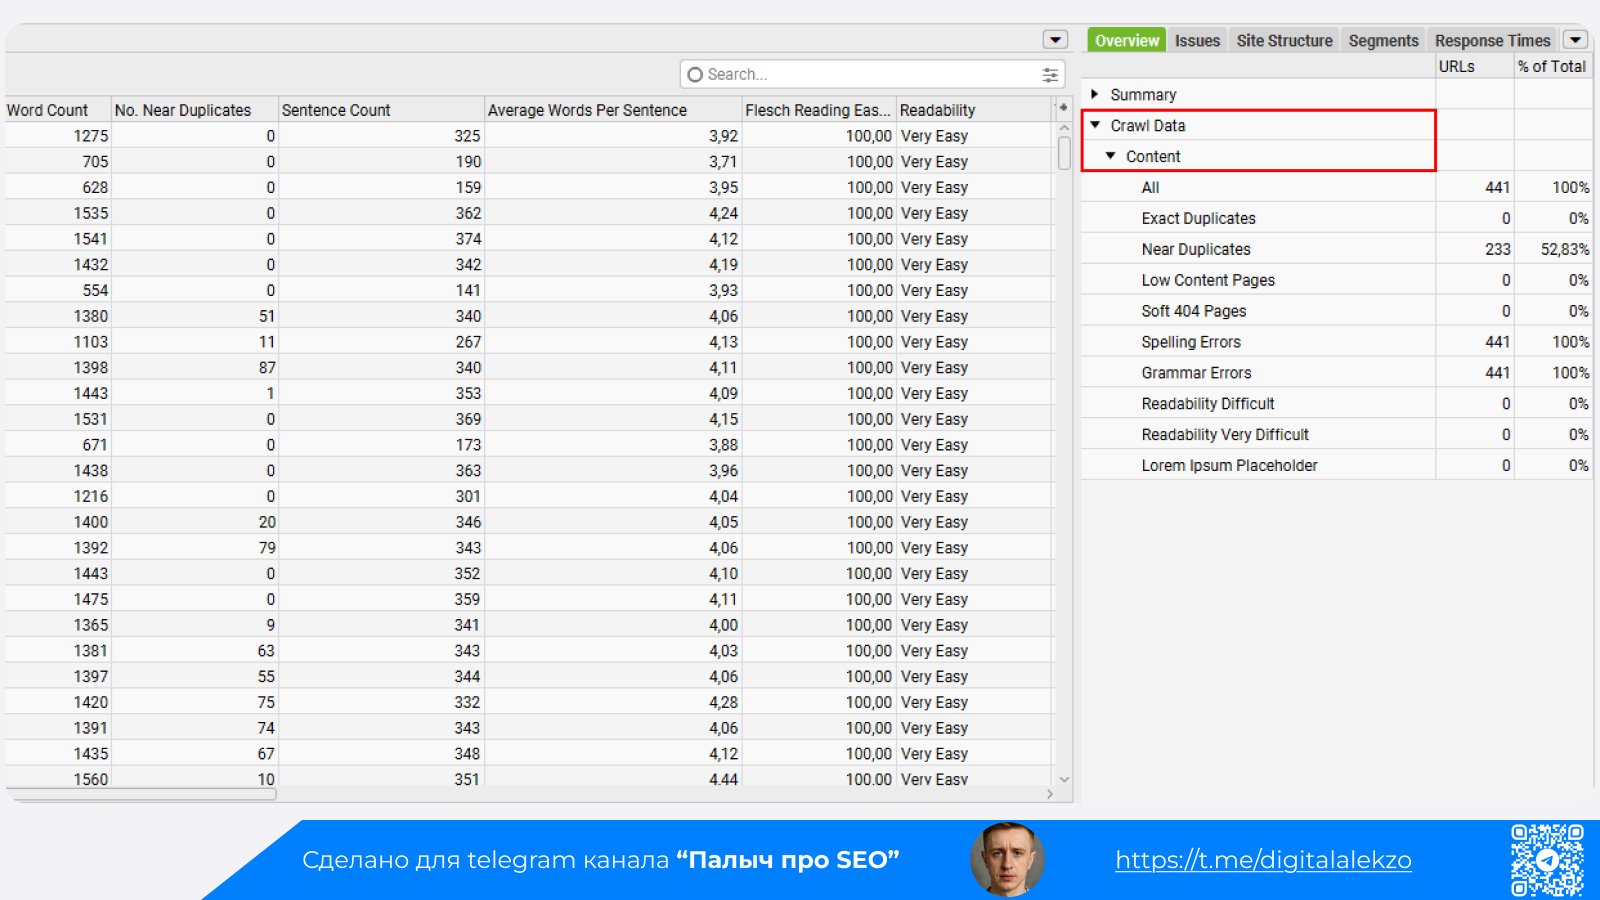
All — все значения по страницам в одной вкладке;
Exact duplicates — дубли, которые совпадают друг с другом на 100%;
Near duplicates — страницы с разными URL, которые очень сильно схожи. Их текст не идентичен, но уникального контента мало или сквозных элементов больше, чем уникального текста;
Low content pages — страницы, где меньше 200 слов (не путать с символами);
Soft 404 pages — страницы, которые отвечают кодом «200», но выглядят как страницы ошибки 404;
Spelling errors — страницы с орфографическими ошибками;
Grammar errors — страницы с грамматическими ошибками;
Readability difficult — трудночитаемый текст с длинными предложениями и сложными словами;
Readability very difficult — текст очень сложен для чтения и понимания;
Lorem ipsum placeholder — страницы с оставшимся текстом-заглушкой.
Для поиска дублей нас интересуют прежде всего вкладки «Exact duplicates» и «Near duplicates»: в них видно, какие адреса попали в одну группу и насколько они похожи.
Найдя дубли, их нужно устранить. Основные способы, которые я использую на практике:
Добавление уникального контента. Выделить ресурсы на уникальные тексты для страниц. Подходит для страниц, похожих друг на друга более чем на 75% и попавших в «Near duplicates».
Канонический тег (rel=canonical). Добавить на страницы-дубли ссылку на основную версию. Подходит для похожих страниц: карточек товара с разными сортировками, страниц пагинации.
301-редирект. Настроить постоянное перенаправление с дубля на оригинальный адрес. Подходит для зеркал (http/https, с www и без), устаревших адресов после переезда. Требует правок в .htaccess (Apache) или настройки через плагин CMS.
Запрет индексации. Использовать метатег robots или директиву в robots.txt. Подходит для служебных страниц и пагинации, если они не нужны в поиске.
Устранение причины. Унифицировать адреса (единый формат слеша), настроить корректную обработку UTM-меток на сервере — чтобы дубли не появлялись снова.
Массовая переиндексация через Google Indexing API. Когда ошибки исправлены и нужно, чтобы робот заново проверил страницы.
На практике дубли редко бывают единственной проблемой: обычно рядом находятся битые ссылки, цепочки редиректов и ошибки в мета-тегах. Поэтому поиск дублей логично встраивать в полноценный технический аудит сайта, а не проводить в отрыве от остальных проверок.
Интеграция с Google Analytics и Search Console. Можно загрузить данные о трафике и позициях, чтобы видеть, какие дублирующие страницы забирают поисковый трафик.
Анализ мета-тегов. Во вкладках Page Titles и Meta Description легко найти дублирующиеся или слишком короткие заголовки.
Парсинг XML Sitemap. Программа может проанализировать sitemap.xml и проверить адреса из него.
Поиск и устранение дублей — важный этап внутренней оптимизации сайта. Screaming Frog позволяет автоматизировать этот кропотливый процесс и получить четкий список проблем для решения. Регулярная проверка помогает улучшать видимость сайта, эффективно распределять краулинговый бюджет и защищать бизнес от потери трафика.
Источник: блог Андрея Павловича, seo-personal.ru