


 Digital Strategy
Тендеры и лиды
Информация
С появлением LLM сложность написания текстов резко упала практически до нуля, обесценивая и без того мусорный интернет. В этой связи найти что-то по-настоящему полезное стало ещё сложнее чем раньше. Вышло немного иронично: цена написания обнулилась, а стоимость поиска не выдуманного возросла.
При этом я не считаю LLM злом. Мой опыт показывает, что если использовать их как новый крутой инструмент, а не волшебную палочку, можно снизить трудозатраты, сохранив при этом смысл и релевантность.
Меня зовут Владимир Мальцев, я — практикующий SEO-специалист в Digital Strategy и занимаюсь поисковым продвижением больше 10 лет. В этой статье я подробно расскажу каким образом мне удалось автоматизировать написание однотипных юридических статей с помощью LLM и какие результаты это дало в Google.
Сайт юридической компании. Его SEO-оптимизацией я занимался больше года, и динамика в целом оставалась положительной даже с учётом AI Overviews, который забирает часть переходов, и россыпи ИИ-помощников, которые уже понемногу отъедают трафик у самого Google.
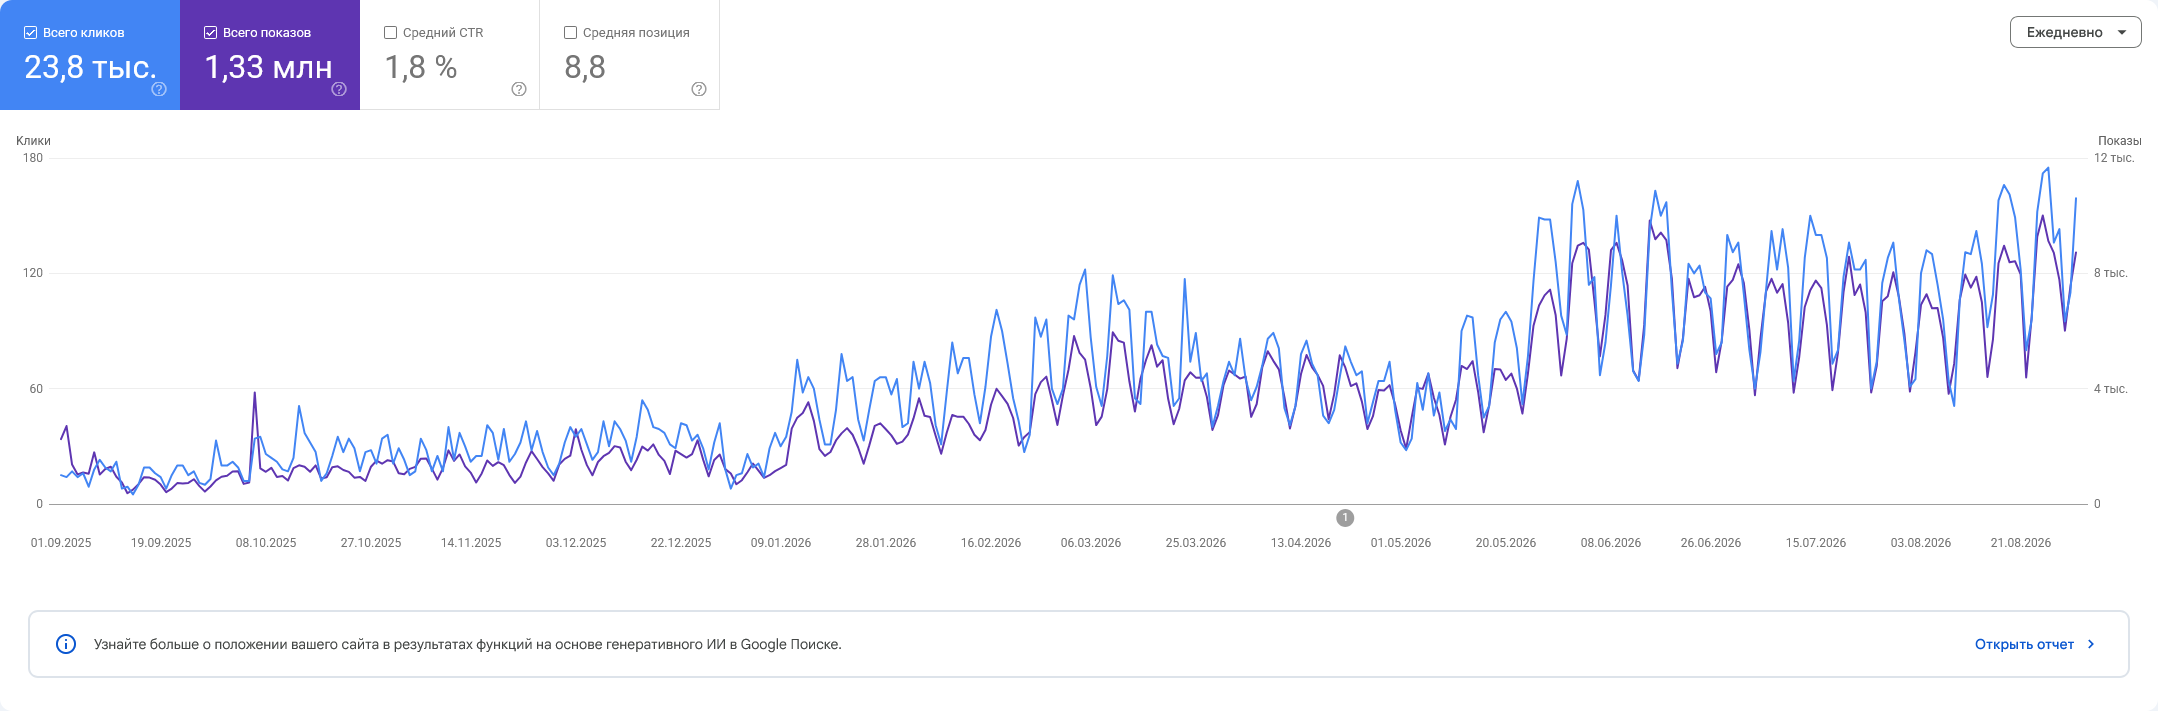
Конечно, в старые-добрые времена кликов было бы заметно больше, поскольку основная масса продвигаемых страниц находится в ТОП-5 выдачи.
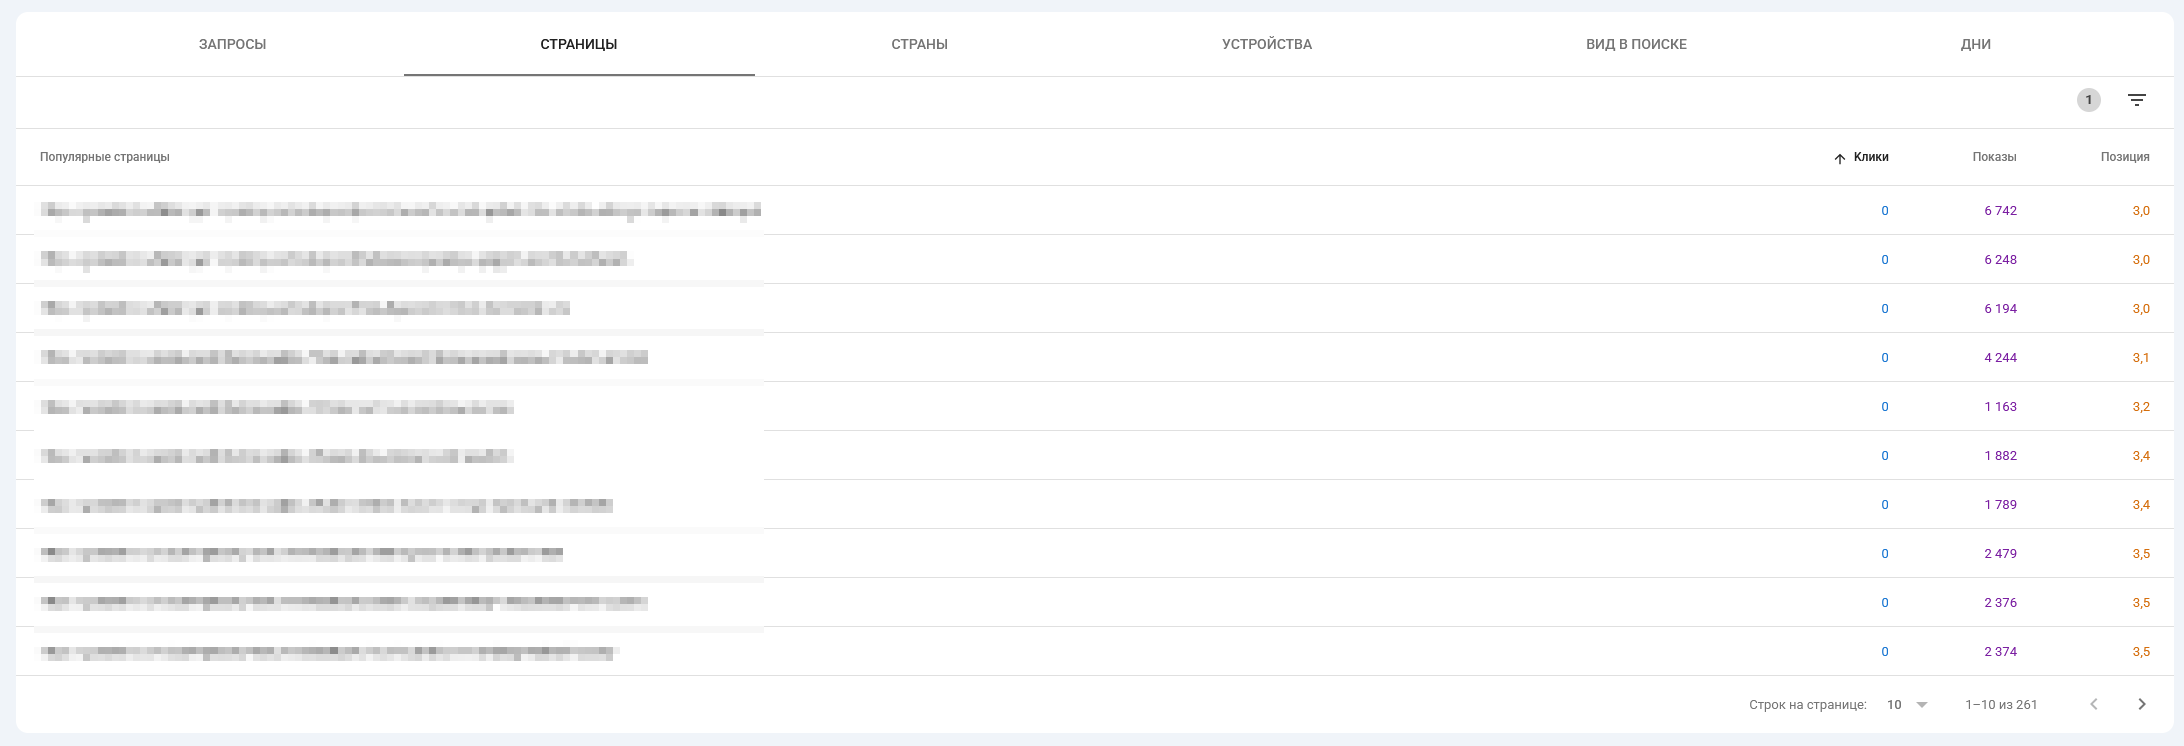
Ситуация заставила немного поднапрячь извилины. Самым очевидным решением было увеличить количество посадочных страниц для большего охвата по ключевым фразам. Но запуск контентного конвейера влечёт за собой рост издержек и падение качества. Над сайтом работал я один с привлечением копирайтера и сохранение адекватных рамок бюджета было не последним пунктом условий.
Два фактора в виде ограниченности бюджета и нежелании публиковать буквы ради букв привели к идее проведения эксперимента по генерации статей с помощью LLM в рамках отдельно созданного раздела. Главным критерием выступало сохранение контроля над результатом генерации и минимальном ручном вмешательстве для этого.
Под эту задачу я продумал и создал локальное мини приложение на Python. Опыт разработки у меня есть, но вклад LLM тут сложно недооценить. Без неё я бы, скорее всего, провозился с этим несколько месяцев.
Кластером для опыта я выбрал перечень организаций, которые напрямую связаны с проблемами клиентов владельца сайта. В этой нише распространённым явлением выступает так называемое программатик SEO. Руспрофайл является хорошей демонстрацией такого подхода: однотипные страницы, которые собираются по общей структуре из данных.
Но мне было мало просто вывести сухую информацию из реестров. Требовалось закрыть ту часть поискового спроса, которая напрямую связана с услугами сайта. То есть данные об организации являются скорее подтверждением отношения к сущности, а не всей страницей целиком.
Ещё тематика относится к концепции YMYL и отдавать написание текста LLM, зная об их галлюцинациях, было недопустимым. Нужен был подход с максимально поддающимся контролем. При этом сохраняя бонусы технологии.
Вот что получилось.
Наша система сама подберет вам исполнителей на услуги, связанные с разработкой сайта или приложения, поисковой оптимизацией, контекстной рекламой, маркетингом, SMM и PR.
Заполнить заявку
13760 тендеров
проведено за восемь лет работы нашего сайта.
Выстроенная система автоматизации представляет собой многошаговый пайплайн, в котором сначала идёт сбор данных из открытых источников, затем анализ собранной информации и только после этого написание текста.
Работает всё на FastAPI. В качестве подключаемой по API LLM использовалась OpenAI с моделями gpt-4o-mini для низкотемпературного анализа и gpt-4.1 для написания конечного текста.
Сразу оговорюсь что важной частью каждого этапа является валидация человеком. Я не отношусь к числу фанатов полностью агентного подхода к LLM, потому что при таком варианте напрочь теряется какой-либо контроль за процессом, а соответственно и результатом.
Мне ближе нейросимвольный подход: LLM подключается в конкретных местах, а её работа ограничивается логикой приложения и человеческой проверкой. В таком варианте технология остаётся именно помощником, т.е. снимает часть когнитивной нагрузки и ускоряет работу, но не принимает решения полностью самостоятельно.
В этом кейсе после каждого этапа все результаты работы LLM выводились в веб-интерфейсе. Их можно было вручную проверить, исправить или удалить перед переходом дальше. Это убирает отговорку «Я не виноват, ИИ так напридумывал», сохраняя ответственность за специалистом.
Для идентификации сущности самый простой и дешёвый источник — данные из официальных государственных реестров. Здесь я особо не заморачивался и купил дешёвую месячную подписку на руспрофайле. Написанный под него скрипт скачивает страницу организации и вытягивает весь перечень интересующей меня информации.
А вот что действительно дорого — это человеческий опыт. Благо специфика ниши породила несколько тематических форумов, где люди годами обсуждают свои реальные ситуации, задают вопросы и делятся тем, что происходило на практике.
Именно на этих данных будет основываться вся архитектура генерации: на анализе сотен сообщений от людей в контексте проблемы. Проводить такую работу вручную для каждой статьи было бы нерационально дорого. Но с LLM я имею возможность провести аналитику всего массива данных и вытащить из него то, что действительно может быть полезно человеку.
В итоге выбрав несколько наиболее крупных площадок был написан простой скрапер веток обсуждений со своими нюансами. Все ветки по одной теме собираются в JSON такого вида:
{
  "threads_count": 2,
  "total_messages": 348,
  "threads": [
    {
      "metadata": {
        "source_url": "https://forum.example.ru/threads/tema.12345/",
        "topic_title": "Название темы",
        "pages_parsed": 12,
        "total_messages": 231
      },
      "messages": [
        {
          "message_index": 1,
          "page": 1,
          "author_id": "user_nick",
          "reply_to_user": null,
          "is_first_post": true,
          "text": "Текст стартового поста..."
        },
        {
          "message_index": 2,
          "page": 1,
          "author_id": "another_user",
          "reply_to_user": "user_nick",
          "is_first_post": false,
          "text": "Ответ без процитированного фрагмента..."
        }
      ]
    }
  ]
}
Если сообщение не несёт самостоятельного смысла (например, «солидарен» или «+1» с цитатой), оно отбраковывается простыми фильтрами по длине и корням слов.
Далее собранные сообщения схлопываются в плоский массив и обрабатываются изолированно, хотя в коде выше они собираются во взаимосвязанные элементы. Причина такого расхождения — экспериментальный формат работы. Я планировал глубже разбирать обсуждения, но в процессе понял, что такими темпами закопаюсь и не дойду до результата. Поэтому не стал переделывать сбор данных, оставив улучшения на потом.
Юридические данные мы оставляем как есть, потому что они не требуют дополнительной обработки. Форумные же обсуждения требуют анализа, поэтому дальше работаем именно с ними.
Для удобства все собранные сообщения объединяются в единый плоский массив. Каждому из них присваивается уникальный ID и сохраняется исходный текст.
def flatten_messages(parse_result: dict) -> list[dict]:
    """Собирает сообщения из всех веток в один массив со сквозными ID."""
    flat, gid = [], 1
    for thread in parse_result.get("threads", []):
        for m in thread.get("messages", []):
            text = (m.get("text") or "").strip()
            if text:
                flat.append({"id": gid, "text": text})
                gid += 1
    return flat
В LLM массив такого вида уходит группами по 25 сообщений. К этому числу я пришёл опытным путём: больше — падает качество, меньше — никакого положительного эффекта. Хотя тут, наверное, всё зависит от конкретной модели:
[
  {
    "id": 1,
    "text": "Подскажите, кто сталкивался с такой ситуацией..."
  },
  {
    "id": 2,
    "text": "Было то же самое, в итоге решилось через месяц."
  },
  {
    "id": 3,
    "text": "А какие документы они запрашивали?"
  }
]
На следующем шаге идёт классификация по заранее подготовленным темам. Для каждой из них пишется свой системный промпт, и весь массив сообщений прогоняется по каждой категории отдельно. Это позволяет присвоить одному сообщению сразу несколько тем, а задачу для LLM — ограничить узким набором требований. Вот пример реализации:
CATEGORY_PROMPTS = {
    "category_a": (
        "Ты — юрист. Ищи сообщения, где описывается [процедура X]: "
        "[перечень признаков]. Фиксируй только то, что относится к [предмету], "
        "не путай с [похожей, но другой ситуацией]."
    ),
    "category_b": (
        "Ты — финансовый консультант. Ищи только сообщения, где прямо говорится "
        "о [условиях Y]. Если сообщение просто про [смежную тему] без [ключевого "
        "признака] — игнорируй."
    ),
    "questions": (
        "Ты — модератор форума. Выделяй из текста конкретные вопросы пользователей. "
        "Не включай вопросы уровня «кто сталкивался?», если уже есть более конкретные."
    ),
    # ...
}
При этом ожидаемый ответ строго типизирован форматом JSON, благо настройки API позволяют это сделать:
# Передаваемая JSON-схема
def build_classification_schema(category: str) -> dict:
    return {
        "name": f"classification_{category}",
        "strict": True,
        "schema": {
            "type": "object",
            "properties": {
                "ids": {"type": "array", "items": {"type": "integer"}}
            },
            "required": ["ids"],
            "additionalProperties": False,
        },
    }

# Запрос к LLM
resp = client.chat.completions.create(
    model=MODEL,
    temperature=0,
    messages=[
        {"role": "system", "content": system_prompt},
        {"role": "user", "content": json.dumps(chunk, ensure_ascii=False)},
    ],
    response_format={
        "type": "json_schema",
        "json_schema": build_classification_schema(category),
    },
)
ids = json.loads(resp.choices[0].message.content)["ids"]
Результатом всего этапа становится разбитый по категориям массив сообщений:
{
  "category_a": [
    {"id": 3, "text": "..."},
    {"id": 12, "text": "..."}
  ],
  "category_b": [
    {"id": 7, "text": "..."}
  ],
  "questions": [
    {"id": 3, "text": "..."},
    {"id": 19, "text": "..."}
  ]
}
После первичной классификации начинается следующий этап обработки. Теперь сами сообщения становятся источником правды для извлечения и подсчёта типизированных фактов, которые лягут в основу будущей статьи.
Каждая категория проверяется на свой набор признаков. В LLM снова уходят пачки сообщений, чтобы модель определила их принадлежность к тому или иному факту. При этом количество сообщений в одном запросе мы снижаем до 10: ожидаемый ответ теперь сложнее, а данных вокруг каждого объекта — больше.
Упрощённый пример для категории:
DEEP_CONFIG = {
    "category_a": {
        "title": "Название категории",
        "fields": {
            "entity_names": "str_array",
            "event_announced": "bool",
            "event_happened": "bool",
            "months_until_event": "int_or_null",
            "region": "str_or_null",
        },
        "descriptions": {
            "entity_names": (
                "массив строк — названия организаций, которые упоминаются в роли [X]. "
                "Если не указаны — []."
            ),
            "event_announced": "1, если о [событии] заявляли или предупреждали, иначе 0.",
            "event_happened": "1, если прямо сказано, что [событие] произошло, иначе 0.",
            "months_until_event": (
                "число или null — через сколько месяцев произошло [событие]. "
                "Если срок не указан — null."
            ),
            "region": "строка или null — город или регион, если указан, иначе null.",
        },
    },
    # ...остальные категории
}
Чтобы получать правильный контекст, типы фактов я разделил на четыре вида:
Булевы признаки фиксируют, есть факт или нет. Они кодируются как 0/1, чтобы потом результаты можно было просто суммировать.
Массивы строк нужны для сущностей вроде названий организаций.
Числа и строки с допуском null описывают значения, которых в сообщении может вообще не быть. Разница между null и нулём здесь принципиальна: «срок не указан» и «ноль месяцев» — это совершенно разные вещи.
Разделение событий для случаев, когда о чем-то пишут до того, как это произошло. Под них заведены два отдельных поля («заявлено» и «произошло»), чтобы обещание не засчитывалось как свершившийся факт.
Одна и та же конфигурация используется сразу в двух местах: описания уходят в системный промпт, а типы формируют JSON-схему ожидаемого ответа:
def build_deep_schema(category: str) -> dict:
    props = {"id": {"type": "integer"}}
    for key, ftype in DEEP_CONFIG[category]["fields"].items():
        if ftype == "bool":
            props[key] = {"type": "integer", "enum": [0, 1]}
        elif ftype == "str_array":
            props[key] = {"type": "array", "items": {"type": "string"}}
        elif ftype == "int_or_null":
            props[key] = {"type": ["number", "null"]}
        elif ftype == "str_or_null":
            props[key] = {"type": ["string", "null"]}

    item = {
        "type": "object",
        "properties": props,
        "required": list(props.keys()),
        "additionalProperties": False,
    }
    # дальше item заворачивается в {"results": [item, ...]} со strict=True,
    # так же, как схема на этапе 2
    ...
Ответы по всем пачкам одной категории сводятся в итоговый объект. Булевы признаки суммируются для получения количества сообщений, в которых подтверждён конкретный факт. Списки строк объединяются без дублей. Числа и строки, наоборот, собираются со всеми повторами: это позволяет оценить, например, типичный срок или географию.
Построчные ответы модели тоже сохраняются. Благодаря этому любую цифру в итоговой сводке можно проследить до конкретного сообщения по его ID.
Итог по одной категории выглядит примерно так:
{
  "title": "Название категории",
  "message_count": 40,
  "signals": {
    "event_announced": 15,
    "event_happened": 6
  },
  "extracted": {
    "entity_names": [
      "Организация А",
      "Организация Б",
      "Организация В"
    ],
    "months_until_event": [
      3,
      4,
      4,
      6
    ],
    "region": [
      "Казань",
      "Москва",
      "Ростов"
    ]
  },
  "rows": [
    {
      "id": 42,
      "entity_names": [
        "Организация А"
      ],
      "event_announced": 1,
      "event_happened": 1,
      "months_until_event": 4,
      "region": "Казань"
    },
    {
      "id": 57,
      "entity_names": [],
      "event_announced": 1,
      "event_happened": 0,
      "months_until_event": null,
      "region": null
    }
  ]
}
Этот этап — по сути, отдельная подсистема внутри пайплайна. Все ранее собранные данные используются по принципу RAG: LLM генерирует текст на их основе, а не вытаскивает факты из собственных внутренних знаний.
Но тут возникает другая проблема. Даже если исходные данные уникальны, один и тот же промпт довольно быстро начинает штамповать похожие друг на друга статьи. В масштабах одного сайта это грозит потерей уникальности и проблемами с индексацией.
Покопавшись немного в гуманитарных науках и свежих работах коллег по цеху, я наткнулся на понятие семантической асимметрии. Прогнал несколько тестов и понял что подход отлично решает задачу, позволяя развести статьи внутри одной тематики. Ниже покажу, как именно это работает.
Автономные блоки статьи
Собрав и обработав большой объём ключевых фраз, я увидел чёткую закономерность: внутри каждого кластера люди формулируют запросы по схожему сценарию, независимо от конкретной организации. Поэтому я решил отказаться от динамической структуры и использовать заранее составленные блоки с понятной логикой раскрытия.
Это позволило не заморачиваться с оценкой структуры каждой статьи, а сфокусироваться на проработке самого текста. Всего вышло 9 блоков: от вступления и оценки юридической активности до отзывов и ответов на частые вопросы. Каждый блок — это отдельный модуль со своими промптами, вариантами подачи и собственным срезом данных.
Чтобы при генерации текста блоки не повторяли друг друга, для каждого из них я прописал подробный промпт со списком запрещённых тем. То есть, если какой-то факт уже раскрыт во вступлении, следующий блок к нему больше не возвращается.
Ограничение данных под каждый блок
Чтобы сохранить фокус LLM на узком контексте блока, в промпт передаются не все собранные данные, а только та часть, которая необходима для раскрытия конкретного вопроса.
Собственно, ради этого и был нужен третий этап. Чтобы снизить «размытие» контекста, вместо построчной загрузки сырых сообщений модель получает отфильтрованные, статистически значимые данные: счётчики сигналов по категориям, извлечённые значения и общее число сообщений.
Вот пример функции, которая отбирает нужные категории для конкретного блока:
def build_reviews_input(deep_result: dict, legal_activity_text: str) -> dict:
    cats = deep_result.get("categories", {})
    return {
        "entity_name": (deep_result.get("entity_name") or "").strip(),
        "legal_activity_data": legal_activity_text,  # внешние данные о судебной активности
        "analysis": {
            "category_a": compact_category(cats.get("category_a", {})),
            "category_b": compact_category(cats.get("category_b", {})),
            "category_c": compact_category(cats.get("category_c", {})),
            # category_d — здесь не участвует
        },
    }
Если каких-то данных не хватает (например, не спарсился ИНН), модели прямо запрещено выдумывать факты. Вместо этого она вставляет в текст заглушки вида [ИНН не указан].
Это позволяет на финальном этапе валидации легко найти такие места, заполнить их вручную и полностью исключить риск фактических ошибок.
Семантическая асимметрия
Это интересный способ добиться уникальности текстов внутри одной тематики. Для каждого блока я составил до 8 вариантов подачи, а конкретный из них выбирается по MD5-хешу названия статьи. За счёт этого при перегенерации текста подача не скачет случайным образом, а жёстко привязывается к конкретной странице.
Каждый вариант представляет собой небольшое ТЗ из пяти частей:
Семантический угол: с какой стороны заходить в тему.
Архетип читателя: кто читает текст и что его волнует.
Структура аргументации: определяет логику и риторику конкретного блока.
Формат текста: количество абзацев, использование списков, таблиц и т. д.
Акцент на данных: на какие входные факты из анализа нужно сделать упор.
Ниже — упрощённый пример одного из таких вариантов и функция выбора:
BLOCK_VARIANTS = [
    # ─── 3 ─ Логика рынка | Скептик ───
    """СЕМАНТИЧЕСКИЙ УГОЛ: бизнес-логика [рынка] — почему участники поступают именно так и что это меняет для читателя.
АРХЕТИП ЧИТАТЕЛЯ: скептик, который хочет понять систему, а не получить успокоение.
СТРУКТУРА АРГУМЕНТАЦИИ (следуй логике, но не называй шаги в тексте явно):
  1. Тезис: [участникам] выгоднее [действие], чем [альтернатива].
  2. Контртезис: для читателя это выглядит как [ухудшение], хотя экономически [другое].
  3. Ограничение: без документов читателю эту картину не увидеть.
  4. Вывод: [конкретное действие] — единственный способ понять реальную ситуацию.
ФОРМАТ: 3 абзаца. Перечисление — в строчку внутри второго абзаца. Тон аналитический.
АКЦЕНТ: логика рынка как инструмент понимания, а не повод для тревоги.""",
    # ...ещё 6 вариантов
]


def get_asymmetry_variant(seed_string: str, variants: list[str]) -> str:
    safe_seed = (seed_string or "default").lower().strip()
    hash_int = int(hashlib.md5(safe_seed.encode("utf-8")).hexdigest(), 16)
    return variants[hash_int % len(variants)]
Сквозные авторские термины
Дополнительный слой уникализации. Вместе с генерацией вводного абзаца LLM получает параллельную задачу: придумать уникальный авторский термин под выбранный семантический угол текста. Обычно это два-четыре слова, которые описывают механику ситуации или состояние читателя (за саму идею спасибо DrMax и его книге «Доказательное SEO 2026»).
Дальше этот термин проходит сквозняком через всю статью. В одних блоках он вписывается обязательно, в других — решение о его добавлении принимается рандомно, чтобы термин не превратился в навязчивый повтор.
Юридическая безопасность и программные проверки
Так как мы работаем с реальными компаниями и человеческими эмоциональными сообщениями с форумов, риски претензий по поводу деловой репутации становятся не нулевыми. Чтобы избежать проблем, защиту была выстроена в три слоя.
Первый слой — правила в промптах. Почти в каждом блоке есть одинаковая инструкция: прямые обвинения в адрес компании запрещены. Риски описываются обтекаемо, через дискомфорт читателя и возможные последствия.
Второй слой — атрибуция. Негатив с форумов подаётся только как сообщения пользователей («по данным форумов», «в отзывах встречается»), а не как установленный факт.
Третий слой — проверки кодом после генерации. Промпты снижают частоту ошибок, но не исключают их полностью, поэтому каждый блок дополнительно прогоняется через строгие заскриптованные проверки:
на прямые обвинения (ищем по стоп-листу корней);
на наличие сухой справки из реестра вместо её интерпретации;
на клишированные юридические фразы.
Если сработала хоть одна проверка, текст отправляется на перегенерацию с конкретными замечаниями.
Вот пример такой проверки:
RISKY_LABELS = ["мошенник", "мошеннич", "аферист", "обманщик", "преступн", "криминал", ...]

risky       = [w for w in RISKY_LABELS if w in text.lower()]
dry_card    = looks_like_dry_registry_card(text)  # несколько маркеров реквизитов
cliche = looks_like_cliche(text)        # несколько клишированных фраз

if risky or dry_card or cliche:
    remarks = []
    if risky:
        remarks.append(f"Убери прямые обвинения ({', '.join(sorted(set(risky)))}). "
                       "Негатив подавай только как субъективные отзывы пользователей.")
    if dry_card:
        remarks.append("Текст похож на сухую справку из реестра. Оставь значимые факты и объясни, "
                       "что они означают для читателя и чего не доказывают.")
    if cliche:
        remarks.append("Текст использует клишированные фразы. Убери общие объяснения.")

    fix_prompt = (
        "Перепиши блок с учётом замечаний. Сохрани структуру аргументации:\n"
        f"{selected_variant}\n\nЗамечания:\n"
        + "\n".join(f"- {r}" for r in remarks)
        + f"\n\nТекущий текст:\n{text}"
    )
    raw = generate_json_response(system_prompt, fix_prompt, ORG_RESPONSE_SCHEMA, temperature=0.25)
    text = json.loads(raw)["org_text"] or text
Многошаговое исполнение блока
Базовый принцип прост: отдельно работаем с фактами, отдельно — со стилем. Поэтому каждый блок, в зависимости от объёма и сложности, проходит от 1 до 4 запросов к LLM.
Сначала модель в роли аналитика на низкой температуре собирает черновик строго по структуре выбранного варианта. Главная задача здесь — аккуратно перенести статистику в текст без потерь.
После этого LLM переключается в роль главного редактора и на повышенной температуре адаптирует текст под нужную подачу: учитывает архетип читателя, проверяет юридическую безопасность, вписывает сквозные термины. Исходные данные на этом этапе модели вообще не передаются — она работает только с черновиком. Всё это нужно для сужения контекста задачи и минимизации отклонений.
И вот после всех манипуляций мы, наконец, получаем готовую статью. Дальше она отправляется копирайтеру на ручную проверку. На этом этапе человек ещё раз проходится по фактам и грамматике, правит стилистику и в целом причёсывает текст перед публикацией.
У этого этапа оказался отличный побочный эффект. На первых итерациях мне регулярно прилетали замечания: тут пишет странно, там вставляет не то, а вот здесь вообще выдумывает факты. После каждого такого фидбека я вносил корректировки в систему — докручивал промпты, логику и фильтры.
В результате в последних партиях правок почти не было: мы смогли довести пайплайн генерации до нужного качества.
Опасаясь резкой реакции Google на сгенерированный текст, я решил не заваливать сайт сразу и публиковал не больше одной статьи в несколько дней. В итоге за время эксперимента (с апреля по август) мы добавили 90 новых посадочных страниц.
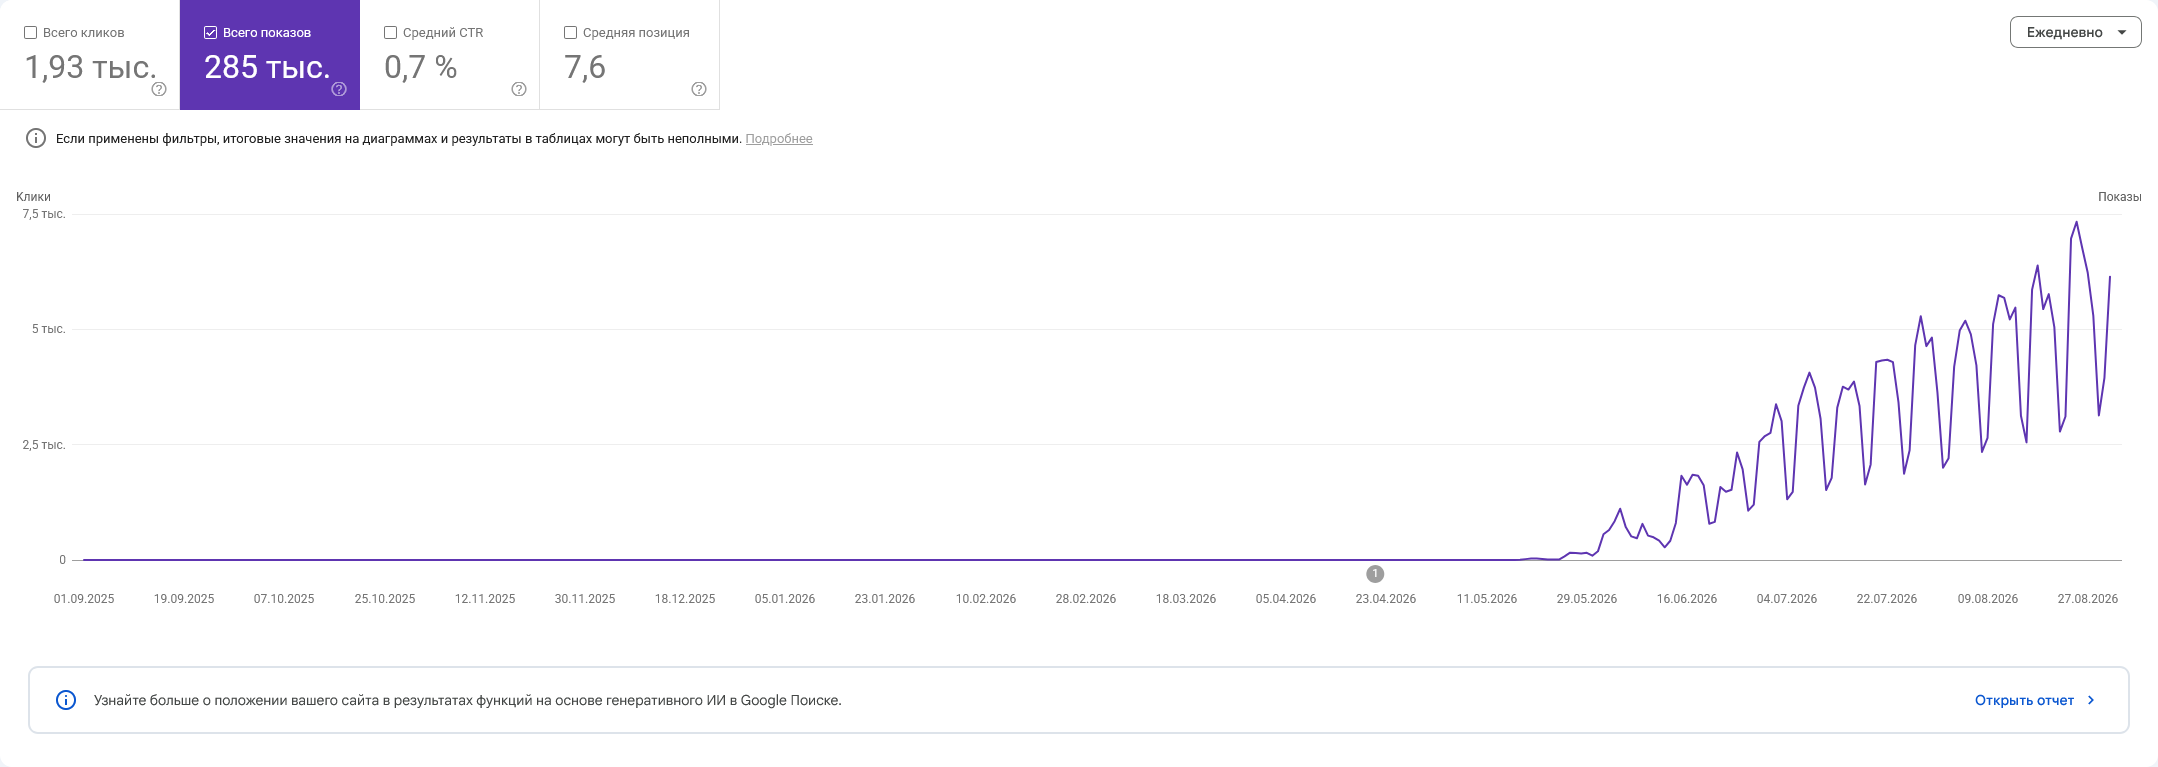
Как видно по графику из Search Console, Google такие статьи нравятся. Примерно с середины мая он начал подхватывать первые страницы, и дальше объём видимости только рос.
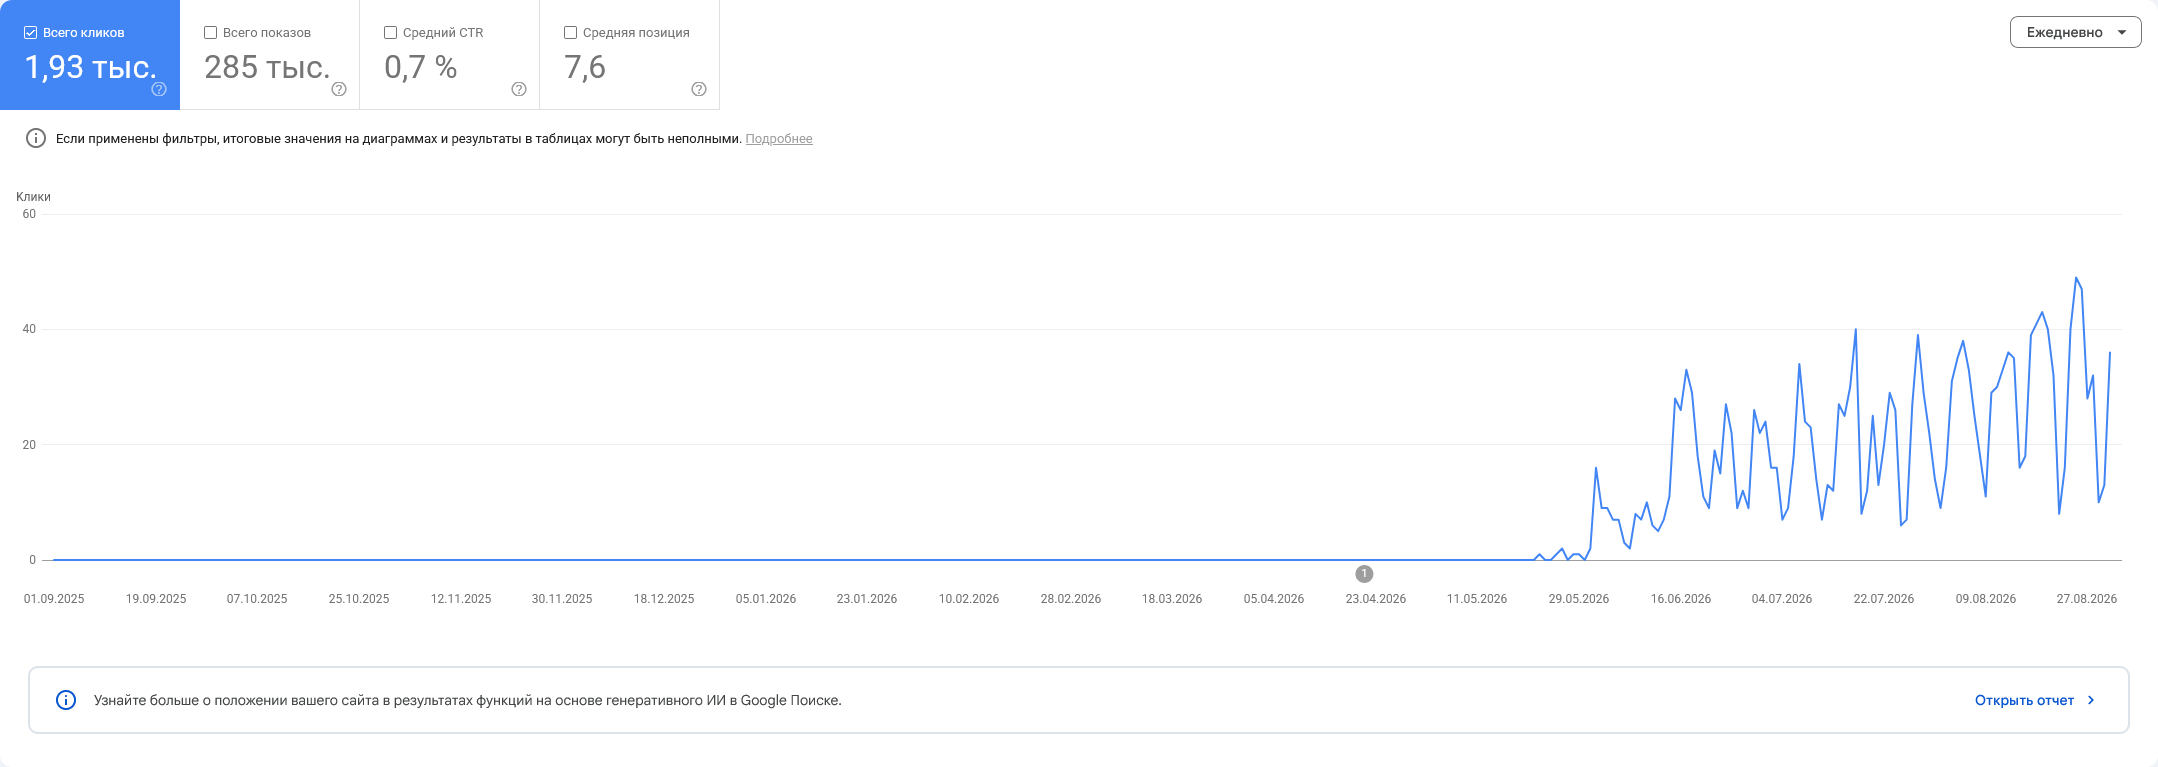
Переходы на сайт тоже растут, хотя график здесь уже не такой красивый. CTR пока ниже среднего по сайту, но это логично: каждый месяц появляются новые посадочные страницы, число показов стремительно растёт, и соотношение кликов к показам размывается.
Вот ещё несколько скриншотов по отдельным страницам. Они доказывают: попав в ранжирование, страницы не выпадают из выдачи через пару недель, а стабильно сохраняют охваты.
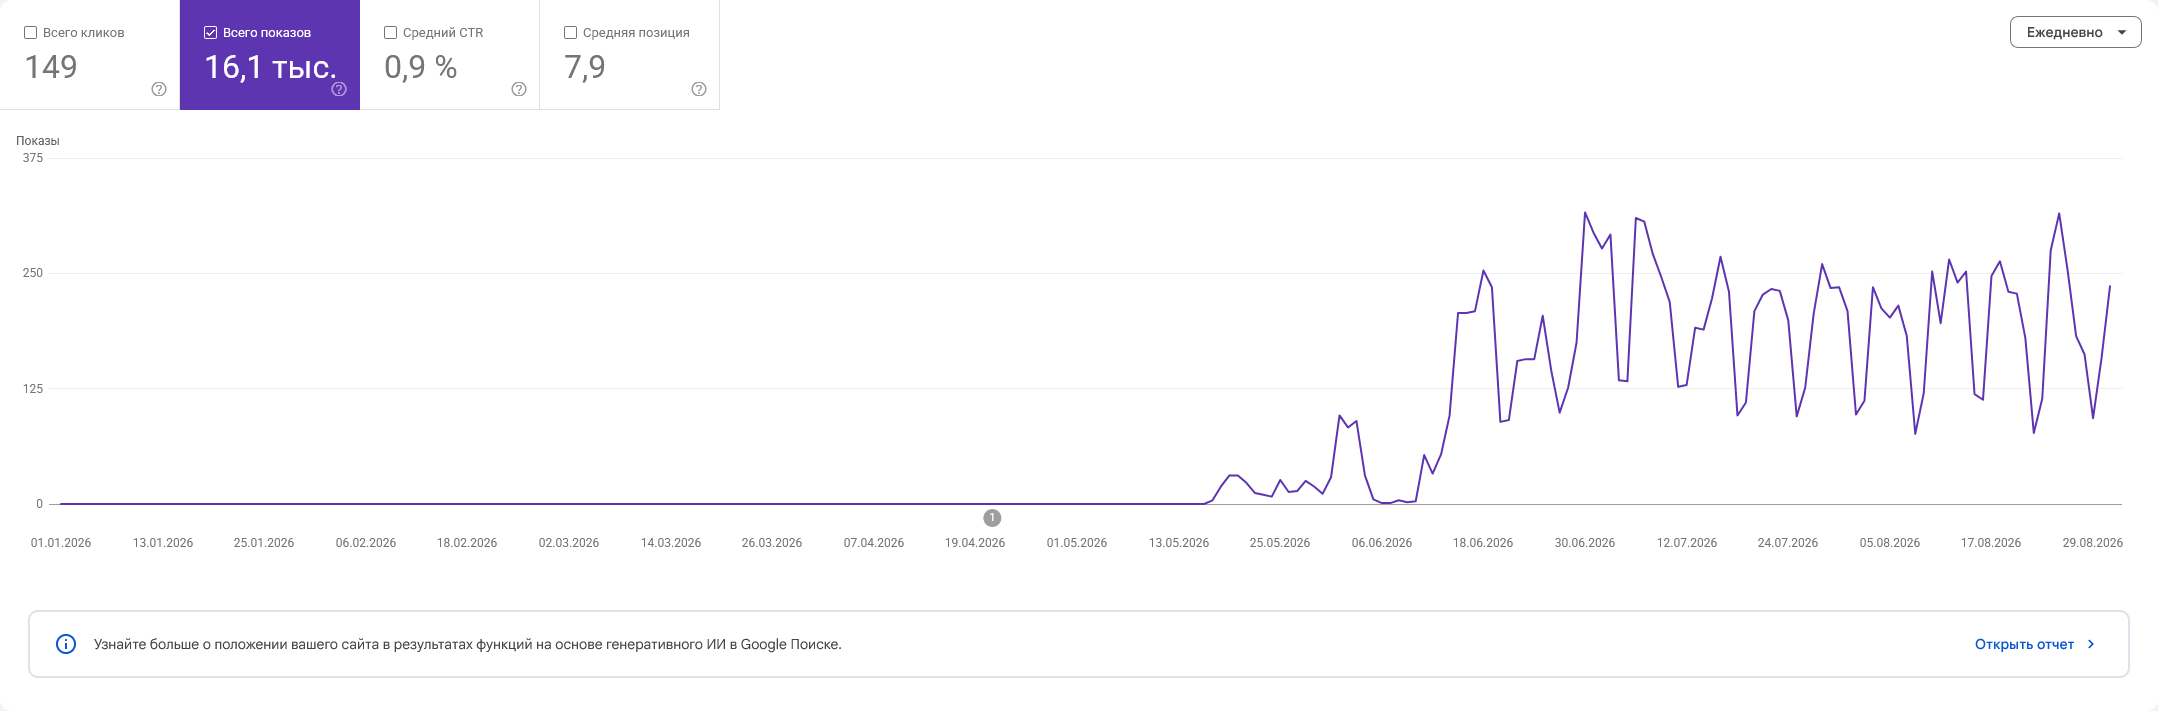
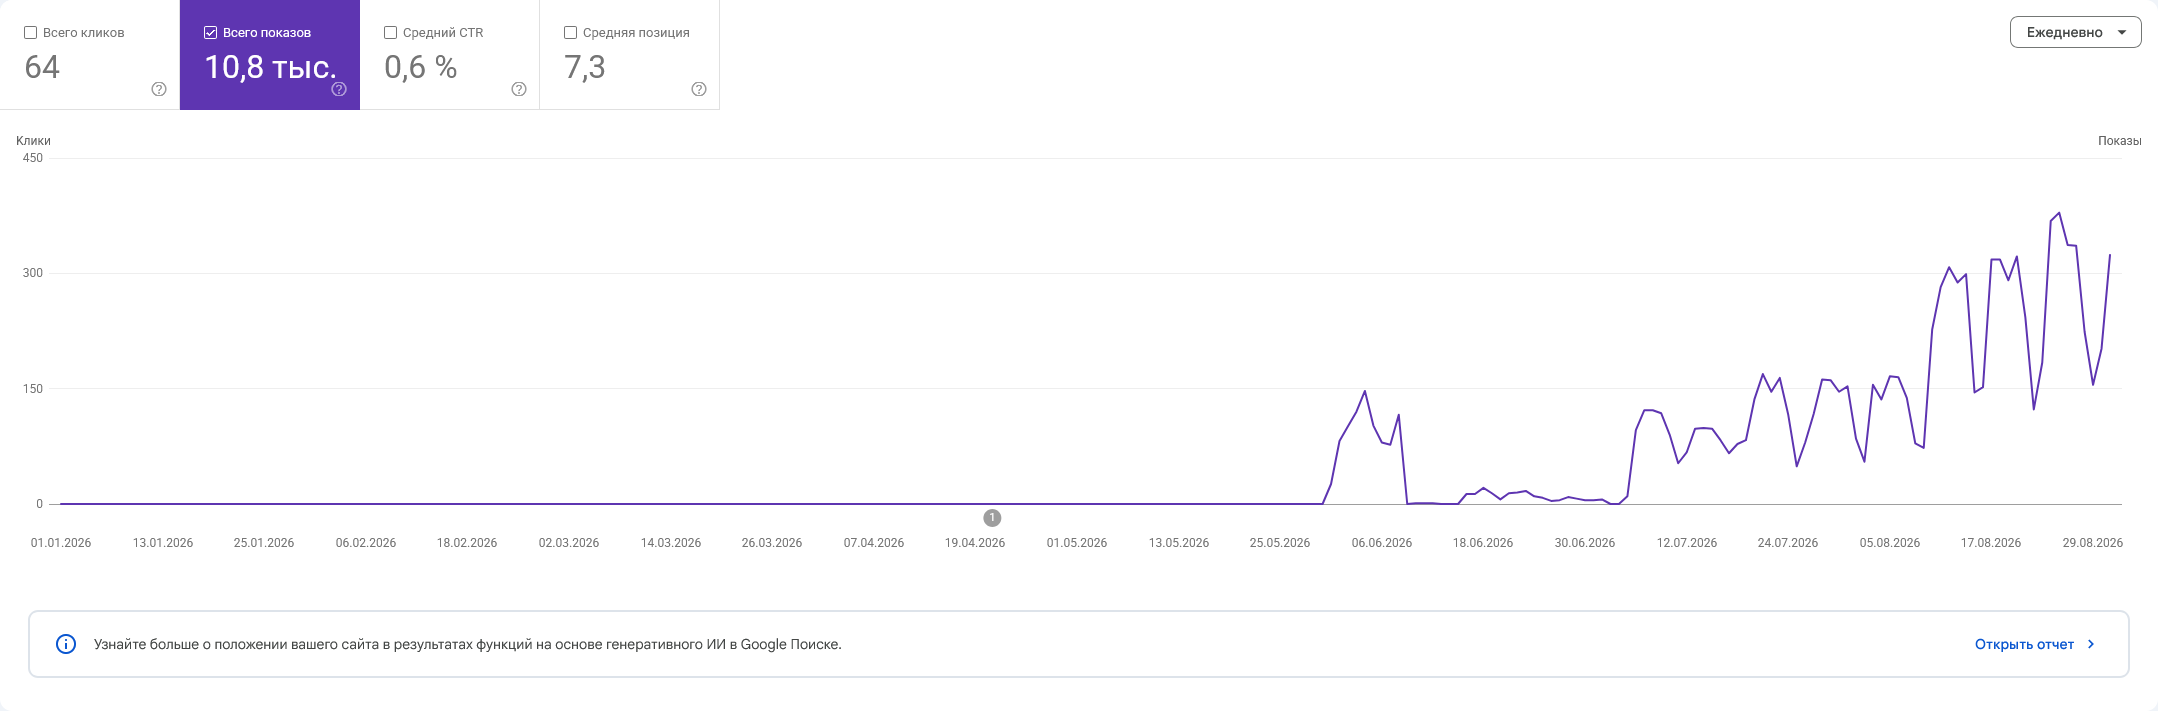
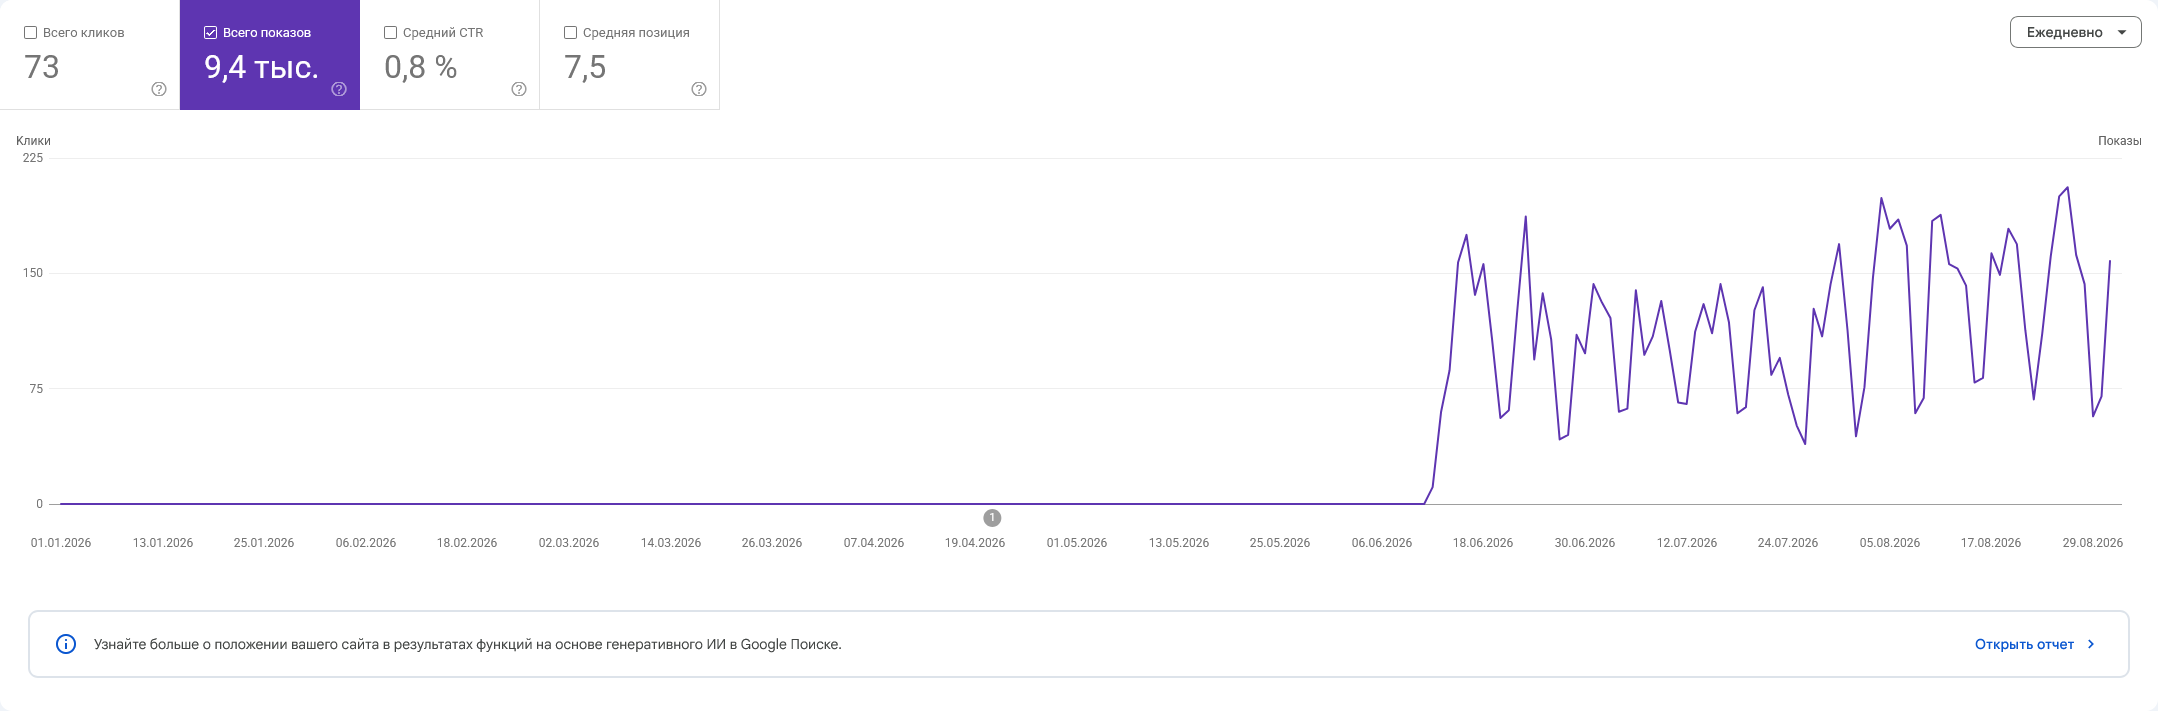
И ещё один важный момент, который хочется подсветить: за время эксперимента Google успел выкатить несколько обновлений — один Core Update и два Spam Update. На фоне этого раздел не просел, а продолжил спокойно наращивать присутствие в выдаче.
Для меня главный вывод прост: подобный подход к автоматизации вполне работает. Я уже начал внедрять аналогичную архитектуру на других проектах, и там тоже вижу положительную динамику.
И это именно то использование LLM, которое я считаю правильным. Технология компенсировала мои слабые знания программирования и позволила в сжатые сроки собрать MVP, показавший реальную эффективность.
Для себя я выделил несколько главных принципов:
Контроль и ответственность остаются за мной. Я решаю, какой будет структура, что именно попадёт в текст и под каким углом будет раскрываться тема.
Экспертиза вшивается в пайплайн. LLM не принимает решений за меня, а делает только то, что умеет хорошо: классифицирует, извлекает и пишет. При этом всё, что можно посчитать кодом, — считается кодом.
Я не заменяю ни себя, ни копирайтера. Задача в другом — в разы повысить эффективность труда без потери качества.
Я прекрасно понимаю, что текущая архитектура имеет множество огрехов. В ней хватает костылей и мест, которые хочется переделать. Но задача была экспериментальной: нужно было доказать саму гипотезу — можно ли с помощью LLM массово создавать полезные страницы и получать с них поисковый трафик. Гипотеза подтвердилась, поэтому развиваться точно есть куда.