


 ИНДЕВИУМ
Тендеры и лиды
Информация
Что делать при недоступности серверов, как восстановить данные, найти свободные мощности, выбрать провайдера и развернуть инфраструктуру.
Недоступность сервера не всегда означает потерю данных. И наоборот: запущенная на новой площадке виртуальная машина еще не означает, что бизнес-система восстановлена. Между этими событиями находятся базы данных, пользовательские файлы, конфигурация, сетевые зависимости, фоновые задачи и проверка корректности работы.
Это руководство помогает выбрать порядок действий: выяснить масштаб проблемы, сохранить доступное состояние, оценить варианты восстановления, подобрать ресурсы и подготовить новую инфраструктуру к работе. Материал рассчитан на технических руководителей, системных администраторов и владельцев продуктов, которым важно понимать не только команды, но и риски решений.
О назначении материала и ограничениях
Статья носит информационно-справочный характер. Названия облачных провайдеров приведены для независимого сравнения способов проверки ресурсов, а не для продвижения их услуг. Доступность мощностей, тарифы, квоты и условия размещения необходимо проверять непосредственно перед заказом.
Примеры команд предназначены для специалистов, которые понимают конфигурацию своей системы. Перед применением каждую команду необходимо проверить, адаптировать к версии ОС, сетевой схеме, политике безопасности и состоянию данных. Они не являются универсальной, окончательной или гарантированно безопасной инструкцией для любого production-окружения. Ошибочная операция может привести к потере доступа, данных или работоспособности сервиса. Юридическая информация не заменяет индивидуальную правовую оценку.
Первое правило восстановления
Если у вас осталась единственная доступная копия данных, не перезаписывайте ее, не пересоздавайте диск и не запускайте восстановление поверх нее. Сначала зафиксируйте состояние и подготовьте независимую копию, если это технически возможно.
Быстрый маршрут: ответьте на три вопроса.
Где находятся данные? Доступен исходный сервер, резервная копия, реплика или только исходный код?
Какой тип системы требуется восстановить? Обычный веб-сервис, распределенный кластер или вычислительная среда с GPU?
Где ее можно запустить? Подтверждены ли ресурсы нужной конфигурации в конкретном регионе и пуле, а также возможность их выделить именно вашему аккаунту?
Если хотя бы на один вопрос нет ответа, не начинайте массовый перенос. Сначала закройте соответствующий риск.
В первые минуты важно отделить сбой интерфейса управления от недоступности самой инфраструктуры. Ошибка в панели провайдера, обрыв SSH, неработающий DNS и повреждение базы данных требуют разных действий. Попытка лечить их одним перезапуском может ухудшить ситуацию.
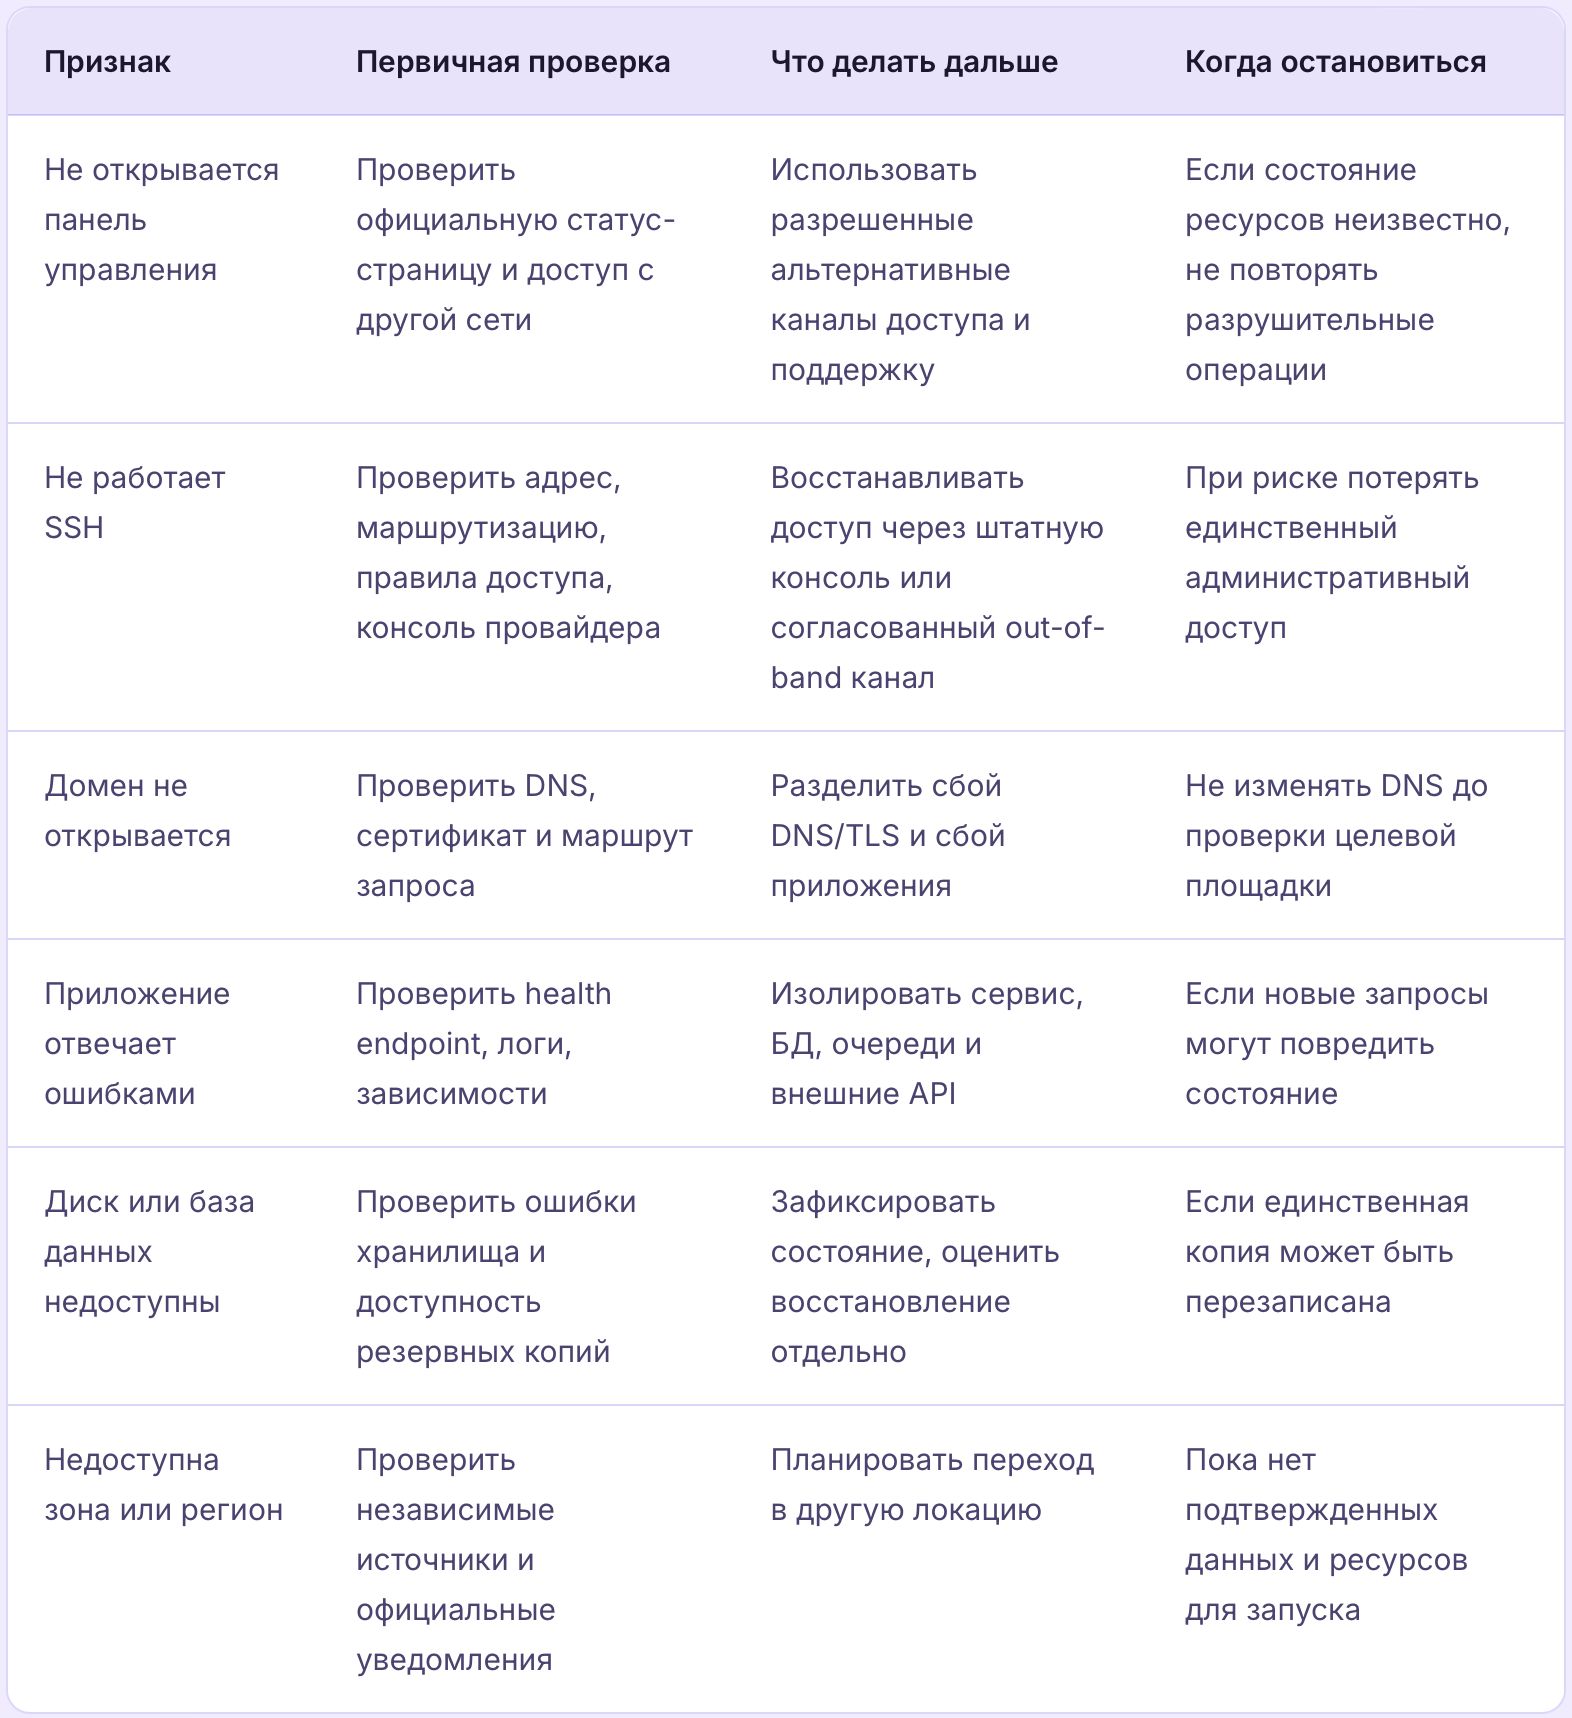
Не начинайте диагностику с изменения конфигурации. Сначала зафиксируйте время обнаружения проблемы, последние успешные операции, последние изменения и список затронутых сервисов. Эти сведения помогут и вашей команде, и поддержке провайдера.
Составьте карту зависимостей. Например, интернет-магазин может зависеть от базы заказов, платежного шлюза, очереди уведомлений, объектного хранилища и DNS. Восстановление только веб-интерфейса не возвращает возможность оформлять заказы.
RTO (Recovery Time Objective) - целевое время восстановления сервиса. RPO (Recovery Point Objective) - максимально допустимый возраст восстановленных данных. Если последняя рабочая копия сделана шесть часов назад, нельзя обещать RPO в несколько минут без других источников изменений.
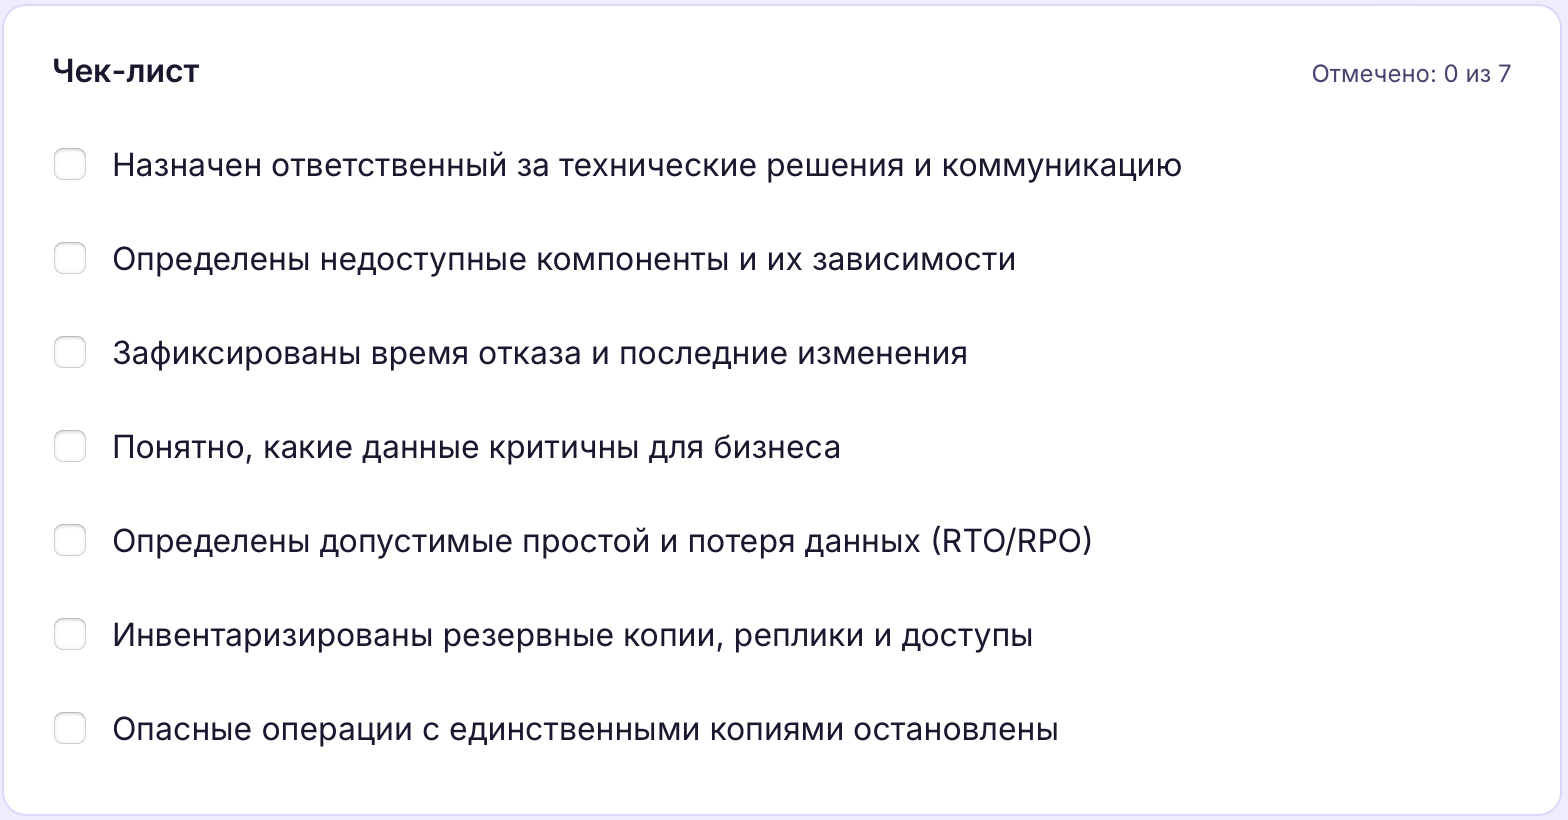
Результат этапа: не общее заключение о том, что сервер не работает, а список затронутых систем, приоритетов и известных источников данных.
Нужно различать восстановление сервиса и восстановление данных. Приложение часто можно заново собрать из репозитория и контейнерных образов. Заказы, транзакции, пользовательские файлы и уникальные записи восстановить так нельзя.
Это наиболее управляемый маршрут. Сначала установите, какие данные меняются в реальном времени, затем подготовьте согласованный экспорт. Для баз данных недостаточно скопировать произвольный файл работающего хранилища: способ резервирования должен поддерживаться конкретной СУБД.
Проверьте наличие и согласованность четырех групп материалов: состояние БД, файлы и объекты пользователей, конфигурация инфраструктуры, секреты и ключи. Последние необходимо передавать по защищенному каналу, а не вкладывать в обычный архив с проектом.
После создания копии проверьте, что архив читается, а восстановление возможно в изолированной среде. Успешное завершение команды копирования не подтверждает пригодность данных.
Поиск стоит начинать вне недоступной площадки: независимое объектное хранилище, вынесенная реплика, архив БД, снимок диска в другом контуре, данные интеграционных систем, выгрузки и артефакты CI/CD.
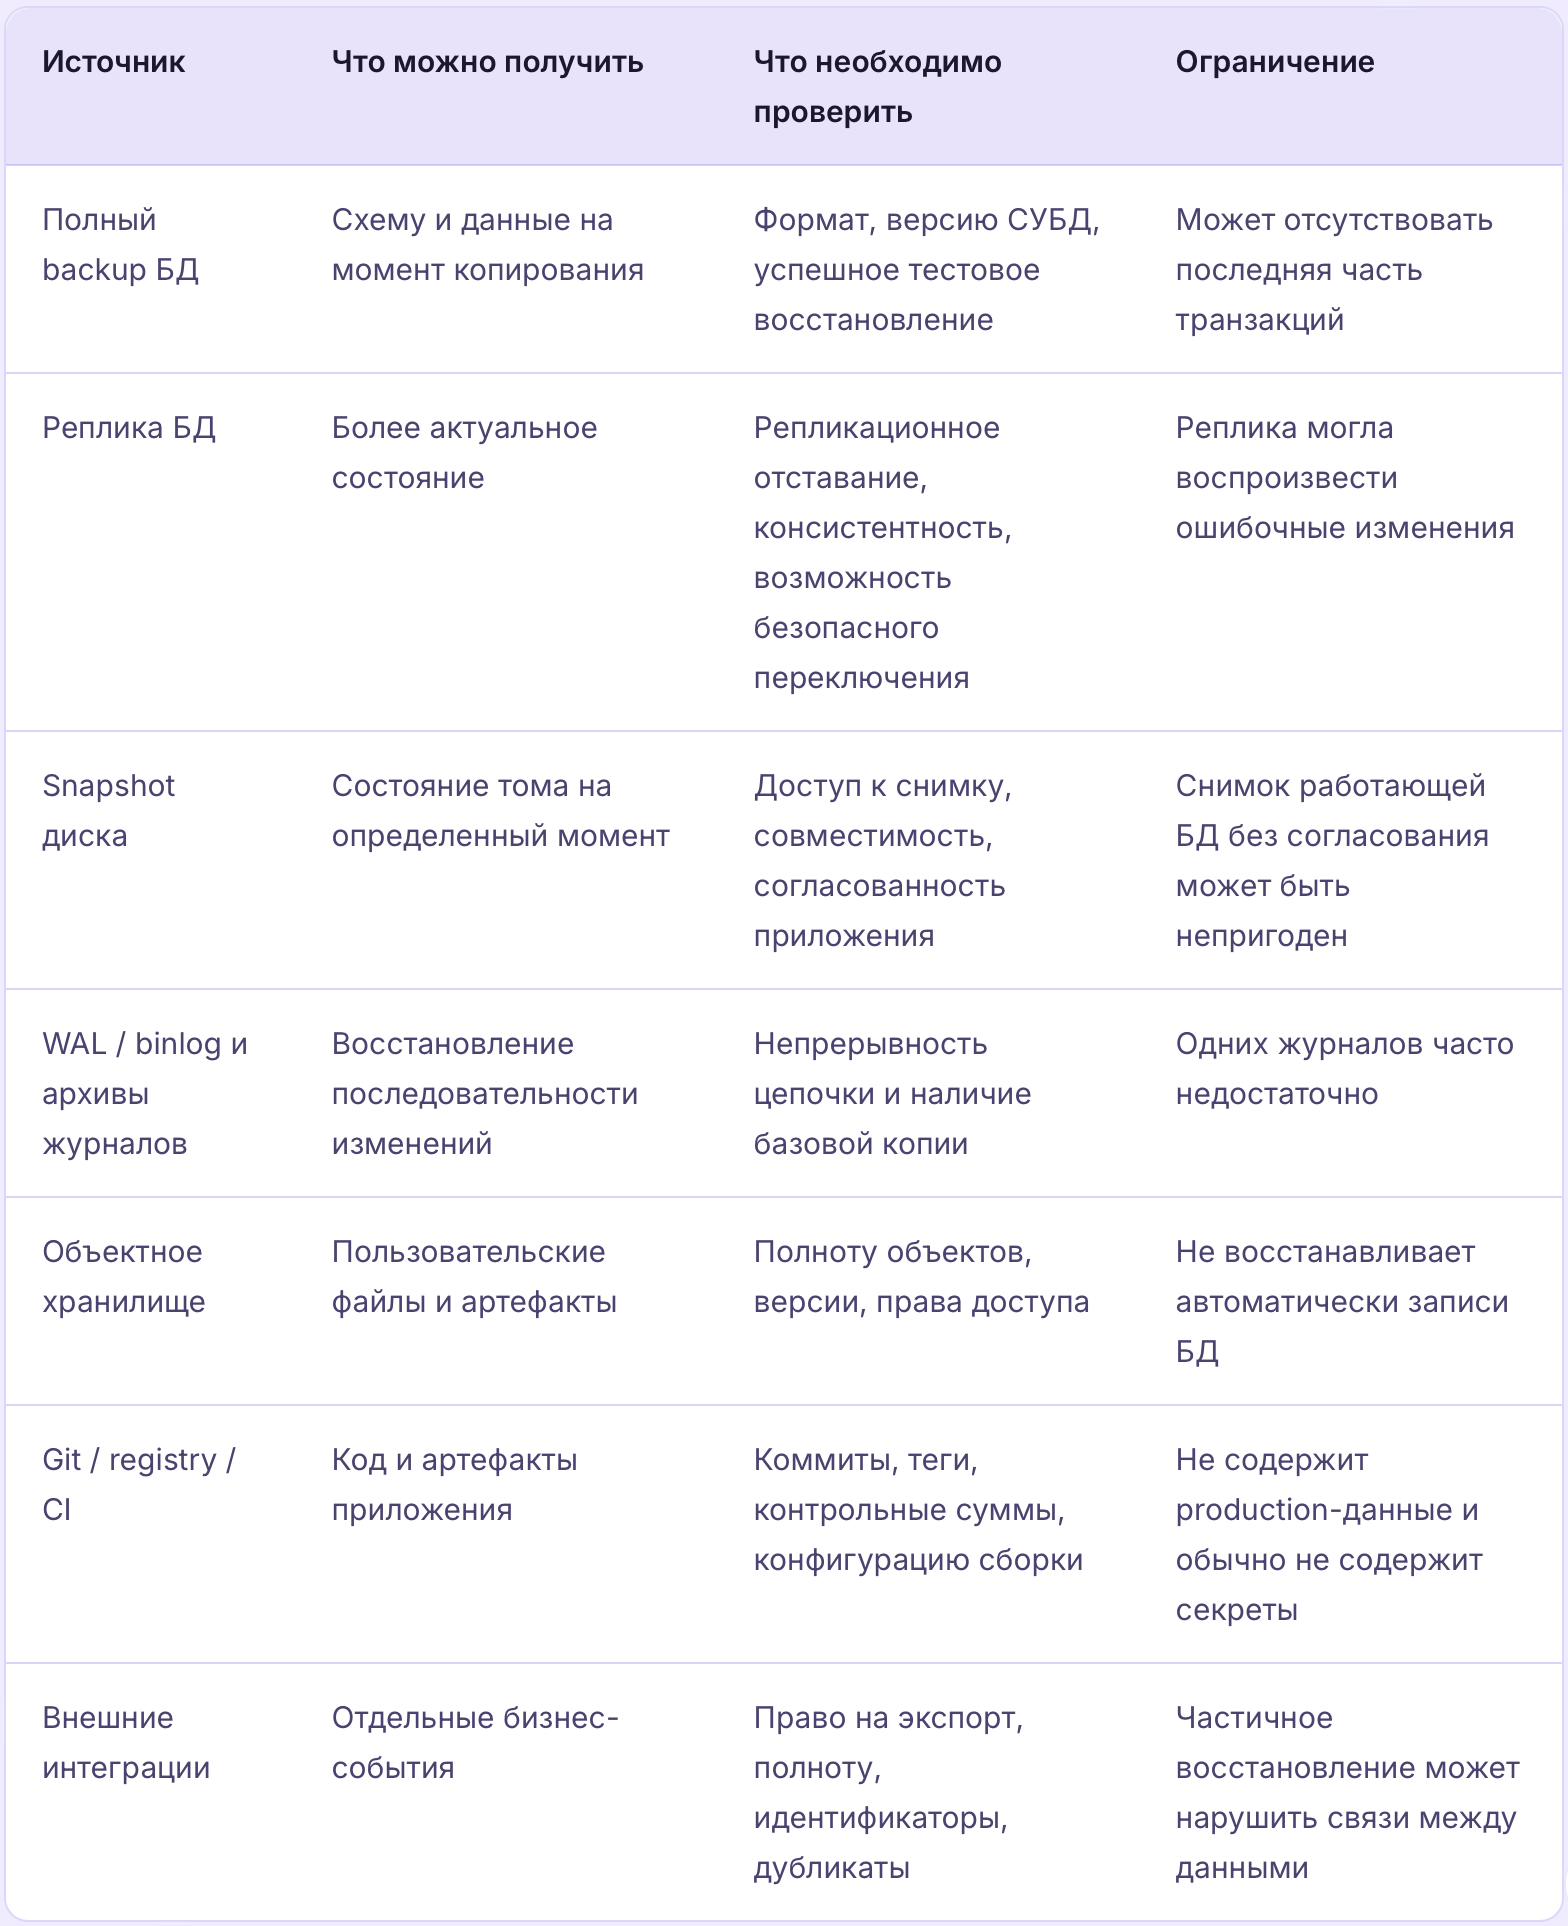
Почему нельзя просто восстановить последнюю реплику?
Репликация поддерживает копию изменений, но сама по себе не является историческим архивом. Удаленная запись или логически поврежденные данные могут быть воспроизведены на реплике. Перед повышением ее роли проверяют отставание, целостность, ограничения на запись, порядок переключения и наличие отдельной резервной копии.
В этой ситуации не существует честной универсальной команды, которая вернет данные с недоступного хранилища. Возможности зависят от того, сохранен ли сам носитель, существуют ли реплики, снимки или независимые выгрузки и имеет ли владелец системы законный доступ к ним.
Порядок действий:
Откройте обращение через официальный канал владельца инфраструктуры. Укажите идентификаторы ресурсов, временной интервал и требуемый способ получения данных. Не передавайте пароли или ключи в открытом обращении.
Проведите поиск независимых резервных копий и данных у доверенных контрагентов. Сверьте период, полноту и юридические права на использование.
Отдельно оцените возможность частичного восстановления: код, каталог товаров, документы, медиафайлы и транзакции могут находиться в разных системах.
Подготовьте чистую целевую среду, не выдавая ее за восстановленную систему. До возврата данных можно восстановить инфраструктурный каркас, автоматизацию развертывания и изолированный стенд.
Зафиксируйте, что именно невозможно вернуть, какие записи придется реконструировать и кто принимает бизнес-риск.
Когда самостоятельные действия необходимо остановить
Если неизвестно состояние единственного хранилища, не определена последовательность транзакций или данные могут иметь юридическое значение, прекращайте попытки записи и восстановления поверх исходных носителей. Понадобятся специалисты по соответствующей СУБД, владельцы данных и, в необходимых случаях, профильные эксперты по восстановлению.
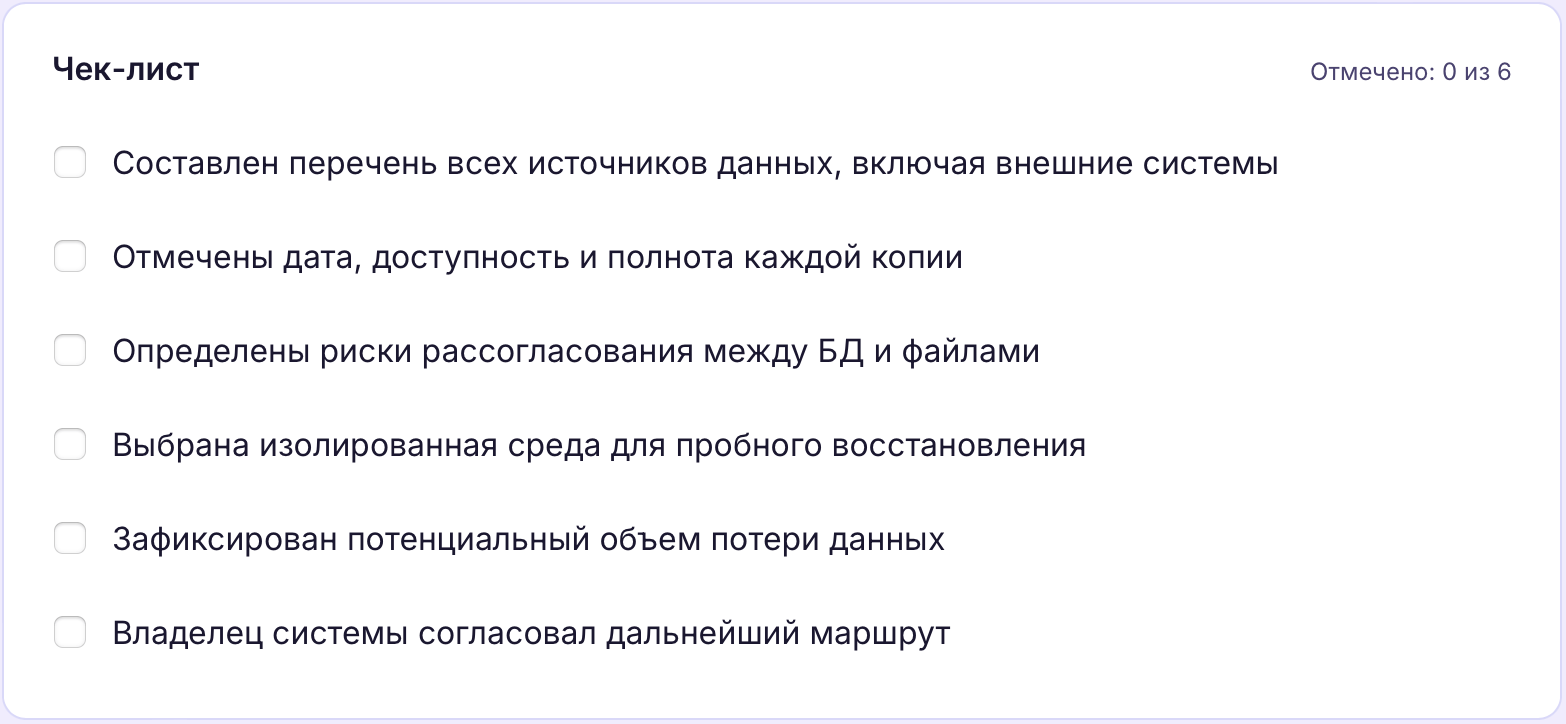
Результат этапа: известен не только план миграции, но и реалистичный объем восстанавливаемых данных.
Универсальная рекомендация взять сервер мощнее прежнего плохо работает. Одному приложению важна производительность одного ядра, другому - задержка сети между сервисами, третьему - пропускная способность дисков или память ускорителя.
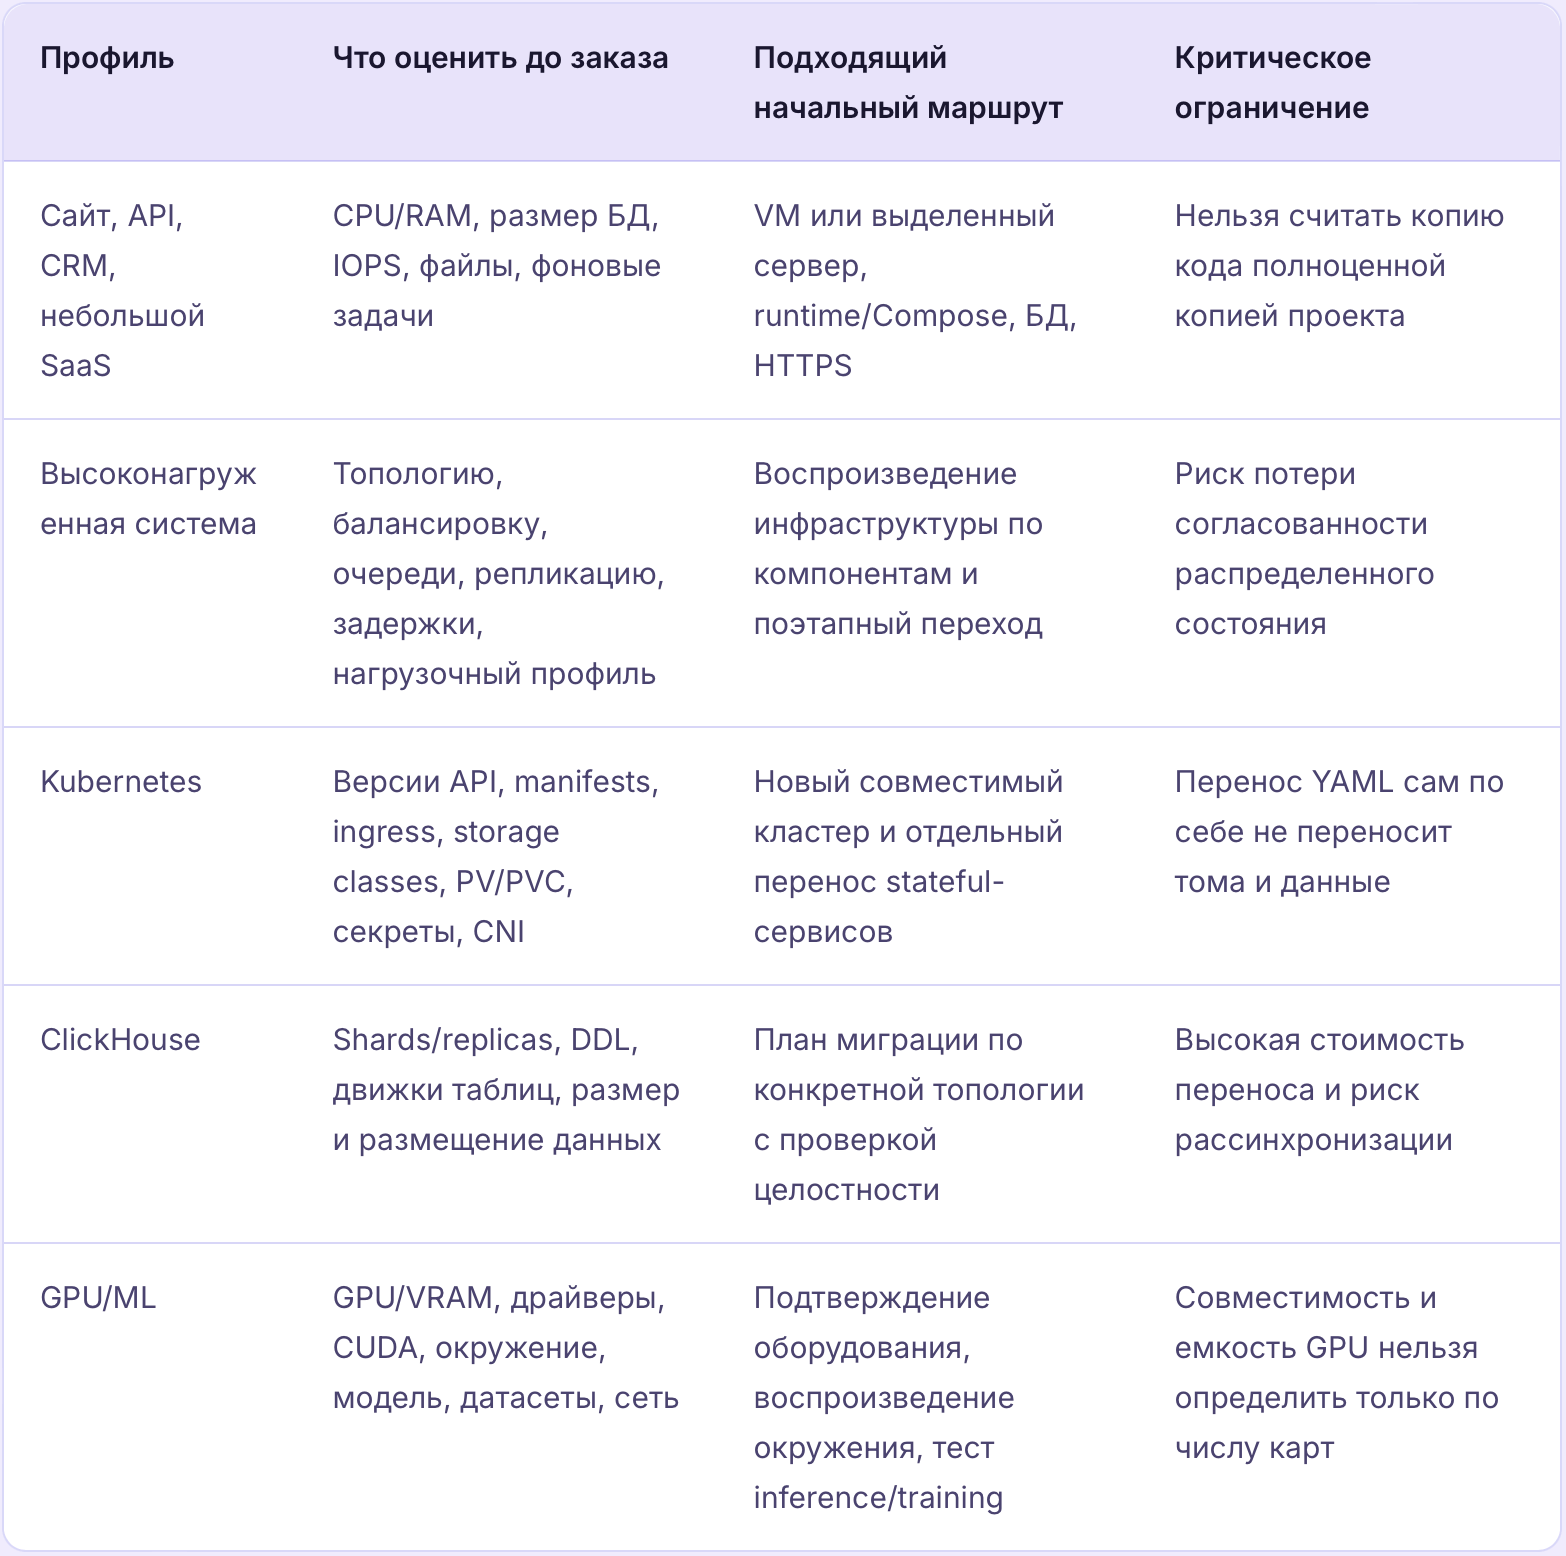
Для большинства небольших веб-сервисов практический маршрут начинается с инвентаризации приложения, его БД и внешних зависимостей. На новой площадке подготавливают Linux, безопасный доступ, контейнерную или обычную среду исполнения, сетевые правила, сертификаты и резервное копирование. Затем проводят пробное восстановление и только после этого переключают домен.
Здесь первичен не сервер, а топология. Составьте список узлов, их ролей, хранилищ, очередей, балансировщиков и сетевых связей. Отдельно измерьте показатели при нормальной и пиковой нагрузке. Миграцию выполняют по разработанному плану, учитывающему согласованность данных, возможность двойной записи и условия отката.
Для inference важны задержка, пропускная способность, память GPU, совместимость библиотек и размер моделей. Для обучения добавляются скорость загрузки датасетов, межузловая сеть, устойчивость длительных задач и возможность возобновления из контрольных точек. Доступность GPU конкретной модели необходимо подтверждать до миграции, а не после переноса данных.
Что должно получиться перед выбором провайдера
Одна техническая спецификация: нужные CPU/RAM, типы и объемы дисков, сеть, регион, тип и количество GPU, требуемые сервисы, бюджет, RTO/RPO и ограничения на размещение данных. Без нее предложения провайдеров сложно сравнивать объективно.
Главная ошибка при срочном переносе - принять исправную статус-страницу за доказательство наличия свободных серверов. Это разные сведения.
Статус сервиса показывает известные инциденты и состояние платформы.
Каталог конфигураций показывает, какие продукты в принципе предлагаются.
Квота ограничивает объем ресурсов, который может использовать конкретный проект или аккаунт.
Свободная емкость пула определяет, можно ли выделить ресурсы в выбранной локации прямо сейчас.
Подтвержденное выделение означает, что подходящий ресурс действительно создан или его предоставление подтверждено на согласованных условиях.
Таблица не является рейтингом. У всех провайдеров используются одинаковые критерии; фактическое наличие ресурсов и коммерческие условия в ней не утверждаются.
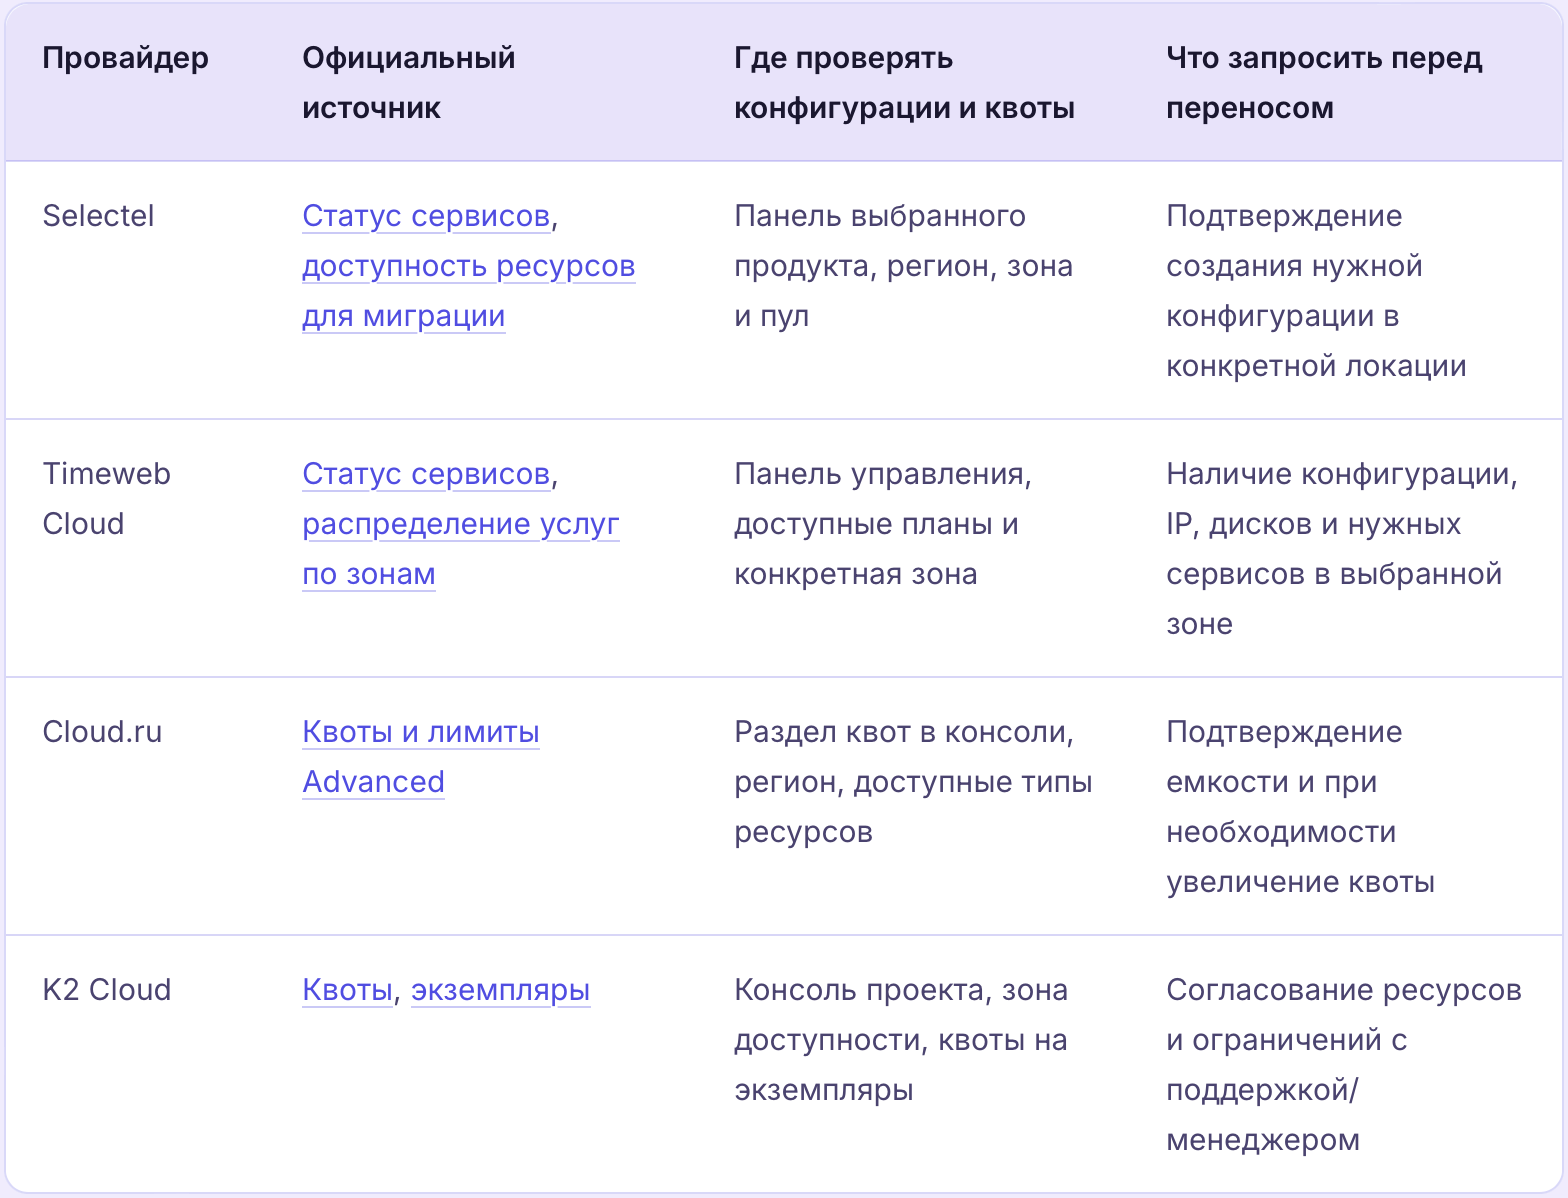
У Selectel в официальной документации отдельно оговорено, что доступность ресурсов по локациям меняется, а забронировать их заранее нельзя. Поэтому планы, зависящие от конкретного пула, следует строить только после актуальной проверки. У остальных провайдеров необходимо так же различать квоты аккаунта и физическую доступность подходящих ресурсов.
Выберите разрешенные законом и договором регионы размещения.
Сверьте требуемую конфигурацию: CPU, RAM, GPU, тип диска, IOPS, сеть, внешний IP и managed-сервисы.
Проверьте ограничения и квоты аккаунта; при необходимости запросите их увеличение.
Попытайтесь создать тестовый ресурс подходящего класса в целевой зоне либо получите подтверждение от провайдера, если создание требует отдельного согласования.
Проверьте полученный ресурс: фактические характеристики, сеть, диски, доступы и время подготовки.
Оцените не только цену вычислений, но и хранение, исходящий трафик, резервные копии, балансировщики, лицензии и поддержку.
Уточните возможность последующего масштабирования и условия восстановления после отказа зоны.
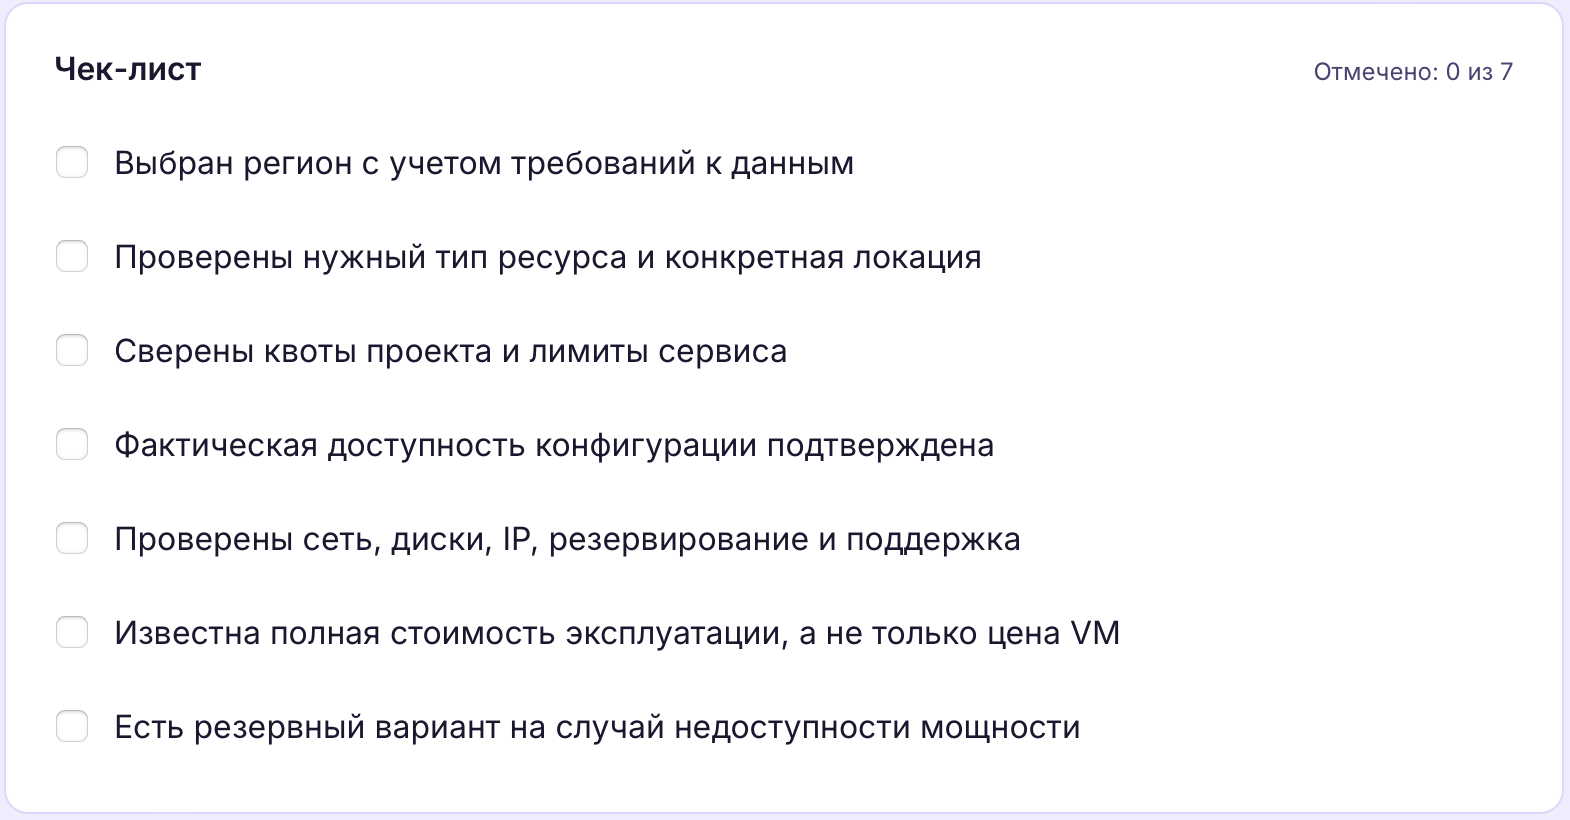
Если нужный пул недоступен, рассмотрите другую разрешенную зону, иной класс вычислений, выделенный сервер или собственное оборудование. Не переносите чувствительные данные в зарубежный регион только потому, что там есть свободные ресурсы: сначала выполните правовую проверку из следующего раздела.
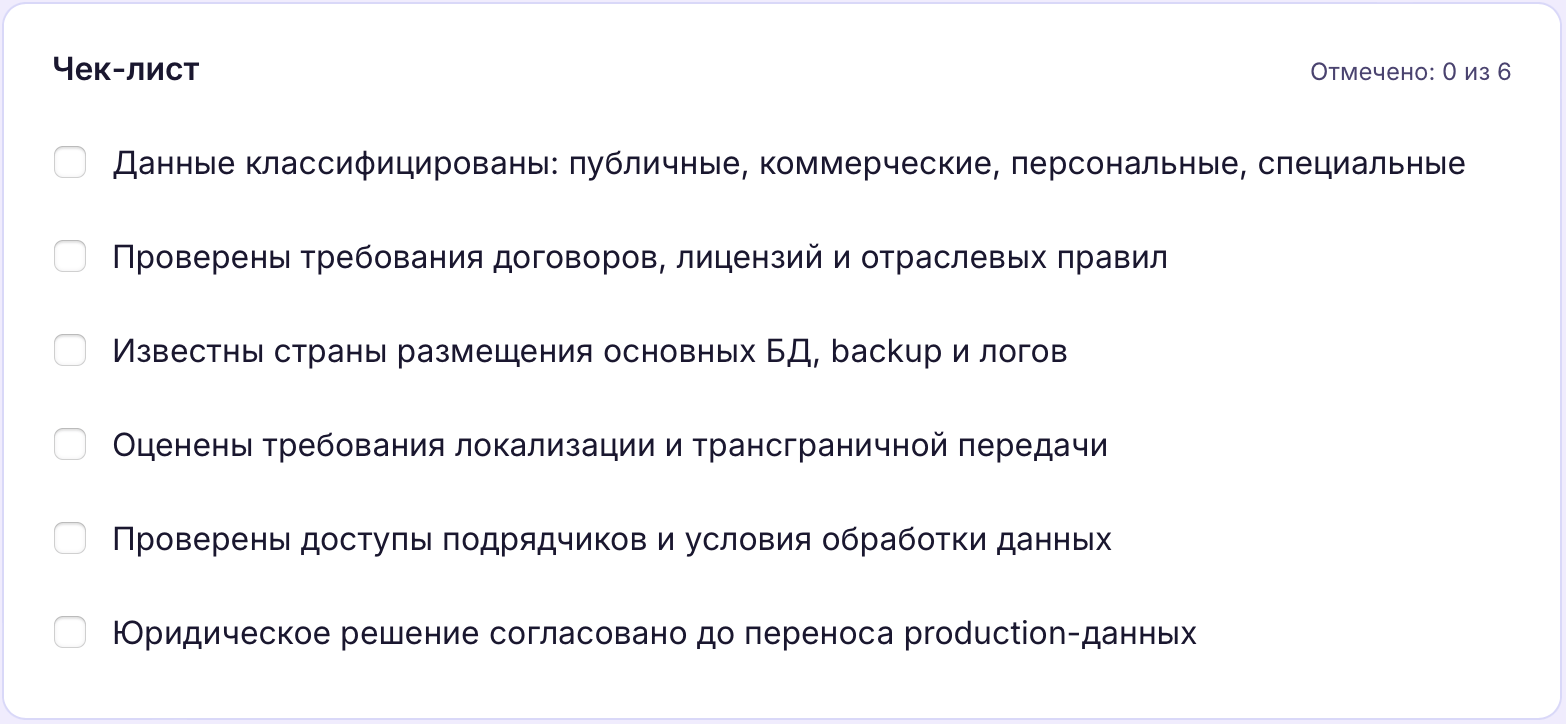
Для инфраструктуры важна не только производительность, но и правовой режим информации. Прежде чем выбрать страну или регион, нужно определить состав данных и роль вашей компании в их обработке.
В российских проектах особое значение имеют требования Федерального закона № 152-ФЗ. Часть 5 статьи 18 регулирует использование баз данных при сборе персональных данных граждан РФ, а статья 12 - трансграничную передачу персональных данных. Конкретная схема обработки, исключения, уведомления и ограничения оцениваются применительно к оператору и его процессам. Сам факт наличия сервера за границей не позволяет сделать однозначный вывод о законности или незаконности всей архитектуры.
Не переносите персональные данные за границу без проверки правовых оснований
До миграции определите категории данных, место их первичного сбора, операции с ними, участников обработки, законность передачи и применимые требования к уведомлениям. Проверяйте не только основную БД, но и резервные копии, логи, телеметрию, объектные хранилища и внешние сервисы. Итоговое решение должно быть согласовано ответственным за персональные данные и профильным юристом.
Наша система сама подберет вам исполнителей на услуги, связанные с разработкой сайта или приложения, поисковой оптимизацией, контекстной рекламой, маркетингом, SMM и PR.
Заполнить заявку
13796 тендеров
проведено за восемь лет работы нашего сайта.
Ниже приведен базовый маршрут для одного сервера с Ubuntu Server 24.04 LTS. Он подходит как ориентир для типового веб-приложения, но не заменяет инфраструктурный проект, настройку отказоустойчивости или развертывание распределенного кластера. Команды выполняются на собственном или разрешенном к администрированию сервере.
Перед выполнением команд
Убедитесь, что доступны консоль провайдера или другой независимый способ входа, действуют актуальные резервные копии и понятна текущая конфигурация сети. Команды установки, обновления и изменения firewall не следует без проверки выполнять в действующем production-окружении. Примеры ниже не заменяют техническое ревью и не гарантируют отсутствие простоя.
После входа на новый сервер можно безопасно начать с команд чтения состояния. Они не устанавливают пакеты и не меняют конфигурацию.
cat /etc/os-release
uname -m
nproc
free -h
lsblk -f
df -h
ip -brief address
ip route
Ожидаемый результат: вы видите версию ОС и архитектуру процессора, число доступных логических CPU, память, смонтированные файловые системы и сетевые интерфейсы. Перед продолжением сверьте их с заказанной конфигурацией.
Если доступ предоставлен только под root, создайте отдельного пользователя с правом администрирования. Имя operator здесь пример: в вашей системе оно должно соответствовать принятой политике учетных записей.
adduser operator
usermod -aG sudo operator
id operator
Команда adduser интерактивна и запросит пароль. Дальше добавьте публичный SSH-ключ администратора разрешенным в организации способом, проверьте права на .ssh и authorized_keys. Приватный ключ никуда не копируйте.
Откройте второе SSH-подключение от имени нового пользователя и убедитесь, что sudoработает. Старую сессию root оставьте открытой до окончания проверки. Только после этого можно отдельно согласовывать изменение правил входа по SSH.
Критерий перехода: новый пользователь действительно входит по SSH и имеет только необходимые права. Не блокируйте root-доступ до проверки альтернативного входа.
Для нового чистого сервера обновите индекс пакетов и установите согласованные обновления. Если это существующий сервер, сначала проверьте совместимость и план перезагрузки.
sudo apt update
apt list --upgradable
sudo apt upgrade
Далее изучите текущие правила и реальный SSH-порт. Пример ниже предполагает, что SSH работает на TCP/22. Если используется другой порт, команда должна быть изменена до включения firewall.
sudo ufw status verbose
sudo ufw allow 22/tcp
sudo ufw allow 80/tcp
sudo ufw allow 443/tcp
sudo ufw status numbered
Не запускайте sudo ufw enable автоматически. Сначала проверьте правила, сетевые ACL провайдера, порядок доступа к сервисам и наличие резервного административного канала. После включения firewall в рамках согласованной операции необходимо повторно проверить подключение из отдельной сессии.
Особое внимание к Docker: опубликованные порты контейнеров могут обходить ожидаемые ограничения UFW. Ограничения доступа к контейнерам нужно проектировать с учетом поведения Docker и сетевых правил на уровне провайдера.
Для контейнерного приложения используйте поддерживаемый способ установки Docker Engine и Compose Plugin из официального репозитория Docker. Набор команд, ключи репозитория и конфликты с установленными пакетами зависят от состояния ОС, поэтому копировать старые инструкции по установке Docker без проверки не следует.
Порядок: проверить существующие пакеты и версии → подключить официальный репозиторий → установить Docker Engine и Compose Plugin → проверить службу и клиент.
После установки:
sudo systemctl status docker --no-pager
docker --version
docker compose version
Ожидаемый результат: служба работает, обе команды выводят установленные версии. Если пользователь не входит в соответствующую группу, для административных команд может потребоваться sudo. Членство в группе docker дает расширенные права на хосте; не назначайте его автоматически.
На этом этапе должно быть ясно, откуда поступает приложение: проверенный контейнерный образ, утвержденный release-артефакт или репозиторий с известным коммитом. Нельзя брать произвольный образ из неизвестного registry, переносить секреты в исходный код или запускать приложение с необоснованными привилегиями.
Предположим, что у вас уже есть проверенные compose.yaml, образы и необходимые переменные окружения. Тогда безопасная подготовительная проверка выглядит так:
cd /srv/app
sudo docker compose config --quiet
sudo docker compose images
/srv/app - пример заранее подготовленной директории. Здесь нет универсального compose-файла: конфигурация портов, томов, healthcheck, сетей и пользователей контейнеров определяется вашим проектом. Обратите внимание, что docker compose config может показывать подставленные значения переменных; не публикуйте такой вывод целиком, если в нем есть секреты.
После проверки конфигурации, артефактов и сети запуск согласовывается отдельно:
sudo docker compose up -d
sudo docker compose ps
Ожидаемый результат: нужные контейнеры созданы и запущены. Это пока не доказательство исправности приложения. Далее необходима проверка health endpoint, зависимостей, логов и данных.
Не восстанавливайте архив в рабочую БД, пока не проверены его формат, совместимость версий, целостность и стратегия сохранения исходного состояния.
Для PostgreSQL архив пользовательского формата pg_dump -Fc можно сначала просмотреть, не изменяя базу:
pg_restore --list /secure-backups/database.dump
Этот пример применим именно к поддерживаемым архивным форматам pg_restore, а не ко всем файлам .sql или снимкам диска. Просмотр списка объектов не гарантирует успешного восстановления: затем требуется тестовая БД, сверка схемы, записей, ограничений, прав и ожидаемого состояния приложения.
Для MySQL, ClickHouse и других хранилищ используйте их штатные механизмы восстановления. Нельзя подменять процедуру восстановления БД копированием случайных файлов каталога данных.
До изменения DNS проверьте, что приложение отвечает локально, reverse proxy направляет запросы по правильному маршруту, нужные порты разрешены, а HTTP- и HTTPS-проверки согласованы с политикой безопасности.
Если приложение публикуется через NGINX, сперва проверьте синтаксис уже подготовленной конфигурации:
sudo nginx -t
sudo systemctl status nginx --no-pager
Для выпуска сертификата через Certbot доменное имя должно указывать на нужный сервер; выбранный способ HTTP- или DNS-подтверждения требует выполнения соответствующих условий. Перед запуском Certbot изучите инструкцию под вашу ОС и конфигурацию веб-сервера.
После настройки домена и сертификата:
curl --fail --silent --show-error --head https://example.com/
Адрес example.com следует заменить своим доменом. Код HTTP 200 не обязателен для всех приложений, но ответ должен соответствовать ожидаемому контракту. curl -Iобращается методом HEAD, который также не все приложения поддерживают; для них используйте штатный health endpoint с GET.
Без проверяемого восстановления резервное копирование остается предположением. Укажите источник данных, частоту копирования, срок хранения, шифрование, владельца процедуры и место хранения вне единственного сервера, отказ которого нужно пережить.
Минимальная проверка:
Создать копию штатным механизмом приложения или СУБД.
Убедиться, что файл или объект создан, читается и имеет ожидаемый формат.
Восстановить копию в отдельной среде.
Проверить ключевые таблицы, связи, пользовательские файлы и корректность запуска.
Зафиксировать фактически достигнутые RPO и время восстановления.
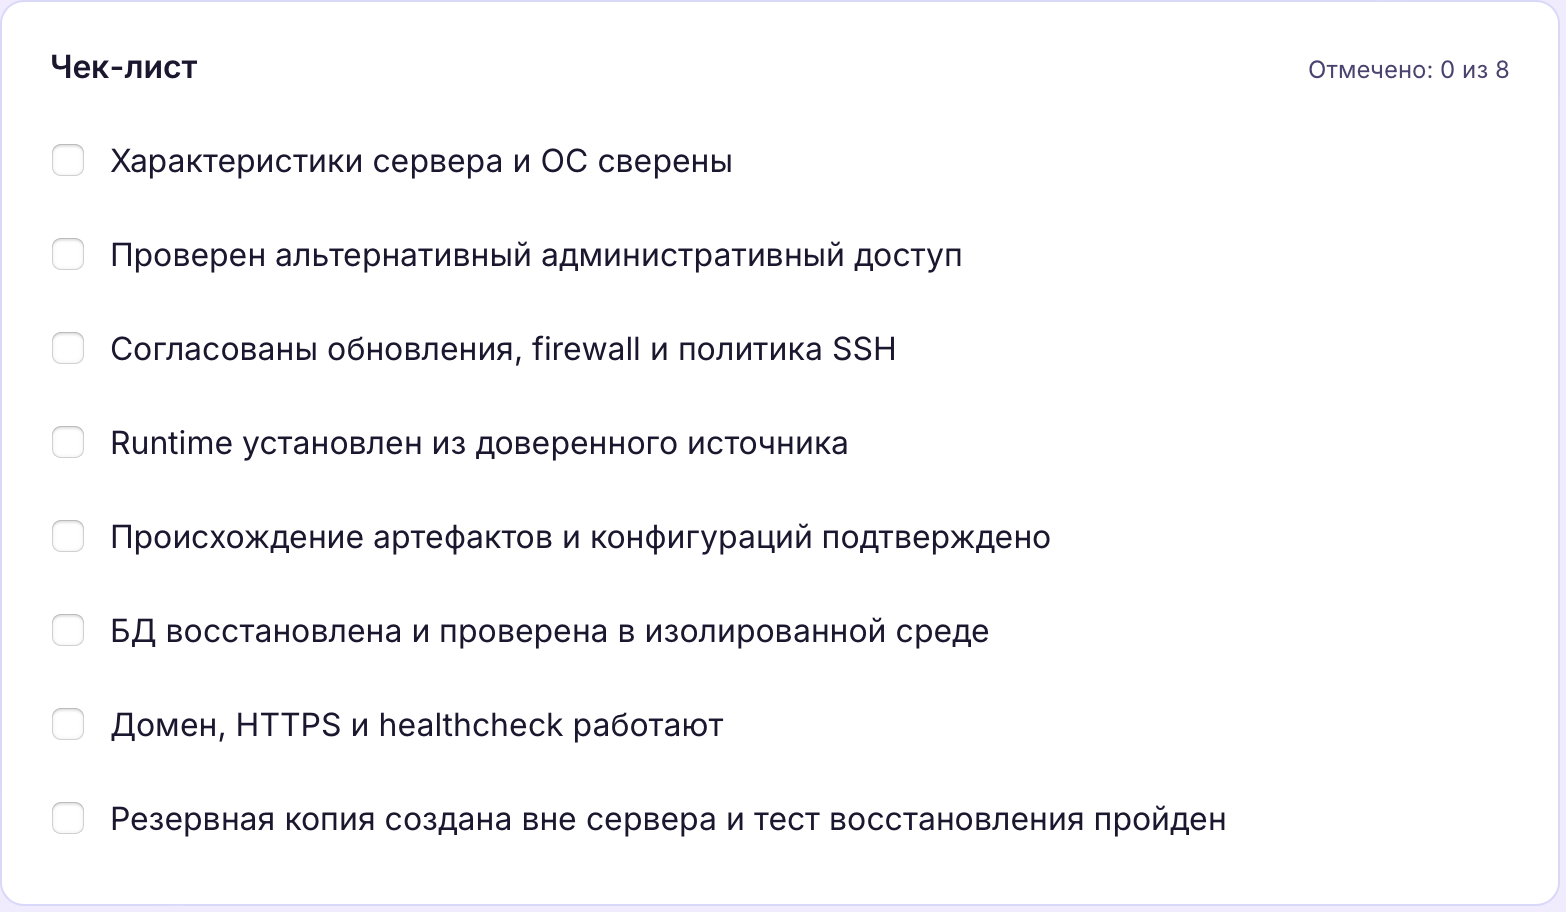
Результат этапа: подготовлен работающий кандидат на замену инфраструктуры. До переключения пользователей остается обязательная приемка.
Описанный выше маршрут для одной виртуальной машины неприменим к распределенной системе без отдельного плана. Ниже - диагностические проверки, а не команды автоматической миграции.
Прежде чем переносить приложения, зафиксируйте версию Kubernetes, API и манифесты, ingress-контроллеры, storage classes, PersistentVolumeClaims, секреты, сетевые политики, внешние балансировщики и зависимости от облачных контроллеров.
Если у вас есть авторизованный доступ к исходному кластеру, несколько команд чтения помогут оценить состояние:
kubectl version
kubectl get nodes -o wide
kubectl get pods -A
kubectl get pvc -A
kubectl get storageclass
Ожидаемый результат: видны версии клиента/сервера (при доступности API), узлы, поды и требования к постоянному хранению. При недоступном API команды не заменяют резервную копию кластерного состояния. Не экспортируйте секреты в открытые файлы или логи.
В новой локации необходимо заново проверить сетевую связность, DNS, ingress, постоянные тома, права сервисных аккаунтов и recovery-процедуры stateful-компонентов. Простое применение старых YAML-файлов не переносит содержимое хранилищ.
Для ClickHouse необходимо учитывать движки таблиц, шарды, реплики, хранилище и схему репликации. До миграции определите, можно ли обеспечить согласованную точку восстановления, а также чем будут проверяться количество и корректность записей.
Пример диагностического запроса для авторизованного подключения:
SELECT database, table, engine
FROM system.tables
WHERE database NOT IN ('system', 'INFORMATION_SCHEMA', 'information_schema')
ORDER BY database, table;
Запрос показывает структуру таблиц, но не подтверждает состояние репликации или целостность данных. Для реплицируемых таблиц отдельно исследуют системные представления и применяют документированную для конкретной версии процедуру backup/restore. Команды изменения топологии или переключения реплик универсальными быть не могут.
Даже при совпадении модели ускорителя приложение может не запускаться из-за несовместимых драйверов, CUDA, библиотек или ограничений памяти GPU.
На сервере NVIDIA с установленными драйверами диагностику можно начать так:
nvidia-smi
Проверьте модель и число устройств, доступную видеопамять, драйвер и видимость ускорителей из целевой среды исполнения. Затем убедитесь, что доступны веса моделей, токенизаторы, дополнительные артефакты, датасеты и конфигурация inference-сервиса. Сравнивайте не только успешный запуск, но и фактическую задержку, пропускную способность и потребление памяти под типовой нагрузкой.
Граница готовности распределенной системы
Новый кластер, доступный GPU или успешно запущенный контейнер не равны завершенной миграции. Пока не подтверждены согласованность данных, сетевые связи, производительность и восстановление после отказа, система остается кандидатом на переключение.
Переключение пользователей должно происходить по согласованному критерию готовности, а не по одному успешному HTTP-запросу.
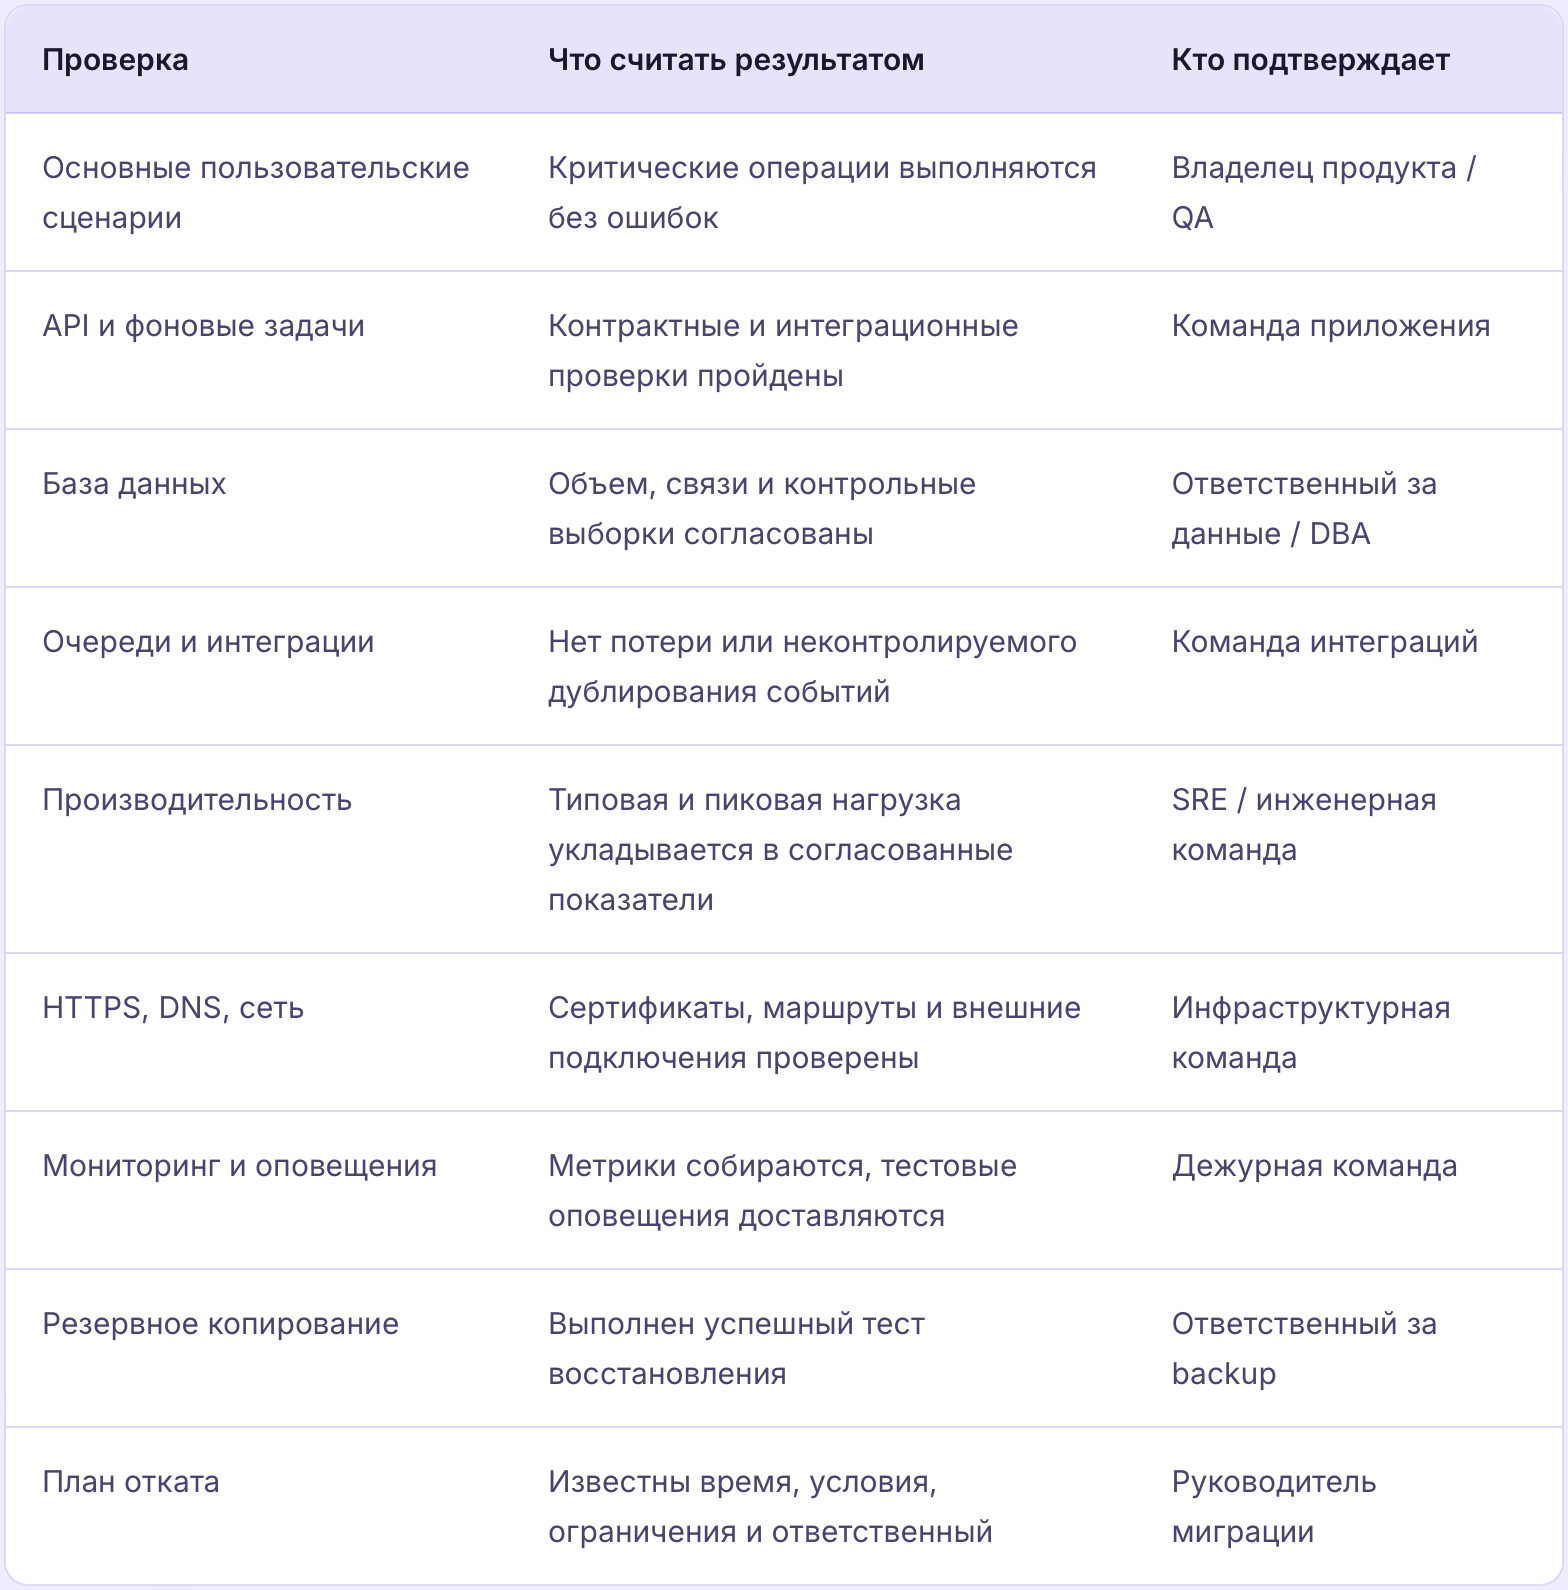
До изменения DNS уменьшение TTL может помочь сократить время распространения изменений, однако не гарантирует мгновенное переключение всех клиентов и не решает проблему открытых соединений. Для stateful-систем особенно важно избежать двух одновременно активных источников записи без согласованной схемы.
Порядок: завершить тесты → зафиксировать состояние данных → согласовать момент переключения → изменить маршрутизацию → проверить реальные пользовательские операции → наблюдать за метриками → объявить завершение после согласованного периода контроля.
Не отключайте источник преждевременно
Если старая инфраструктура еще доступна, сохраняйте ее в согласованном безопасном состоянии до завершения проверок и принятия решения об отключении. Если возврат на нее невозможен, заранее определите сценарий roll-forward: исправление новой площадки без обещаний обратного переключения.
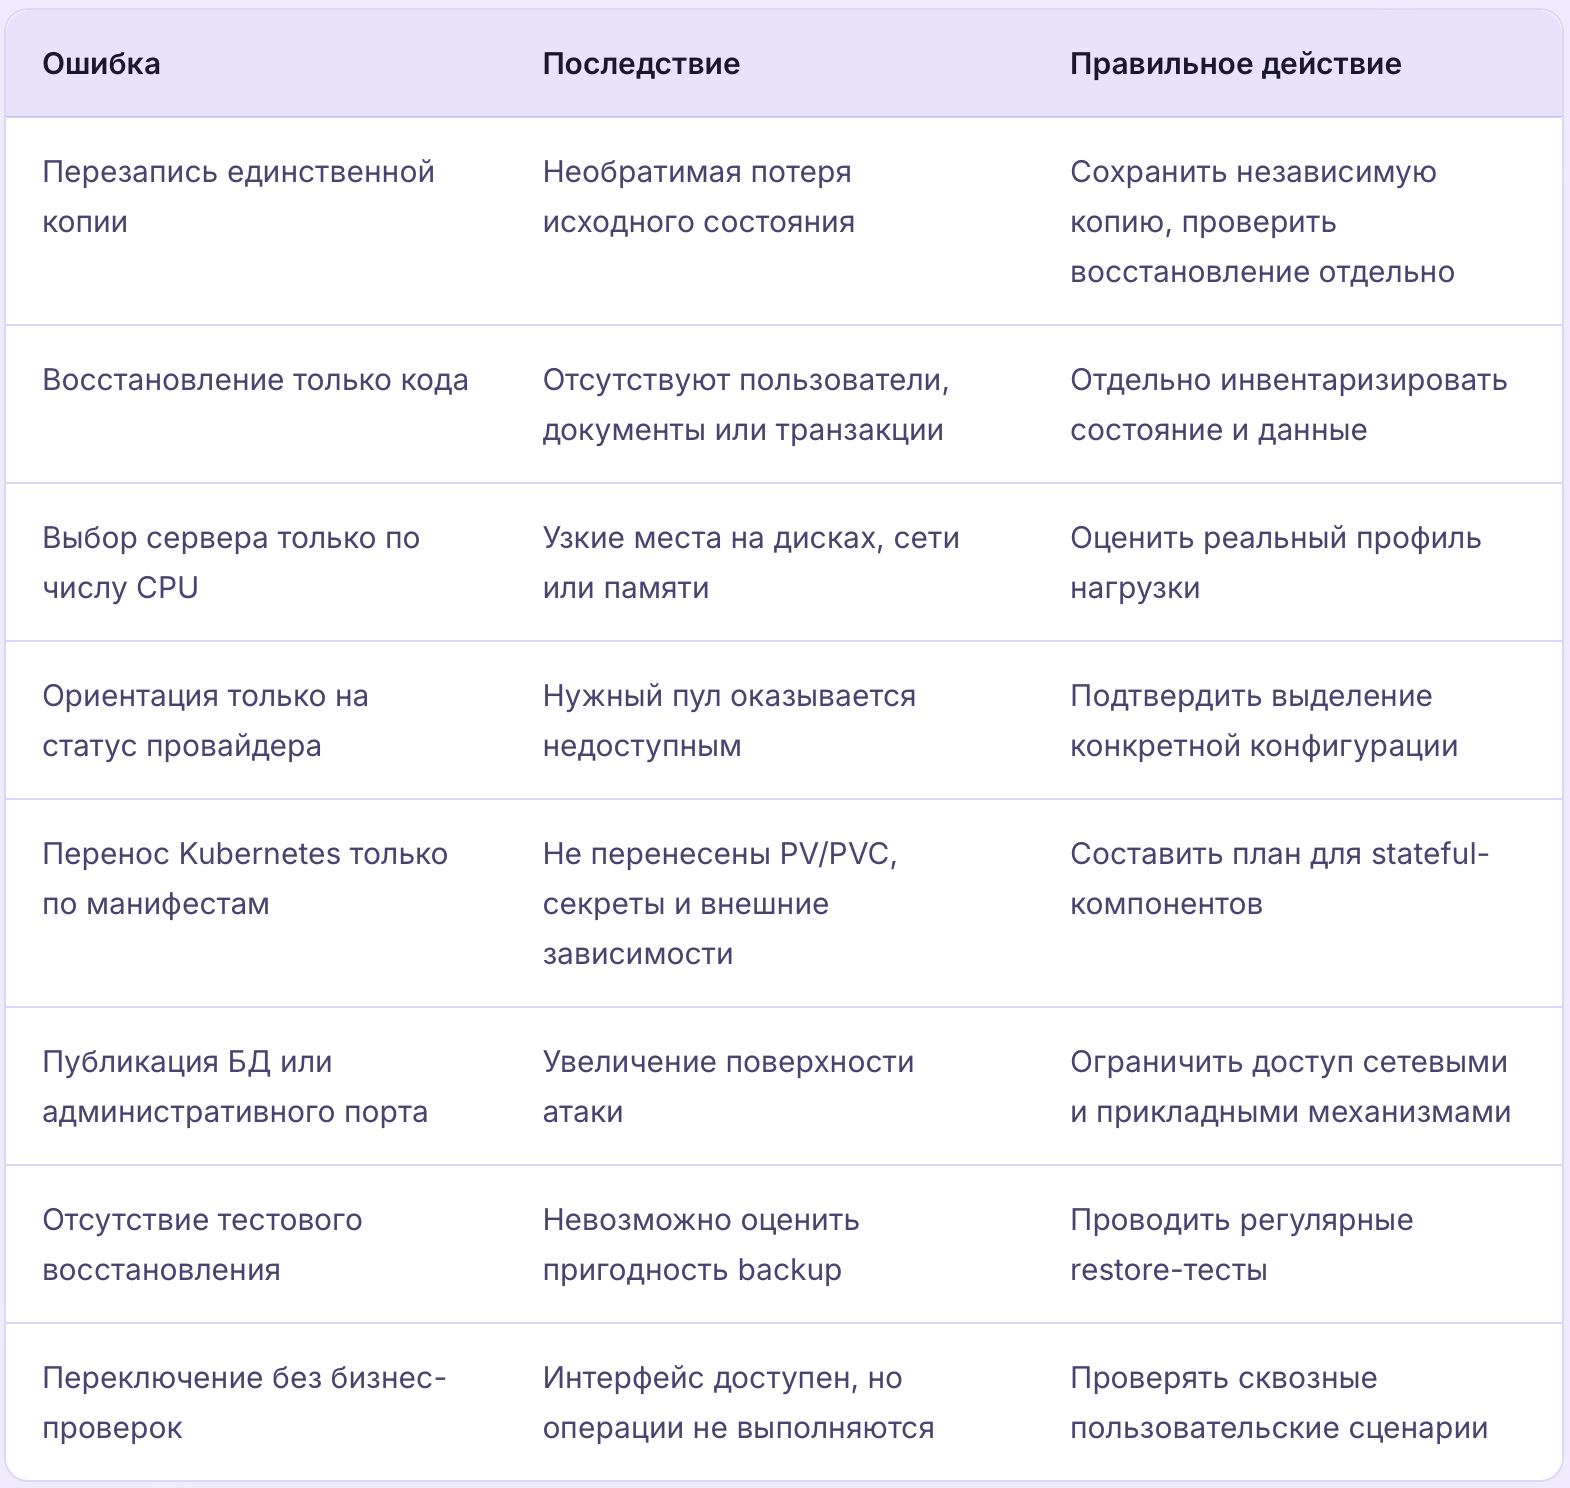
Если нет уверенности в целостности единственной копии, не согласованы допустимые потери данных, неизвестны условия отказа кластера, требуется юридически значимая реконструкция транзакций или существует риск нарушения правил обработки персональных данных, дальнейшие действия должны проходить с участием ответственных специалистов.
В аварийной ситуации инженерная дисциплина полезнее скорости отдельных команд: важнее сохранить шанс на корректное восстановление, чем как можно быстрее увидеть запущенный контейнер.
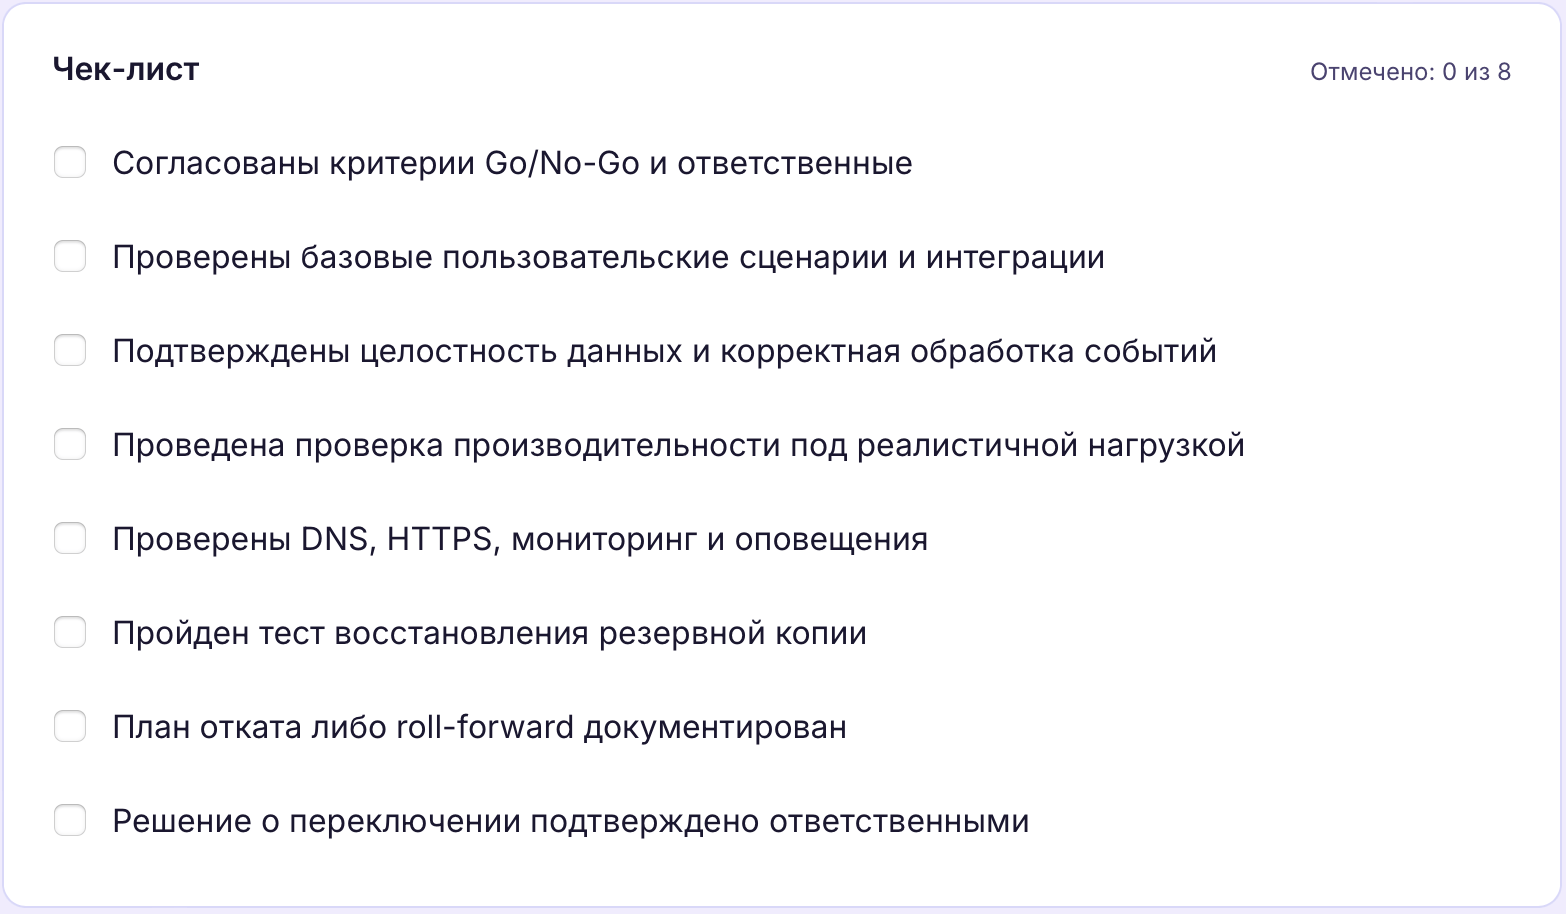
Список подходит для финальной сверки перед приемкой. Отмеченные пункты отражают только вашу локальную работу со страницей и не заменяют протокол согласования в компании.
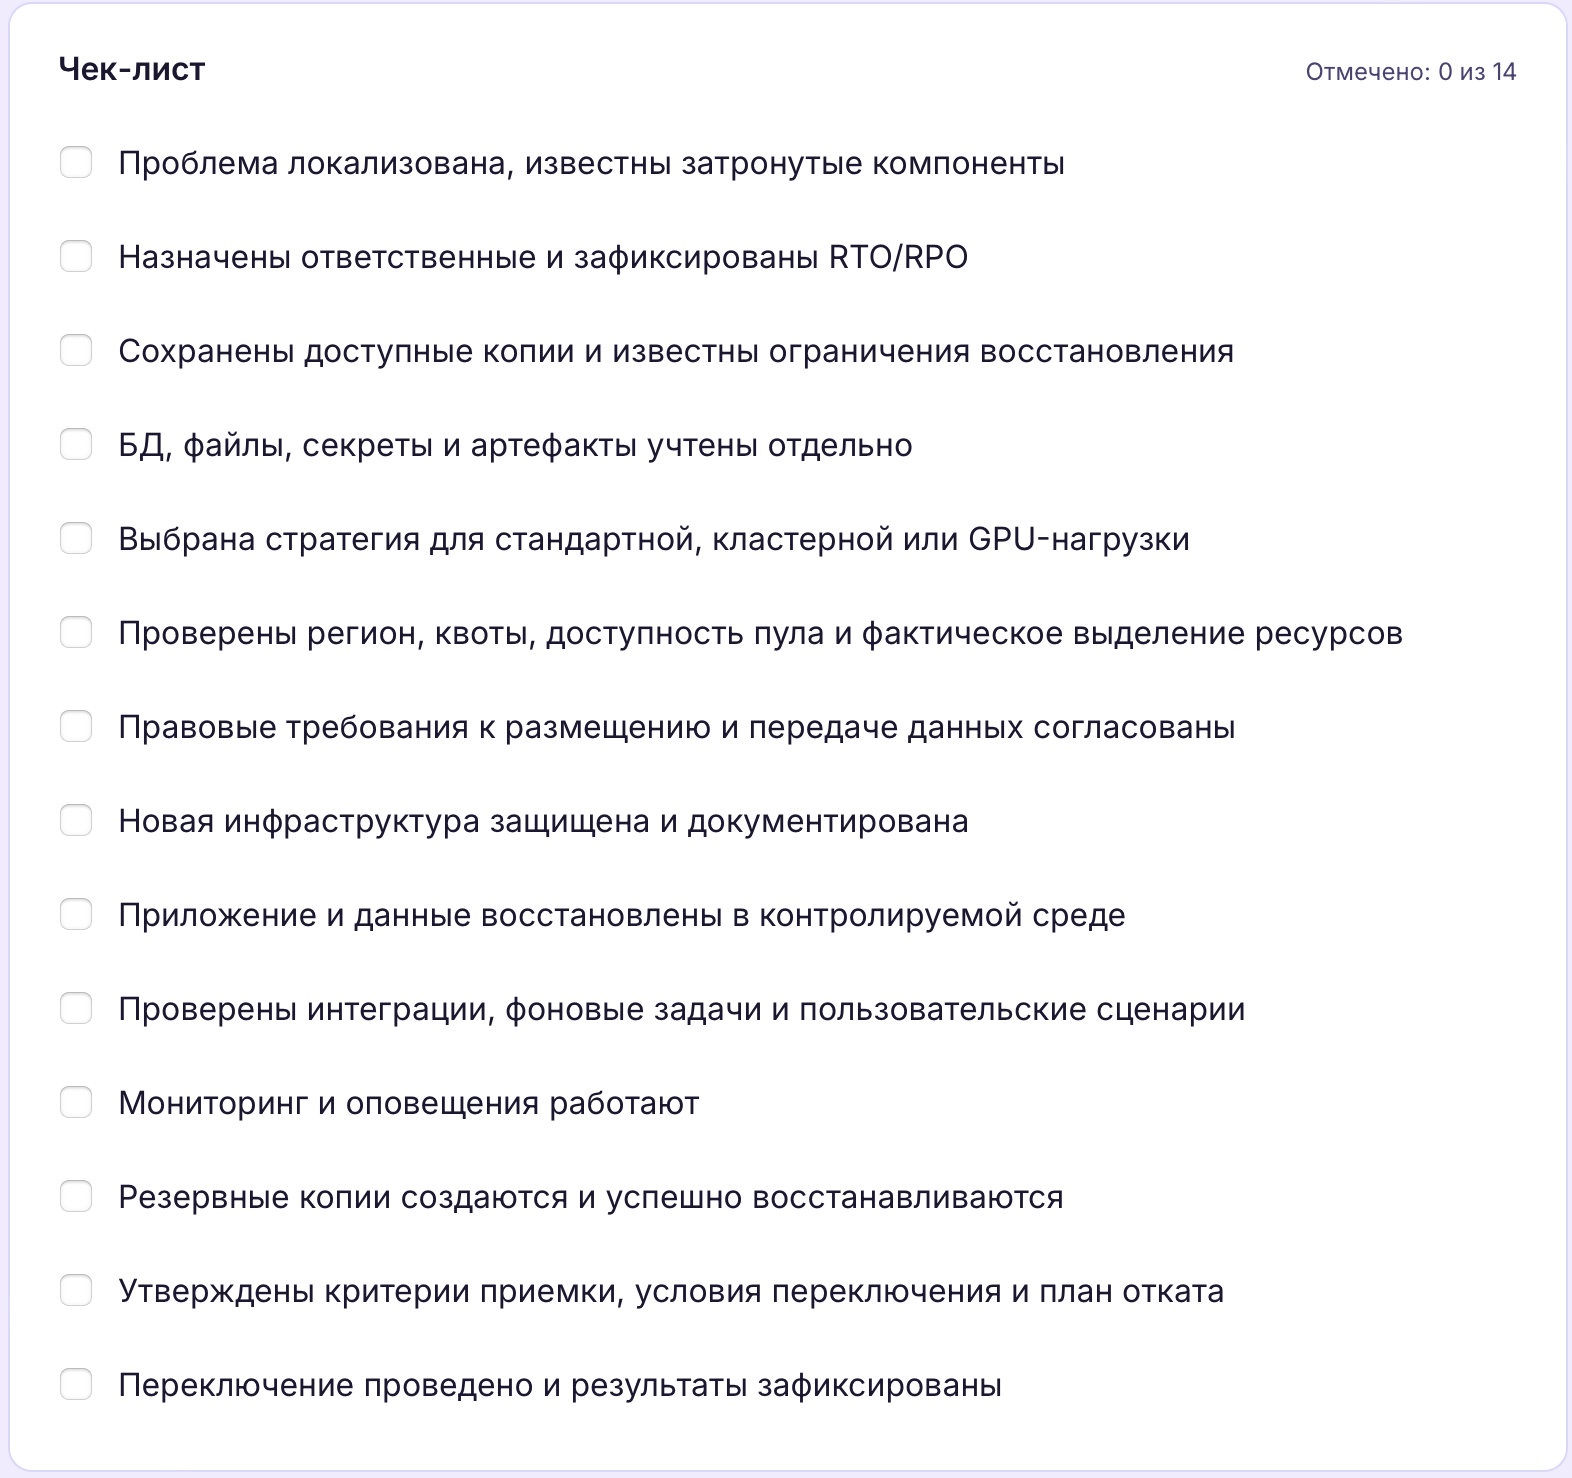
Самостоятельное восстановление оправдано, когда система проста, исходные данные доступны, риски понятны, а специалист может проверить каждый этап. Если инфраструктура распределенная, резервные копии недоступны, простой критичен или перенос затрагивает сложные юридические требования, необходим отдельный план с ответственными, контрольными точками и технической приемкой.
Особенно это относится к Kubernetes и ClickHouse, миграции больших баз данных, GPU-кластерам, работе с единственным экземпляром критичных данных и системам, где ошибка переключения может повлиять на финансовые операции.
ИНДЕВИУМ помогает оценивать инфраструктурные требования, подбирать серверные мощности, организовывать миграцию и развертывание проектов.