

Тендеры и лиды
Информация
Час музыки в формате WAV может занимать около 600 МБ, тогда как тот же материал в MP3 нередко укладывается примерно в 50 МБ. Скан договора на десять страниц может занимать десятки мегабайт в TIFF и меньше мегабайта в PDF. Разница объясняется не каким-то трюком, а особенностями самих данных: практически в любом файле есть повторы, закономерности и детали, которые можно представить более компактно.
Сжатие данных - это способ записать ту же информацию более экономно.
Разберемся, почему файлы вообще удается уменьшать, чем отличается сжатие без потерь от сжатия с потерями, почему ZIP не помогает существенно уменьшить папку с фотографиями, какой смысл использовать 7z и что происходит со сжатием данных в интернете и QR-кодах.
Сжатие представляет собой перекодирование данных в более короткую форму, из которой затем можно получить исходную информацию полностью или, в некоторых случаях, с допустимой потерей части данных.
Программа, выполняющая такую операцию, называется компрессором или кодером. Обратный процесс - распаковка или декодирование.
Представить принцип можно на простом примере. Если в тексте несколько раз подряд написано «улица Ленина», вместо повторения всей фразы можно записать «улица Ленина ×3». Информации в такой записи столько же, но места она занимает меньше.
Компьютерные алгоритмы делают примерно то же самое, только работают не со словами, а с последовательностями байтов и используют строгие математические правила, благодаря которым данные можно восстановить.
При этом под словом «сжатие» скрываются две принципиально разные технологии.
Сжатие без потерь (lossless). После распаковки получается абсолютно идентичный исходный файл - вплоть до каждого байта. Такой подход используется в ZIP, 7z, RAR, gzip, PNG, FLAC. Он необходим для документов, таблиц, программного кода, баз данных и любых других данных, где нельзя допустить изменение содержимого.
Сжатие с потерями (lossy). Часть информации удаляется без возможности восстановления. Взамен размер файла может уменьшиться в несколько или даже десятки раз. Такой принцип используется в JPEG, MP3, AAC, H.264, AV1 и других форматах. Он подходит для фотографий, музыки и видео, где небольшое изменение качества часто незаметно человеку.
Есть и еще один процесс, который в бытовом смысле тоже называют сжатием. Речь идет об оптимизации: удалении метаданных, лишних слоев в PDF, уменьшении разрешения изображения и других подобных действиях. Формально это уже не сжатие как таковое - часть данных просто удаляется. Но конечный результат тот же: файл становится меньше.
Главное практическое правило: документы, таблицы и бухгалтерские данные сжимают без потерь. Фотографии, музыку и видео при необходимости можно сжимать с потерями, если качество после обработки остается приемлемым.
Возможность сжатия напрямую связана с избыточностью данных. Это информация, которую необязательно хранить в полном объеме, потому что ее можно восстановить или предсказать на основании других данных.
В реальных файлах избыточность встречается в разных формах.
Повторяющиеся фрагменты. В HTML-документе один и тот же тег может встречаться сотни раз. В CSV-файле многократно повторяются названия городов и товаров. В отсканированном документе могут присутствовать большие однотонные области. Нет необходимости каждый раз хранить одинаковые последовательности полностью.
Неравномерное распределение символов. В русском языке некоторые буквы встречаются намного чаще других. При обычном представлении символы могут занимать одинаковое количество места, хотя статистически это не всегда оправдано. Алгоритм сжатия может назначить наиболее частым символам короткие коды, а редким - более длинные.
Предсказуемость соседних значений. В фотографии пиксели, расположенные рядом, часто имеют близкие оттенки. Вместо хранения абсолютного значения каждого пикселя можно сохранить разницу между соседними значениями. Если изменения небольшие, такую последовательность удается представить компактнее.
Особенности человеческого восприятия. Этот фактор используется в сжатии с потерями. Человек не одинаково воспринимает все элементы изображения, звука или видео. Например, глаз чувствительнее к перепадам яркости, чем к небольшим изменениям цвета, а слух не воспринимает некоторые тихие звуки на фоне более громких.
Отсюда следует важное ограничение: сжимать бесконечно нельзя.
Если данные уже сжаты, зашифрованы или обладают высокой степенью случайности, алгоритму практически нечего сокращать. Более того, после попытки упаковки готового JPEG-файла в архив его размер иногда даже немного увеличивается. Причина проста: архиватор добавляет служебную информацию - заголовки, таблицы и другие структуры, - но не находит внутри достаточно повторов для экономии места.
Большинство популярных алгоритмов сжатия без потерь используют комбинации нескольких базовых принципов.
RLE, или Run-Length Encoding, - один из самых простых вариантов.
Если последовательность выглядит как «ААААААБББ», ее можно представить как «6А3Б». Вместо того чтобы шесть раз хранить один и тот же символ, достаточно указать сам символ и количество его повторений.
Метод хорошо работает с данными, где встречаются длинные одинаковые последовательности. Например, это могут быть простые черно-белые изображения, скриншоты интерфейсов или рисунки с большими однотонными областями.
На обычной фотографии эффективность RLE будет намного ниже: соседние пиксели редко имеют абсолютно одинаковые значения.
Поэтому в современных форматах RLE чаще встречается как один из этапов более сложного алгоритма, а не как самостоятельный способ сжатия.
Один из главных принципов современных архиваторов - алгоритмы семейства LZ, названные по именам Лемпеля и Зива.
Идея заключается в использовании словаря уже встречавшихся последовательностей.
Алгоритм последовательно просматривает файл и запоминает фрагменты, которые уже встретились. Если позже появляется такой же фрагмент, его можно не записывать повторно. Вместо этого сохраняется ссылка на предыдущую позицию, например: «вернись на 340 байт назад и возьми оттуда 12 байт».
Получается, что десятки повторяющихся символов заменяются короткой инструкцией.
Семейство LZ включает множество вариантов: LZ77, LZ78, LZW, LZMA, LZ4 и другие. Они различаются деталями работы, скоростью и степенью сжатия.
Особенно хорошо такой подход проявляет себя в текстах, исходном коде, логах, XML и JSON. В подобных данных повторяются не только отдельные символы, но и целые конструкции: названия полей, HTML-теги, шаблонные фрагменты и типовые строки.
На результат заметно влияет размер словаря или окна, то есть объем данных, который алгоритм способен анализировать для поиска уже встречавшихся последовательностей.
Например, у классического Deflate размер окна составляет 32 КБ. Повтор, расположенный дальше этой границы, алгоритм уже не сможет использовать в виде такой ссылки. В LZMA, который применяется в 7-Zip, словарь значительно больше - он может достигать сотен мегабайт. Поэтому алгоритм способен находить похожие фрагменты даже на большом расстоянии друг от друга.
Еще один фундаментальный принцип - статистическое кодирование.
Алгоритм Хаффмана анализирует частоту появления символов и строит таблицу кодов. Часто встречающиеся символы получают короткие битовые последовательности, а редкие - более длинные.
Это позволяет отказаться от одинакового количества бит на каждый символ.
Например, вместо того чтобы тратить восемь бит на каждый символ независимо от его частоты, для распространенных символов можно использовать более короткие коды, а более редким назначить длинные.
Декодирование остается однозначным благодаря структуре кодов: один код не должен быть началом другого.
Существуют и более сложные методы статистического кодирования. Один из них - арифметическое кодирование. Оно позволяет эффективнее использовать доступное пространство и фактически распределять на символ дробное количество битов. В некоторых задачах это дает дополнительные проценты экономии.
Современный формат обычно не ограничивается одним алгоритмом.
Хороший пример - Deflate. Сначала он использует принцип LZ77, чтобы найти повторяющиеся последовательности и заменить их ссылками. Затем получившийся поток дополнительно кодируется с помощью Хаффмана.
Deflate лежит в основе сразу нескольких известных форматов и технологий - ZIP, gzip и PNG. При этом сами форматы решают разные задачи и устроены по-разному.
Другой пример - LZMA, применяемый в 7z. Он использует большой словарь, арифметическое кодирование и дополнительные методы прогнозирования. В результате достигается более высокая плотность сжатия, но ценой становится большее время кодирования и более высокие требования к ресурсам.
При сжатии с потерями задача принципиально другая. Алгоритм не пытается сохранить каждый байт исходного файла. Он определяет, какой информацией можно пожертвовать, чтобы человек при просмотре, прослушивании или просмотре видео не заметил существенного ухудшения.
Именно поэтому такие методы особенно распространены в мультимедиа.
JPEG можно условно представить как последовательность из нескольких этапов.
1. Разделение яркости и цвета.
Исходное изображение обычно представлено в RGB. JPEG переводит его в цветовое пространство, где яркость отделена от цветовой информации.
Человек значительно чувствительнее к деталям яркости, чем к мелким изменениям цвета. Поэтому цветовые каналы можно прореживать сильнее.
Например, используется схема 4:2:0, при которой цветовая информация хранится с меньшим пространственным разрешением. Это позволяет существенно уменьшить объем данных без очевидной потери качества на обычной фотографии.
2. Разложение изображения на частоты.
Изображение разбивается на блоки 8×8 пикселей. Для каждого блока вычисляется набор частотных составляющих.
Плавные изменения цвета и яркости относятся к низким частотам, а мелкие детали, текстуры и резкие границы - к высоким.
3. Квантование.
На этом этапе происходит основная потеря информации. Высокочастотные компоненты округляются сильнее, а некоторые из них могут быть полностью обнулены.
Именно интенсивность этого процесса в конечном счете определяет параметр «качество» JPEG.
После квантования оставшаяся информация может дополнительно кодироваться без потерь.
У такого подхода есть характерные последствия. При сильном сжатии появляются квадратные блоки, ухудшаются градиенты, а вокруг резких контрастных границ могут возникать характерные ореолы и другие артефакты.
Для фотографий значение качества примерно 80-85 часто позволяет получить хорошее визуальное соотношение между размером и качеством. В зависимости от исходного изображения файл может стать в 10-20 раз меньше.
При дальнейшем снижении качества артефакты становятся заметнее, особенно вокруг текста и резких границ.
Современные WebP, HEIC и AVIF используют похожие общие принципы, но применяют более эффективные способы разбиения изображения и предсказания. Поэтому при сопоставимом визуальном качестве они часто позволяют получить меньший файл. Обратная сторона - более высокая сложность кодирования.
Аудиокодеки используют особенности человеческого слуха. Один из ключевых принципов - маскирование.
Громкий звук способен сделать тихие звуки на близких частотах менее заметными или полностью неразличимыми для человека. Аналогичный эффект наблюдается в течение короткого времени после громкого звука.
Кодек строит психоакустическую модель и определяет, какие компоненты аудиосигнала можно передать с меньшим количеством битов или не передавать вовсе.
За счет этого исходный поток аудио можно существенно уменьшить.
Например, несжатый аудиосигнал CD-качества имеет битрейт около 1400 кбит/с. MP3 с битрейтом 192-256 кбит/с для многих слушателей на обычной аппаратуре может звучать практически так же.
Более современные кодеки, например Opus, способны обеспечивать сопоставимое субъективное качество при еще меньшем битрейте в соответствующих сценариях.
Видео использует не только внутрикадровое сжатие. Огромный выигрыш дает тот факт, что соседние кадры обычно очень похожи друг на друга, то есть нет необходимости каждый раз сохранять полный кадр.
Кодек может сохранить один опорный кадр, а для следующих кадров записывать изменения. Алгоритм способен определить движение объектов и сохранить его в виде векторов: например, указать, что определенный блок переместился на несколько пикселей вправо. Поэтому статичное интервью обычно сжимается намного эффективнее, чем съемка динамичной сцены с камерой в движении.
Разрешение само по себе не всегда хорошо описывает объем и качество видео. Важны также битрейт, кодек, сложность сцены и характер движения.
У потерь есть одно принципиальное свойство - они необратимы.
Если изображение уже было сжато с потерями, восстановить удаленную информацию невозможно. Еще хуже то, что потери могут накапливаться.
Например, при повторном сохранении JPEG изображение снова проходит через этап квантования. Даже если человек не внес никаких изменений в фотографию, очередное сохранение способно добавить новые артефакты.
Поэтому мастер-копию изображения разумно хранить в формате без потерь, а JPEG, WebP или другую оптимизированную версию создавать непосредственно из оригинала.
Особенно важно это для изображений с текстом. Скриншот, несколько раз пересохраненный в JPEG, может постепенно покрыться артефактами, из-за которых надписи становятся менее четкими.
Архиватор выполняет сразу две задачи, которые полезно различать.
Во-первых, он может объединить несколько файлов в один контейнер. Во-вторых, он может сжать данные внутри этого контейнера.
Например, tar в Linux в основном занимается упаковкой нескольких файлов в единый поток. Само сжатие выполняется отдельным инструментом. Отсюда появляются конструкции вроде .tar.gz.
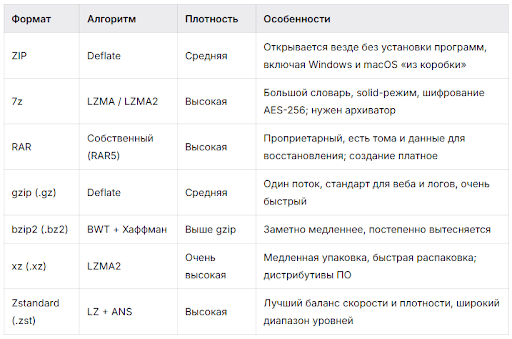
Что такое solid-архив
В обычном архиве файлы могут обрабатываться независимо. Solid-архив, характерный для 7z и RAR, рассматривает набор данных как единый поток.
Это дает существенное преимущество, если внутри находится много похожих файлов.
Представим тысячу отчетов, созданных по одному шаблону. При независимом сжатии каждого файла алгоритм не сможет использовать повторяющиеся фрагменты между ними. Solid-режим позволяет увидеть общую структуру и эффективнее убрать повторы.
Иногда выигрыш получается очень заметным.
Но есть и обратная сторона. Если требуется извлечь один файл из середины большого solid-архива, архиватору может понадобиться обработать предшествующую часть потока.
Между уровнем сжатия и временем работы нет линейной зависимости.
Переход с быстрого уровня на обычный способен дать заметную экономию места при относительно небольшом увеличении времени. А вот последние проценты экономии на максимальном уровне могут потребовать значительно больше времени и оперативной памяти.
Поэтому максимальный уровень оправдан далеко не всегда.
Если архив создается один раз, а затем распространяется или скачивается тысячи раз, дополнительное время на упаковку может быть оправдано. Для временных файлов или ежедневных резервных копий важнее скорость.
Отдельно стоит помнить о шифровании. Шифрование не является сжатием.
Наоборот, после шифрования данные становятся статистически похожими на случайный шум. Найти в них закономерности, необходимые архиватору, практически невозможно.
Поэтому нормальный порядок выглядит так: сначала данные сжимаются, затем шифруются.
Коэффициент сжатия показывает соотношение между исходным и конечным объемом.
Если файл размером 100 МБ после обработки занимает 25 МБ, коэффициент составляет 4:1.
Но этот показатель в первую очередь зависит не от конкретного архиватора, а от природы самих данных.
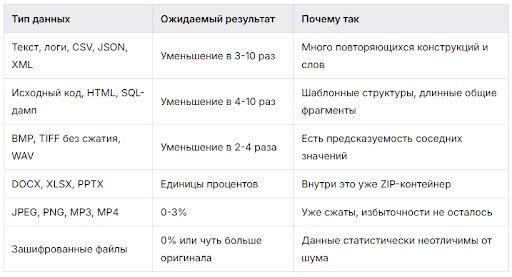
Именно поэтому архивирование фотографий часто вызывает недоумение.
Можно взять папку с отпускными фотографиями объемом 4 ГБ, создать ZIP и через несколько минут получить архив размером 3,94 ГБ.
Это не означает, что архиватор работает неправильно.
JPEG уже был создан с учетом тех закономерностей, которые можно было эффективно использовать для уменьшения изображения. Большая часть избыточности уже удалена на этапе создания фотографии в JPEG.
Архиватору практически нечего дополнительно сжимать.
В такой ситуации архив все равно может быть полезен. Например, он позволяет собрать несколько сотен файлов в один контейнер, установить пароль или разделить архив на части заданного размера.
Но для реального уменьшения фотографий нужно использовать не архиватор, а повторное кодирование изображения с подходящим разрешением и качеством.
Это же объясняет поведение современных офисных документов.
DOCX, XLSX и PPTX фактически являются контейнерами, внутри которых находятся XML-файлы, изображения и другие элементы. Если переименовать DOCX в ZIP, его внутреннюю структуру можно увидеть как содержимое архива.
Поэтому попытка дополнительно упаковать готовый DOCX в ZIP обычно дает минимальный результат.
Если офисный документ занимает слишком много места, эффективнее найти причину внутри него. Чаще всего это изображения в исходном разрешении. В таком случае помогает встроенная функция сжатия рисунков в офисном редакторе.
Наша система сама подберет вам исполнителей на услуги, связанные с разработкой сайта или приложения, поисковой оптимизацией, контекстной рекламой, маркетингом, SMM и PR.
Заполнить заявку
13755 тендеров
проведено за восемь лет работы нашего сайта.
Выбор формата напрямую зависит от содержания изображения.
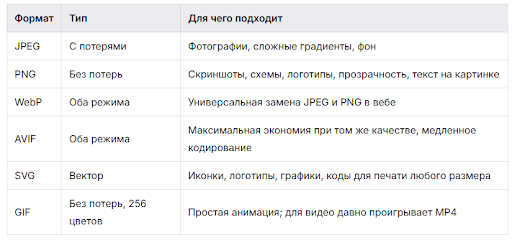
Одна из распространенных ошибок - сохранять скриншоты интерфейса в JPEG.
JPEG хорошо справляется с фотографиями, но гораздо хуже подходит для четких границ текста, интерфейсных элементов и однотонных областей. После квантования вокруг букв могут появляться артефакты, а итоговый размер при этом не обязательно будет меньше, чем у PNG.
Обратная ошибка - сохранять обычную фотографию в PNG. Поскольку PNG использует сжатие без потерь, изображение может занимать значительно больше места, чем аналогичный JPEG.
Отдельно стоит сказать о векторной графике.
SVG не хранит изображение в виде сетки пикселей. Вместо этого в нем описываются линии, кривые, фигуры, заливки и другие объекты.
Поэтому простой логотип, иконка или QR-код может занимать очень мало места и при этом оставаться идеально четким при любом увеличении.
По этой же причине при работе с QR-кодами полезно иметь векторный вариант. Например, генератор QR-кодов QRcode.website позволяет получить SVG наряду с растровым PNG. Для печатных макетов это особенно удобно: вектор можно масштабировать без появления пикселизации.
При оптимизации фотографии для веб-страницы разумно двигаться в несколько этапов.
Сначала стоит уменьшить разрешение. Если исходная фотография имеет ширину 6000 пикселей, нет смысла отправлять ее на сайт в таком размере, если область отображения занимает всего 1600 пикселей.
Для обычной веб-страницы часто достаточно ширины около 1600-2000 пикселей. Для небольших превью может хватить 600-800 пикселей.
После этого можно подобрать качество JPEG, например начать со значения около 82 и оценить результат визуально.
Следующий шаг - удаление ненужных метаданных. EXIF может содержать информацию о камере, параметрах съемки, времени и иногда координатах. Эти данные не всегда нужны посетителю сайта.
Наконец, стоит сравнить результат с WebP. При сопоставимом визуальном качестве он во многих случаях позволяет получить более компактный файл.
Сжатие используется не только для хранения файлов. Оно является важной частью работы интернета.
Когда браузер обращается к серверу, он сообщает, какие методы сжатия умеет распаковывать. Сервер выбирает подходящий вариант и отправляет содержимое в сжатом виде.
Для пользователя этот процесс практически незаметен. Браузер получает данные и распаковывает их уже на своем устройстве.
gzip долгое время был фактическим стандартом для веба. В его основе лежит алгоритм Deflate, хорошо известный по ZIP.
Brotli появился позднее и был разработан с учетом особенностей веб-контента. В него встроен словарь распространенных последовательностей, поэтому типовые фрагменты HTML, CSS и других текстовых ресурсов можно кодировать эффективнее.
На текстовых данных Brotli часто обеспечивает меньший размер по сравнению с gzip.
HTML, CSS, JavaScript, JSON и SVG в зависимости от содержимого могут уменьшаться примерно в 3-5 раз. Например, несколько сотен килобайт исходной разметки и стилей могут превратиться примерно в сотню килобайт при передаче по сети.
Для мобильного интернета такая разница особенно заметна.
При этом повторно сжимать уже сжатые данные обычно не имеет смысла. JPEG, PNG, WebP, MP4, WOFF2 и готовые архивы уже оптимизированы соответствующими методами. Дополнительный gzip практически не уменьшит их, но заставит сервер тратить вычислительные ресурсы.
Есть и интересный противоположный пример - данные иногда специально делают более избыточными.
Машиночитаемые метки, в том числе QR-коды, используют дополнительные служебные данные для коррекции ошибок. Это позволяет восстановить информацию даже в том случае, если часть кода повреждена.
Таким образом, здесь возникает компромисс между компактностью и надежностью. Например, в QR-коде можно выбрать более высокий уровень коррекции ошибок. Тогда в код добавляется больше избыточной информации, а сама метка становится крупнее.
Этот принцип особенно важен для QR-кодов с логотипами и другими элементами дизайна: подробнее о QR-кодах с логотипом и коррекции ошибок.
В QR-кодах нет обычного архиватора. Однако внутри стандарта используется похожая идея - выбор наиболее экономичного способа представления исходной информации.
Стандарт QR-кода предусматривает несколько режимов кодирования, а генератор выбирает подходящий вариант в зависимости от содержимого.
Цифровой режим - предназначен для цифр от 0 до 9. Три цифры можно представить десятью битами. Это наиболее плотный режим; в QR-коде максимальной версии помещается до 7089 цифр.
Алфавитно-цифровой режим - использует набор из 45 символов, включая заглавные латинские буквы, цифры и ряд специальных знаков. Два символа кодируются 11 битами, максимальная емкость составляет до 4296 символов.
Байтовый режим - позволяет хранить произвольные байты. Один байт занимает восемь битов, а максимальная емкость составляет до 2953 байт. В этот режим попадает, в частности, кириллица и другие данные, которые нельзя эффективно представить предыдущими наборами.
Получается интересная зависимость: одна и та же информация может занимать разное количество места в зависимости от способа кодирования.
Чем короче исходные данные и чем эффективнее выбранный режим, тем компактнее получается QR-код.
Это одна из причин, по которой для QR-кода предпочтительнее использовать короткие ссылки, а не длинные URL с большим количеством параметров.
Для практических задач также важна физическая величина модулей QR-кода. Чем больше данных нужно разместить в той же области, тем больше элементов появляется внутри кода. Каждый отдельный модуль становится меньше, и при печати или сканировании с расстояния это может снизить надежность считывания.
Связь между количеством данных, размером и расстоянием сканирования подробнее разобрана в материале о размере QR-кода для печати.
У линейных штрих-кодов подход другой. Их структура определяется конкретной символикой и имеет жесткие ограничения по объему. Например, EAN-13 рассчитан на 13 цифр, а ITF-14 - на 14.
Поэтому QR-коды и традиционные штрих-коды заметно отличаются по емкости и способам представления данных. Сравнение двух технологий приведено в материале об отличиях QR-кода и штрих-кода, а ограничения различных символик собраны в справочнике видов штрих-кодов.
По запросу «сжать файл» легко найти десятки онлайн-сервисов, которые позволяют уменьшать размер PDF, фотографий и видео непосредственно в браузере.
Для обычной картинки это может быть удобным решением. Но при работе с рабочими документами и конфиденциальной информацией есть важный нюанс.
Во многих онлайн-сервисах обработка происходит не на компьютере пользователя, а на сервере самого сервиса.
Для рекламного баннера это обычно не принципиально. Но ситуация меняется, если речь идет о договоре, скане паспорта, клиентской базе, финансовой отчетности или другой конфиденциальной информации.
Даже если сервис заявляет, что удаляет загруженные файлы через определенное время, пользователь должен самостоятельно оценивать, допустима ли такая передача данных.
Еще одна проблема - отсутствие прозрачных параметров.
Кнопка «сжать» может скрывать множество настроек: разрешение изображений, качество JPEG, используемый кодек, битрейт, параметры PDF и другие характеристики.
Особенно заметно это при работе с PDF.
Например, можно уменьшить разрешение встроенных изображений до 96-150 dpi и получить значительное уменьшение размера документа. Но если исходный PDF содержит мелкий текст, после такой обработки он может стать хуже читаемым.
Кроме того, некоторые инструменты растеризуют страницы PDF, превращая текст в изображения.
В результате документ может потерять поиск по тексту, возможность копирования реквизитов и другие полезные свойства. В отдельных случаях размер при этом даже увеличивается.
Для важных документов лучше использовать локальные инструменты.
PDF можно экспортировать с нужными параметрами непосредственно из редактора или создать новую версию через печать в PDF с подходящими настройками.
Для изображений подойдут локальные программы или встроенные функции офисных пакетов.
Несколько документов можно объединить в 7z и при необходимости защитить архив паролем - в этом случае файлы не покидают компьютер.
Для видео лучше использовать локальный кодировщик, позволяющий контролировать разрешение, битрейт и кодек.
Общее правило достаточно простое: если файл содержит персональные данные, коммерческую тайну или другую чувствительную информацию, передавать его в случайный онлайн-сервис для обработки не стоит.
Документы, таблицы, программный код, дампы баз данных - использовать только сжатие без потерь. 7z подойдет для максимальной плотности, ZIP - если важна совместимость.
Большое количество однотипных файлов - использовать 7z с solid-режимом, если важнее всего степень сжатия.
Фотографии для сайта - сначала уменьшить разрешение, затем использовать JPEG качества примерно 80-85 или WebP. Архивирование здесь практически бесполезно.
Скриншоты, схемы, логотипы и изображения с текстом - PNG или SVG. JPEG для таких задач обычно не лучший вариант.
Мастер-копии - хранить без потерь. Производные сжатые версии создавать из исходника, а не из предыдущей JPEG-копии.
Уже сжатые данные - JPEG, MP4, MP3, DOCX и готовые архивы обычно не стоит пытаться сжимать повторно.
Веб-сайт - использовать gzip или Brotli для HTML, CSS, JavaScript, JSON и SVG. Уже сжатые изображения, видео и архивы повторно сжимать не требуется.
Конфиденциальные документы - обрабатывать локально, если нет обоснованной необходимости передавать их стороннему сервису.
Сжатие данных - это не одна технология, а целая группа методов, основанных на разных принципах.
В одних случаях алгоритм ищет повторяющиеся последовательности и заменяет их ссылками. В других использует статистику появления символов. При работе с фотографиями, музыкой и видео подключаются особенности человеческого восприятия, благодаря которым можно удалить часть информации без очевидного ухудшения результата.
Главное различие, которое стоит запомнить, - сжатие без потерь сохраняет данные полностью, а сжатие с потерями сознательно отказывается от части информации ради меньшего размера.
Отсюда вытекают и практические правила. Не стоит пытаться уменьшить готовый JPEG с помощью ZIP, а DOCX - с помощью еще одного архиватора. Фотографию для сайта эффективнее уменьшить по разрешению и сохранить в подходящем формате. Документ, таблицу или исходный код нужно сжимать без потерь. Конфиденциальные файлы лучше не загружать в неизвестные онлайн-сервисы.
А при работе с QR-кодами важно учитывать не только объем данных, но и способ их кодирования, уровень коррекции ошибок и физический размер самой метки. Чем компактнее исходная информация, тем проще получить небольшой и надежно сканируемый код.
Как работает сжатие файлов простыми словами?
Алгоритм ищет повторы, закономерности и другие формы избыточности и заменяет их более компактным представлением. При сжатии без потерь исходные данные можно восстановить полностью. При сжатии с потерями часть информации удаляется.
Чем сжатие с потерями отличается от сжатия без потерь?
При сжатии без потерь после распаковки получается точная копия исходного файла. При сжатии с потерями часть информации удаляется навсегда, зато размер может уменьшиться значительно сильнее.
Почему архив с фотографиями почти не уменьшается?
Потому что JPEG, MP3, MP4 и многие другие форматы уже используют собственные алгоритмы сжатия. Архиватор не находит внутри достаточно избыточности для дополнительной экономии.
Какой формат архива сжимает лучше - ZIP, 7z или RAR?
Универсального победителя нет. ZIP выигрывает по совместимости и удобству. 7z часто обеспечивает более высокую степень сжатия благодаря LZMA/LZMA2 и большому словарю. RAR также предлагает высокую плотность и дополнительные функции, но является проприетарным форматом.
Можно ли восстановить качество после сжатия с потерями?
Нет. Если информация была удалена при сжатии, восстановить именно исходные данные невозможно. Поэтому оригиналы фотографий, аудио и видео лучше хранить отдельно.
Почему нельзя сжать любой файл еще сильнее?
Потому что сжатие работает за счет избыточности. Если данные уже достаточно компактны, зашифрованы или выглядят как случайная последовательность, алгоритм не сможет найти полезные закономерности. Иногда дополнительная упаковка даже увеличивает размер файла из-за служебной информации.