
Тендеры и лиды
Информация
700 000
Услуги
Июнь 2025
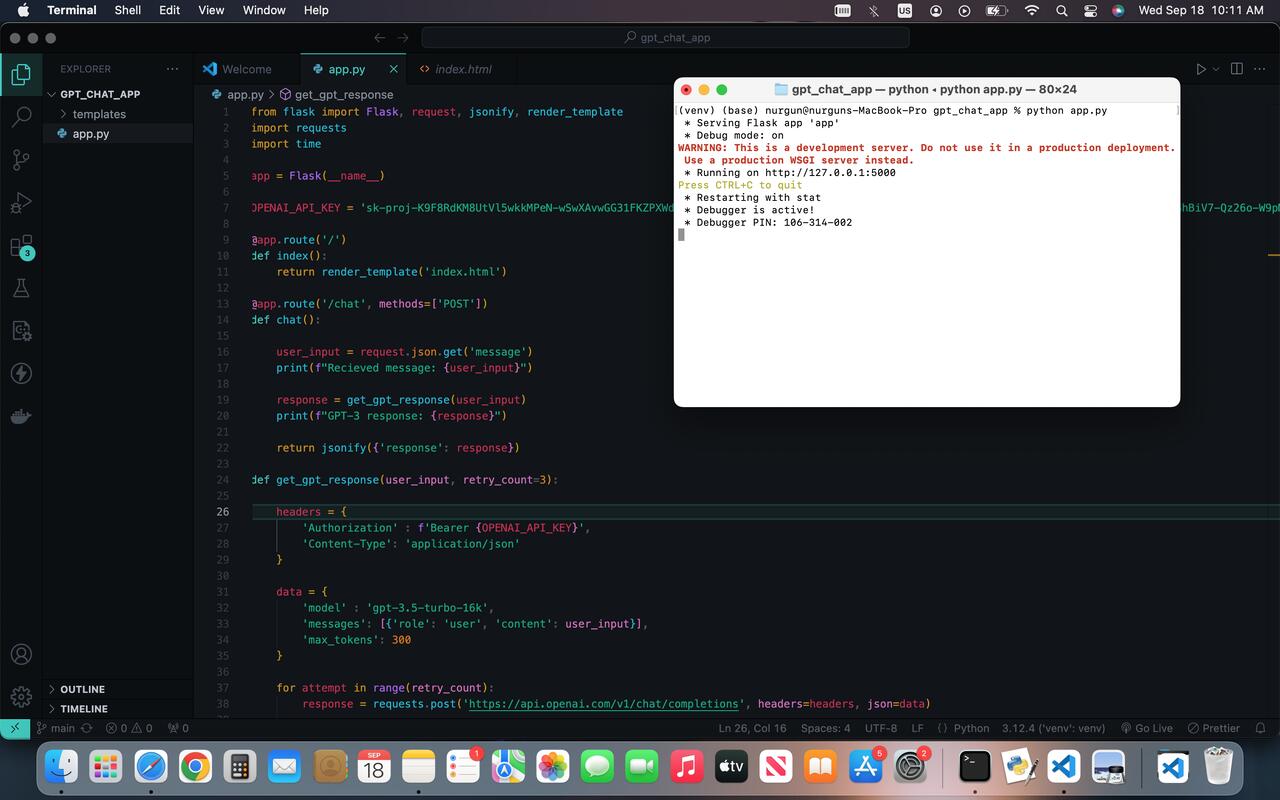
Клиент — крупная служба поддержки с потоком десятков тысяч обращений в день — хотел снизить нагрузку на операторов первой линии и ускорить ответы, но не хотел, чтобы бот «галлюцинировал» и давал клиентам неверную информацию, поэтому я построил не «чат-бота из коробки», а RAG-систему: собрал и почистил базу знаний компании (регламенты, FAQ, документацию по продуктам, историю решённых тикетов), разбил её на чанки с учётом структуры документов, построил векторный индекс с эмбеддингами и настроил пайплайн, где LLM отвечает строго на основе найденных фрагментов с указанием источника, а при низкой релевантности или неуверенности честно передаёт диалог живому оператору вместо выдумывания ответа. Отдельно я проработал безопасность и качество: фильтры на персональные данные и запрещённые темы, промпт-инжиниринг с жёсткими правилами «не знаешь — не отвечай», офлайн- и онлайн-оценку качества ответов на размеченном наборе вопросов, A/B-тест против операторов и мониторинг доли эскалаций, недовольных ответов и дрейфа базы знаний, а внедрил всё как API-сервис, интегрированный в существующую систему тикетов, с логированием каждого диалога для последующего дообучения и анализа. Через три месяца бот закрывал около 45% типовых обращений полностью без оператора, время первого ответа сократилось с нескольких часов до секунд, нагрузка на первую линию упала примерно на треть, доля эскалаций на человека держалась в пределах заданного порога, а главный вывод оказался тем же, что и в других проектах: решающий вклад дали не выбор модели, а качество и структура базы знаний, честная передача сложных случаев людям и постоянный мониторинг — именно это, а не «самая умная LLM», определило, что клиент доверил систему реальным клиентам.
Решение в проекте свелось к построению не «чат-бота из коробки», а RAG-системы: я собрал и почистил базу знаний компании (регламенты, FAQ, документацию по продуктам, историю решённых тикетов), разбил её на чанки с учётом структуры документов, построил векторный индекс с эмбеддингами и настроил пайплайн, где LLM отвечает строго на основе найденных фрагментов с указанием источника, а при низкой релевантности или неуверенности честно передаёт диалог живому оператору вместо выдумывания ответа. Отдельно проработал безопасность и качество: фильтры на персональные данные и запрещённые темы, промпт-инжиниринг с жёсткими правилами «не знаешь — не отвечай», офлайн- и онлайн-оценку качества ответов на размеченном наборе вопросов, A/B-тест против операторов и мониторинг доли эскалаций, недовольных ответов и дрейфа базы знаний, а внедрил всё как API-сервис, интегрированный в существующую систему тикетов, с логированием каждого диалога для последующего дообучения и анализа.
Через 5 месяца бот закрывал около 45% типовых обращений полностью без оператора, время первого ответа сократилось с нескольких часов до секунд, нагрузка на первую линию упала примерно на треть, доля эскалаций на человека держалась в пределах заданного порога, а главный вывод оказался тем же, что и в других проектах: решающий вклад дали не выбор модели, а качество и структура базы знаний, честная передача сложных случаев людям и постоянный мониторинг — именно это, а не «самая умная LLM», определило, что клиент доверил систему реальным клиентам.


