
 FastUp
Тендеры и лиды
Информация
С развитием ChatGPT Search, Perplexity и Google AI Overviews путь пользователя к покупке изменился. Потенциальный клиент все чаще изучает готовый синтезированный ответ нейросети прямо в интерфейсе поиска, минуя привычный переход по десятку ссылок из органической выдачи.
В агентстве FastUp мы развиваем направление оптимизации под генеративные поисковые системы — GEO. Главная задача здесь понятна: сделать так, чтобы языковая модель при ответе на коммерческий запрос назвала конкретную компанию, привела ее точные условия и сослалась на нее как на достоверный первоисточник.
В ходе работы над открытым реестром предприятий мы столкнулись с системным барьером. Когда поисковые роботы искусственного интеллекта заходят на типовую веб-страницу, они регулярно считывают структуру данных с ошибками. Мы решили проверить, как алгоритмы обрабатывают чистый формат Markdown, настроили мониторинг серверных логов и сопоставили поведение краулеров.
Ниже приводим технические замеры, результаты анализа серверных запросов и перечень методов GEO, которые реально приносят результат в 2026 году.
Поисковый ассистент обрабатывает веб-страницы иначе, чем классический краулер Яндекса или Google. Для понимания природы ошибок разберем путь документа внутри контура генерации с расширенным поиском:
Скачивание и очистка кода. Роботы OAI-SearchBot или PerplexityBot обращаются к странице в реальном времени прямо перед формированием ответа пользователю. Сырой HTML с тысячами строк вспомогательных скриптов, стилей оформления и навигационных блоков отправляется во внутренний модуль очистки. На этом шаге автоматические алгоритмы нередко ломают сложные таблицы, склеивают соседние колонки и отсекают примечания к тарифам.
Дробление текста на смысловые фрагменты. Очищенный текст разбивается на небольшие части. Алгоритм оценивает информационную плотность каждого куска. Если смысловой блок перегружен шаблонным меню или общими фразами, его вес в результирующей выборке падает.
Лимит рабочего контекста. На каждый найденный сайт у модели отведен жесткий бюджет оперативной памяти в токенах. Если документ длинный и содержит много служебного мусора, полезная фактура в нижней части страницы просто отсекается.
Синтез ответа и расстановка ссылок. Модель формулирует финальный текст и определяет надежные источники для кликабельных сносок. Алгоритм цитирует страницы, где связь между сущностью компании, ее услугой и реквизитами абсолютно однозначна.
Чтобы исключить непредсказуемый этап очистки тяжелого HTML, мы реализовали серверную отдачу чистого структурированного Markdown.
Чтобы поисковые агенты находили текстовую версию документа по открытым веб-стандартам, мы связали четыре механизма:
Указатель в заголовке HTML. В блоке head каждой страницы прописан стандартный альтернативный адрес:<link rel="alternate" type="text/markdown" href="https://example.by/company.md">.
Служебный заголовок ответа сервера. При отдаче страницы сервер передает заголовок Link со значением rel="alternate" и типом text/markdown.
Согласование формата по запросу. Если поисковый бот обращается к стандартному адресу страницы с заголовком Accept: text/markdown, сервер сразу отдает подготовленный документ Markdown без лишних перенаправлений.
Манифест структуры сайта. В корневом каталоге домена опубликован файл llms.txt, где описана архитектура разделов и заданы прямые пути к текстовым документам.
Визуальная версия сайта для живых пользователей осталась полностью привычной: интерфейс не перегружен служебными ссылками, а сложные реестровые данные аккуратно структурированы.
Для проверки гипотезы мы развернули внутренний журнал мониторинга обращений роботов. Сервер проверяет IP-адреса по официальным диапазонам подсетей OpenAI и фиксирует имя каждого краулера: OAI-SearchBot, ChatGPT-User и GPTBot.
Роботы регулярно скачивают Markdown. В журналах сервера зафиксированы стабильные прямые запросы от краулеров OAI-SearchBot и GPTBot к файлам с расширением .md.
Механизм связывания работает штатно. Краулер считывает строку rel="alternate" в первичном HTML и затем самостоятельно обращается к текстовой версии документа.
Отсутствие промежуточных искажений. Поисковый агент забирает чистые факты напрямую, минуя рискованную стадию вырезания верстки.
Обращения к файлу llms.txt. Несмотря на скепсис части рынка, логи показывают систематические визиты к файлу llms.txt со стороны краулеров Perplexity и независимых исследовательских агентов.
Наша система сама подберет вам исполнителей на услуги, связанные с разработкой сайта или приложения, поисковой оптимизацией, контекстной рекламой, маркетингом, SMM и PR.
Заполнить заявку
13836 тендеров
проведено за восемь лет работы нашего сайта.
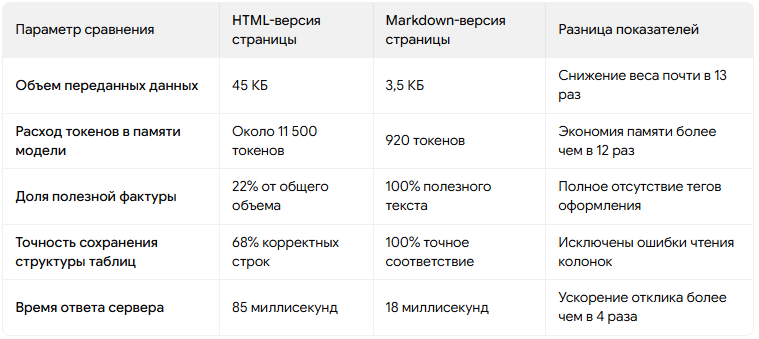
При одновременном замере одной и той же страницы организации получены следующие показатели:
Различные генеративные платформы работают по разным инженерным сценариям:
В Google AI Overviews: Наличие Markdown не является решающим фактором. Google опирается на собственную распределенную инфраструктуру рендеринга на базе Chromium. Здесь главную роль играют семантическая верстка, прямой ответ на вопрос сразу под заголовком H1 и связанный граф микроразметки Schema.org.
В ChatGPT Search и Perplexity: Преимущество получают документы с чистым Markdown. Модели извлекают информацию в условиях строгих лимитов времени и оперативной памяти. Текст без визуального шума дает алгоритмам максимальную уверенность в достоверности данных и выводит компанию в блок цитируемых источников.
Опыт наших экспериментов и замеры сотен генеративных ответов показывают, что механические накрутки и закупка ссылочной массы под нейросети больше не дают эффекта.
Ниже собран список методов генеративной оптимизации, которые подтвердили свою эффективность на практике:
Для языковой модели информация на собственном сайте компании остается непроверенным самоописанием. Алгоритм не может быть уверен, что заявленные услуги, допуски и стаж соответствуют реальности.
Решением проблемы доверия выступает цифровой паспорт компании — открытый структурированный профиль организации в независимом отраслевом реестре. Паспорт привязывается к уникальному налоговому номеру организации — УНП или ИНН, подтверждает официальные права на домен и фиксирует реальные прикладные специализации вместо формальных кодов из государственной выписки. Для поисковых нейросетей это главный эталон истины, снимающий риск галлюцинаций.
Поддержка заголовка Accept: text/markdown и указание альтернативной ссылки rel="alternate" позволяют краулерам реального времени забирать фактуру без потерь. Это снижает расход контекстного окна нейросети более чем в десять раз и гарантирует корректное считывание прайс-листов и таблиц параметров.
Генеративные модели безжалостно отбрасывают рекламные прилагательные вроде «лидер рынка», «динамично развивающаяся компания» или «высокое качество». В ответы попадают документы, насыщенные конкретикой: точные марки оборудования, ГОСТы, диапазоны цен, сроки производства, условия гарантийного обслуживания и подтвержденные города присутствия.
Когда пользователь просит ассистента подобрать компанию, соблюдающую сроки монтажа или условия поставки, модель анализирует социальное подтверждение. Если отзывы закрыты динамическими скриптами или спрятаны внутри мобильных приложений, поисковый агент видит только общий рейтинг. Для уверенной рекомендации нейросети необходим доступный для прямой индексации текст отзывов с упоминанием конкретных выполненных задач.
При обработке сложных составных запросов модель запускает веер подзапросов Query Fan-Out и в первую очередь обращается к авторитетным отраслевым подборкам и рейтингам. Присутствие компании в экспертных списках формирует базовый уровень доверия, необходимый для включения в итоговый синтезированный ответ.
Все цифровые точки присутствия бизнеса должны быть объединены в непротиворечивую структуру. В коде микроразметки официального сайта через свойство sameAs связываются профиль организации в независимом реестре цифровых паспортов, карточки на картах и страница в профессиональных рейтингах.
Оптимизация под генеративные поисковые системы — это не попытка перехитрить алгоритмы текстовыми файлами, а инженерная работа с доступностью и качеством данных.
Прямая отдача Markdown решает проблему технического считывания информации краулерами OpenAI и Perplexity, экономя бюджет памяти моделей. А связка сайта с верифицированным цифровым паспортом компании в независимом реестре дает алгоритмам доказательную базу, необходимую для уверенной рекомендации бизнеса потенциальным клиентам.