

Тендеры и лиды
Информация
На демо почти любая система речевой аналитики выглядит убедительно.
AI расшифровывает звонок, находит возражение, ставит оценку менеджеру и показывает график.
Но бизнесу нужен не красивый разбор трех разговоров.
Ему нужно понять:
сможет ли система находить полезные закономерности именно в наших коммуникациях?
Ответ на этот вопрос должен дать пилот.
Плохая цель:
Протестировать речевую аналитику.
Хорошая:
Понять, почему квалифицированные лиды не доходят до встречи.
Или:
Проверить, насколько менеджеры отрабатывают ценовые возражения.
Или:
Найти причины повторных обращений в поддержку.
DEERAY рекомендует начинать внедрение именно с одной конкретной цели, а не пытаться сразу анализировать все возможные показатели. Deeray
Пилот на подготовленных поставщиком примерах почти ничего не доказывает.
Нужны собственные коммуникации.
Причем не только хорошие.
В выборке должны оказаться успешные сделки, отказы, «клиент думает», плохая запись, сложные возражения и типичные сотрудники.
На практике разумнее получить несколько сотен разноплановых разговоров, чем тысячи однотипных.
Цель — проверить качество выводов, а не устроить нагрузочный тест.
Для первого теста достаточно нескольких действительно важных признаков.
Например:
выявлена ли потребность;
правильно ли квалифицирован клиент;
возникло ли возражение;
отработал ли его менеджер;
был ли следующий шаг.
Когда критериев сразу несколько десятков, становится сложно понять, где сама система работает хорошо, а где плохо настроена методология.
DEERAY в своем алгоритме внедрения также рекомендует сначала минимальный набор правил, а расширять аналитику уже после проверки пилота. Deeray
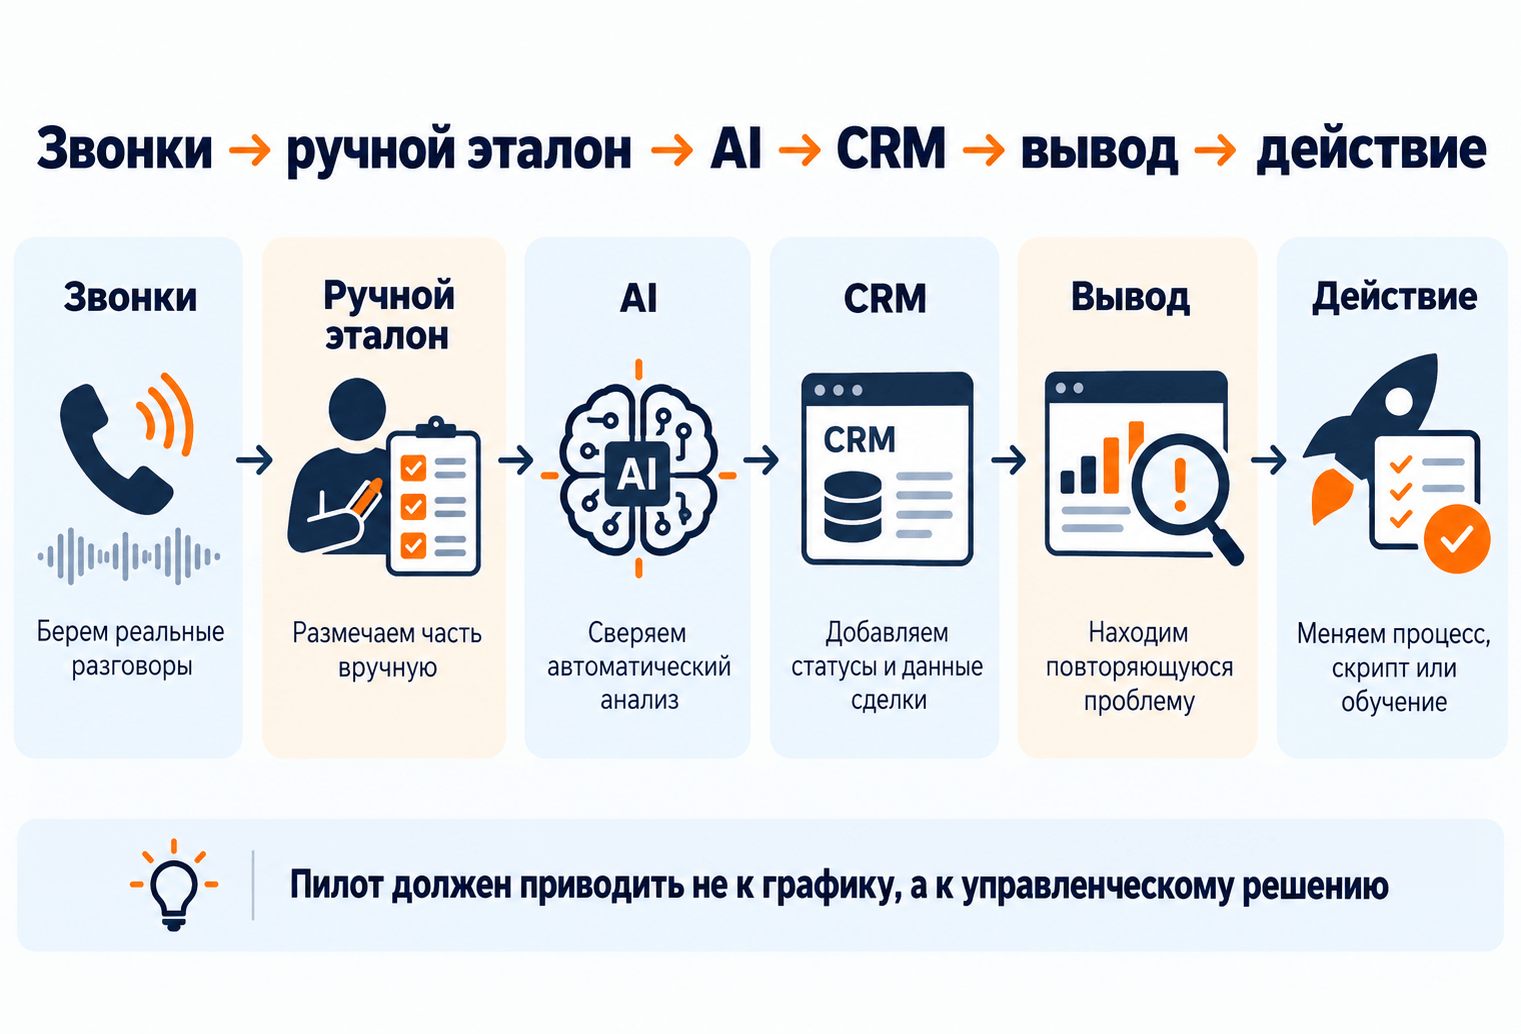
AI нужно с чем-то сравнивать.
Возьмите часть тестовой выборки и попросите опытного руководителя вручную отметить правильные ответы.
Например:
Возражение было — да.
Потребность выявлена — нет.
Следующий шаг назначен — да.
Получается небольшая контрольная разметка.
После этого можно увидеть реальные ошибки системы: где она пропускает нужное событие, а где, наоборот, находит то, чего в разговоре нет.
Без такого эталона фраза «точность AI высокая» практически бессодержательна.
Наша система сама подберет вам исполнителей на услуги, связанные с разработкой сайта или приложения, поисковой оптимизацией, контекстной рекламой, маркетингом, SMM и PR.
Заполнить заявку
13757 тендеров
проведено за восемь лет работы нашего сайта.
Один разговор дает только часть картины.
Если возможно, к звонку стоит добавить:
стадию сделки;
результат;
причину отказа;
ответственного менеджера;
источник лида.
Тогда можно проверять не только:
нашел ли AI возражение?
Но и:
связано ли это возражение с потерянными сделками?
Именно такой подход использовался, например, в проекте сети медицинских клиник: параметры разговоров сопоставляли с записью и доходимостью пациента, а затем определяли зоны для дальнейшей работы. Deeray
После пилота должен появиться хотя бы один вывод уровня:
32% потерянных сделок заканчиваются без конкретного следующего шага.
Или:
менеджеры хорошо презентуют продукт, но системно плохо работают с ценовым возражением.
Или:
статус «нецелевой» в CRM часто не совпадает с содержанием разговора.
Вот это полезный результат.
Если пилот заканчивается выводом:
система обработала 500 звонков и средняя оценка составляет 74 балла,
то бизнес пока ничего не получил.
Пилот должен пройти цепочку:
данные → вывод → действие.
В рекомендациях DEERAY пилот прямо рассматривается как проверка гипотезы: можно ли на основе анализа обнаружить проблему, принять решение и затем проверить изменение процесса. Deeray
Когда понятно, что система дает полезный сигнал, можно считать стоимость масштабирования.
Сколько минут будет анализироваться ежемесячно?
Можно ли исключать нерелевантные разговоры?
Нужны ли чаты и email?
Что стоит интеграция?
Потребуется ли On-Premise?
Сколько времени команды уйдет на сопровождение?
И главное:
сколько стоит проблема, которую система помогает решить?
Если ежемесячно теряются десятки крупных сделок из-за одной повторяющейся ошибки, экономика будет одной.
Если нужно автоматически проверить формальное приветствие у пяти менеджеров — совсем другой.
Неудача — это не только ситуация, когда AI плохо распознает речь.
Гораздо важнее другое.
Если система работает технически, но после теста никто не понимает, что изменить в бизнесе, пилот тоже не достиг цели.
В таком случае проблема может быть в выбранной платформе, критериях, данных или самой постановке задачи.
И лучше выяснить это до годового контракта.
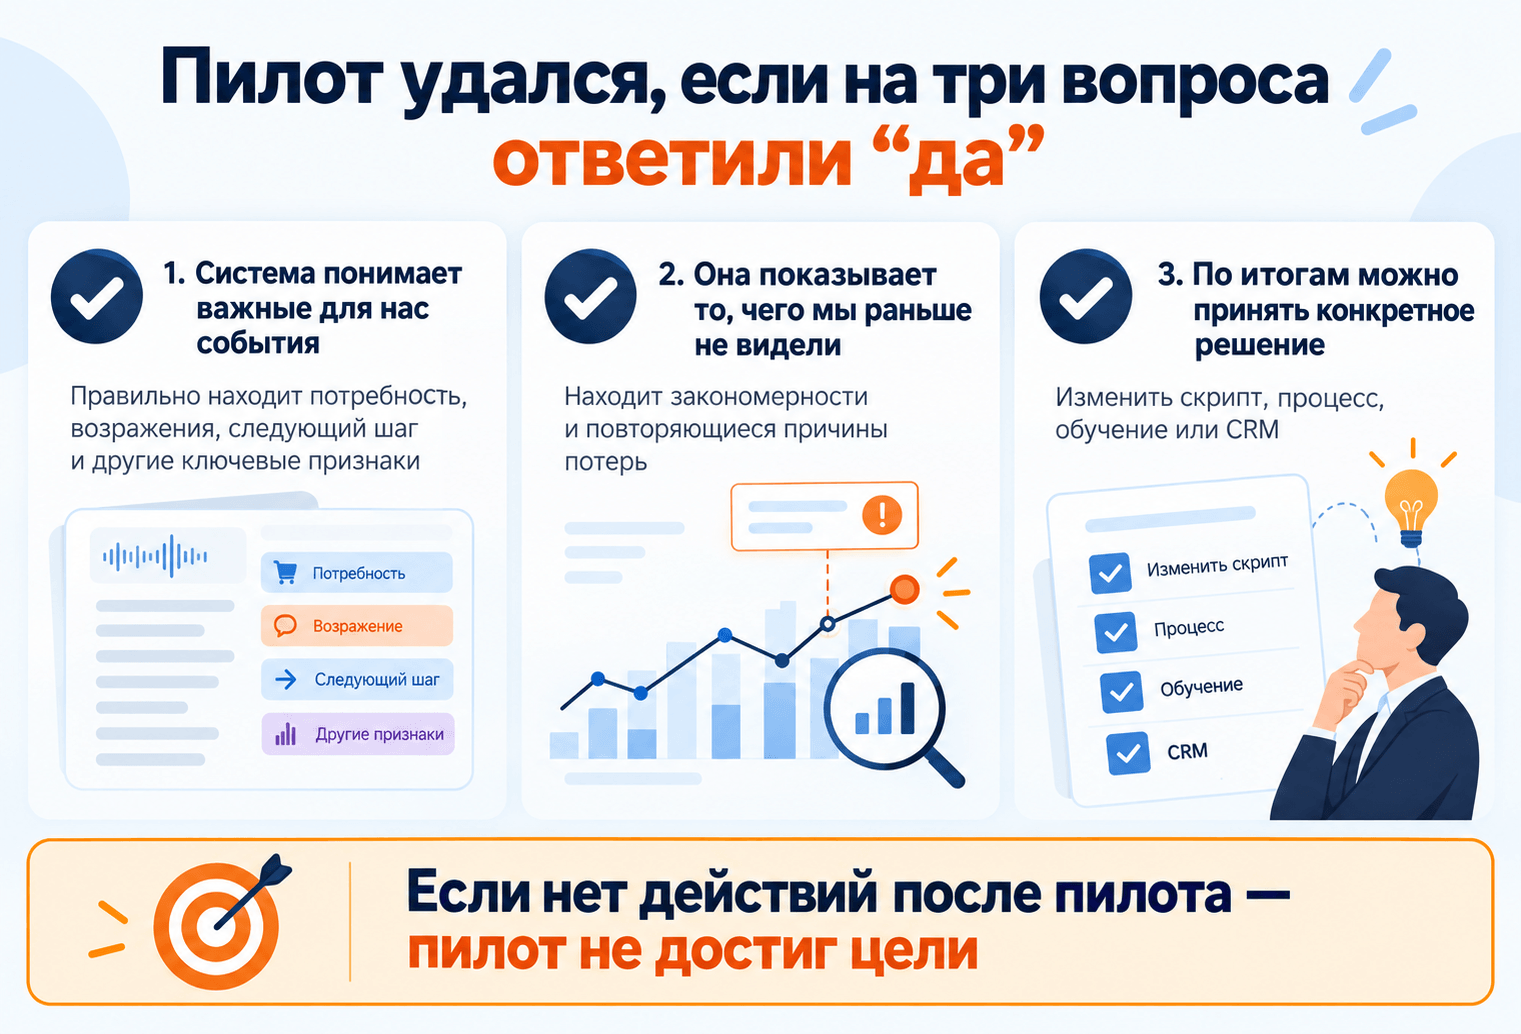
Хороший пилот речевой аналитики проверяет не наличие AI.
Он отвечает на три вопроса:
Система правильно понимает важные для нас события?
Она находит то, чего мы раньше не видели?
Мы можем принять на основе этого конкретное решение?
Если три ответа положительные — можно обсуждать масштабирование.
Если нет — количество графиков и LLM в презентации уже не имеет большого значения.