

 Efimov Dev
Тендеры и лиды
Информация
Статья для владельцев сайтов и маркетологов, у которых сайт собран на React, Vue или в нейросетевом конструкторе вроде Lovable, а в поиске его почти нет. И для тех, кто только выбирает, на чём делать сайт, и хочет заранее понимать, во что это обойдётся по SEO.
Ниже - шесть проблем, на которые мы наткнулись на реальных проектах: сайт детского хоккейного клуба, сайт строительной компании, многоязычный каталог. Для каждой - как проверить самому и как чинится.
Такие сайты устроены как приложение. Сервер отдаёт браузеру почти пустую страницу и скрипт, а уже скрипт рисует меню, тексты и подтягивает данные из базы. Человек разницы не видит: через секунду всё на месте.
Поисковый робот видит другое. Часто ему достаётся только <div id="root"></div> - ни текста, ни расписания, ни услуг. Google умеет запускать скрипты, но делает это с задержкой и не всегда. Яндекс справляется заметно хуже, и для бизнеса в России это главная проблема. ИИ-боты, которые собирают ответы для чат-ассистентов, скрипты обычно не исполняют вообще.
Откройте любую страницу и нажмите Ctrl+U. Если в исходном коде нет текста, который вы видите на экране, робот его тоже не видит.
В Яндекс Вебмастере: «Инструменты», затем «Проверка ответа сервера». Там видно, какой HTML получает робот.
В Google Search Console: «Проверка URL», затем «Посмотреть просканированную страницу».
Введите в адресной строке выдуманный адрес на своём домене, например /test-404-qwerty. Если открылась нормальная страница сайта, а не ошибка, у вас вторая проблема из списка ниже.
Это корень остальных бед. Есть три пути.
Переписать на серверный рендеринг. Самый правильный способ: страницы собираются на сервере, робот сразу получает готовый HTML. Но это переделка проекта, а если сайт уже работает и исходники живут в конструкторе, путь долгий.
Подключить сервис пререндера. Есть платные сервисы, которые отдают роботам заранее отрисованные копии страниц. Работает, но это ежемесячный платёж и ещё одна внешняя зависимость.
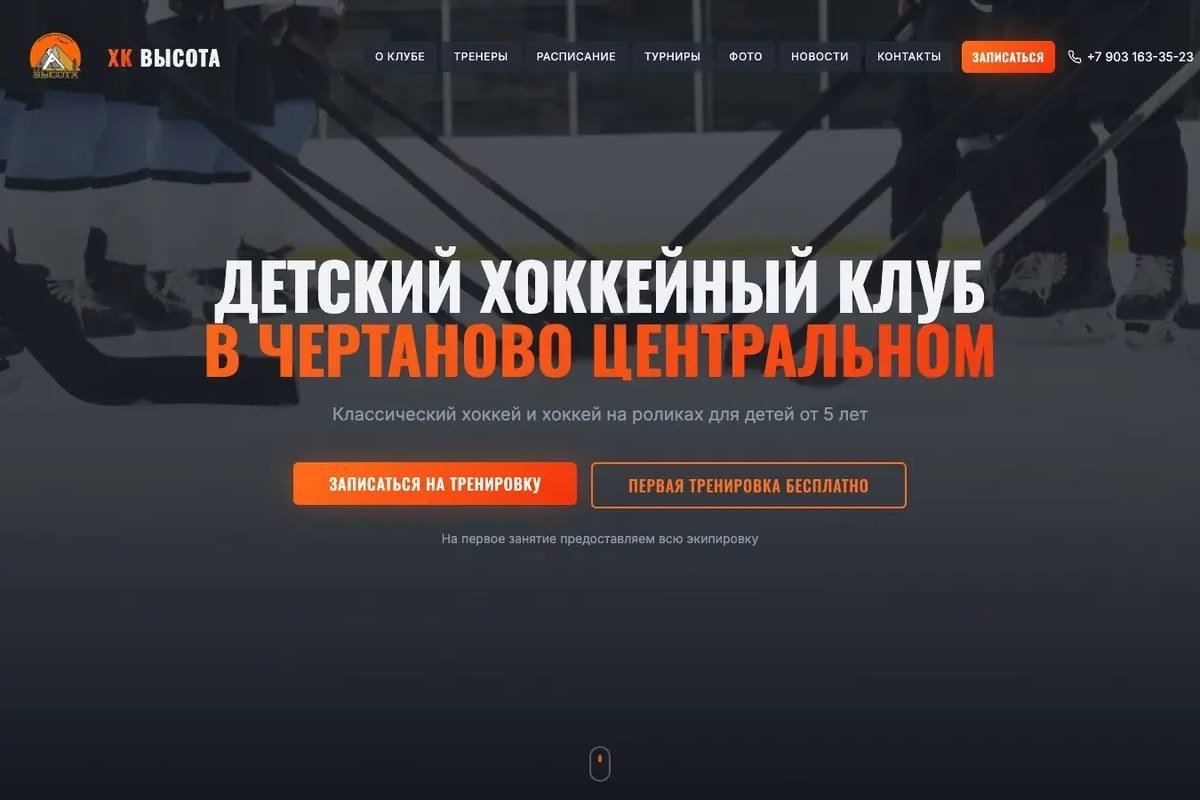
Сделать пререндер самим. Так мы сделали для сайта хоккейного клуба «Высота»: его собрали за три дня в Lovable, и переписывать работающий сайт не было смысла. Схема:
На сервере раз в сутки запускается Chrome без окна.
Он открывает каждую страницу сайта, ждёт, пока скрипт дорисует содержимое, и сохраняет готовый HTML.
Веб-сервер отдаёт этот HTML. Для человека ничего не меняется: дальше страница оживает как обычно.
Клуб продолжает работать в той же админке, интерфейс не трогали, а роботы получают страницы с текстом.
У одностраничных приложений типичная настройка сервера - «на любой адрес отдавай главный файл». В итоге /blog, /contacts и /qwerty123 отвечают кодом 200. Для поисковика это сотни «страниц» с одинаковым содержимым. Яндекс Вебмастер прямо пишет, что отображение несуществующих страниц настроено некорректно.
На сайте строительной компании мы перечислили разрешённые адреса белым списком в настройках сервера. Всё, чего в списке нет, получает настоящий код 404, но с фирменной страницей ошибки - человек видит не голую надпись, а нормальную страницу с меню.
У этого решения есть цена, о которой стоит договориться заранее. Каждая новая страница сайта теперь требует четыре шага:
маршрут в самом приложении;
адрес в белом списке сервера;
адрес в sitemap.xml;
адрес в llms.txt, если вы работаете на ИИ-поиск.
Пропустили второй шаг - новая страница отдаёт 404. Пропустили третий и четвёртый - её не найдут роботы. Мы держим это как чек-лист на каждую страницу.
В исходной сборке сайта клуба у всех страниц были одинаковые title, description и адрес в разметке canonical. Для поисковика это сигнал, что страницы дублируют друг друга.
Чинится вместе с пререндером: скрипт, который сохраняет HTML, заодно прописывает каждой странице свой заголовок, описание и адрес. Важная деталь - править это нужно в скрипте, а не руками в готовых файлах. Иначе следующий прогон всё перезапишет.
Наша система сама подберет вам исполнителей на услуги, связанные с разработкой сайта или приложения, поисковой оптимизацией, контекстной рекламой, маркетингом, SMM и PR.
Заполнить заявку
13818 тендеров
проведено за восемь лет работы нашего сайта.
Если статьи и посадочные страницы живут внутри React-приложения, у них все проблемы выше сразу. Для контентных разделов надёжнее вынести их из приложения в обычную статику.
На сайте строительной компании внешнее SEO-агентство писало статьи, но публиковать их было некуда без разработчика. Мы сделали небольшой API: агентство отправляет статью в Markdown по защищённому ключу, а сайт сам собирает из неё готовую HTML-страницу блога. Так же статикой сделали посадочные под четыре направления: ИЖС, ангары, теплицы, склады. Приложение их не касается, робот получает полноценный HTML с первого запроса.
Одна мелочь, которая ломает такую схему: ссылки из приложения на статические разделы нужно ставить обычными ссылками, а не внутренними переходами роутера. Иначе приложение попытается открыть статью у себя и покажет пустой экран или 404.
Пререндер решает главную проблему, но приносит свои. Вот что мы поймали на практике.
В поиск уходит «Загрузка...». Chrome иногда сохранял страницу раньше, чем приходили данные из базы, особенно новости. Решение: скрипт ищет эту надпись в результате и пробует снова, до пяти раз. Если не вышло - старую готовую копию не трогает, лучше вчерашняя страница, чем пустая.
Свежая новость падает в 404. Клуб публикует новость днём, а пререндер пройдёт только ночью. Для раздела новостей и админки оставили запасной вариант: если готовой копии ещё нет, отдаётся обычная версия сайта. Для всех остальных выдуманных адресов - настоящая 404.
Новая версия сайта ломает старые копии. Когда в конструкторе выкладывают новую сборку, сохранённые страницы ссылаются на файлы, которых уже нет. После каждой пересборки фронта пререндер надо прогонять сразу, а не ждать ночи.
Роботу одно, браузеру другое. Иногда готовую копию отдают только известным ботам по User-Agent, а людям - обычное приложение. В одном каталоге мы так нашли, что ботам уходит нормальный снимок, а обычному браузеру и curl - сырые шаблоны с фигурными скобками и один заголовок на 24 карточках товаров. Правило: проверять сайт дважды, с User-Agent Googlebot и обычным браузером, и сравнивать title, description и canonical.
ИИ-боты забыты. Если копии отдаются по списку ботов, в список нужно добавить GPTBot, ClaudeBot, PerplexityBot и похожих. Они скрипты не исполняют, и без снимка видят пустую страницу.
На хостинге такие сайты часто правят руками: вставили счётчик Метрики в index.html, добавили тег подтверждения Вебмастера. Потом кто-то пересобирает проект «как есть», и правки молча пропадают. Узнают об этом по обвалу статистики.
Всё, что вписали руками на сервере, нужно перенести в исходники проекта. А после каждой выкладки проверять, что счётчик на месте.
После переезда базы клуба на свой сервер страницы открывались, но без расписания и тренеров. В базе всё было на месте. Оказалось, у поддомена, с которого сайт берёт данные, не было записи в DNS: сайт грузился, а запросы к данным уходили в никуда. Теперь, если контент пропал, мы первым делом проверяем DNS, а не базу.
Сайт только проектируется и должен приводить людей из поиска - сразу серверный рендеринг или статика
Сайт работает, исходники в конструкторе, переписывать дорого - свой пререндер по расписанию
Есть блог или посадочные под рекламу и SEO - вынести их в статику вне приложения
Нет времени и рук на поддержку своего скрипта - платный сервис пререндера
Ctrl+U на трёх разных страницах: текст есть в исходном коде?
Проверка ответа сервера в Яндекс Вебмастере показывает полноценный HTML?
Выдуманный адрес отдаёт код 404?
У каждой страницы свой title, description и canonical?
Новости, каталог, расписание, то есть всё, что приходит из базы, видны роботу?
Сайт одинаково выглядит для Googlebot и обычного браузера?
В списке получателей снимков есть ИИ-боты?
Счётчик Метрики и теги Вебмастера живут в исходниках, а не только на сервере?
Если хотя бы на два пункта ответ «нет», индексация будет буксовать, сколько бы статей вы ни написали. Хорошая новость: почти всё из списка чинится без переписывания сайта.