
Тендеры и лиды
Информация
1 000 000
Торговля
Июль 2023
задача классификации товаров для торговли
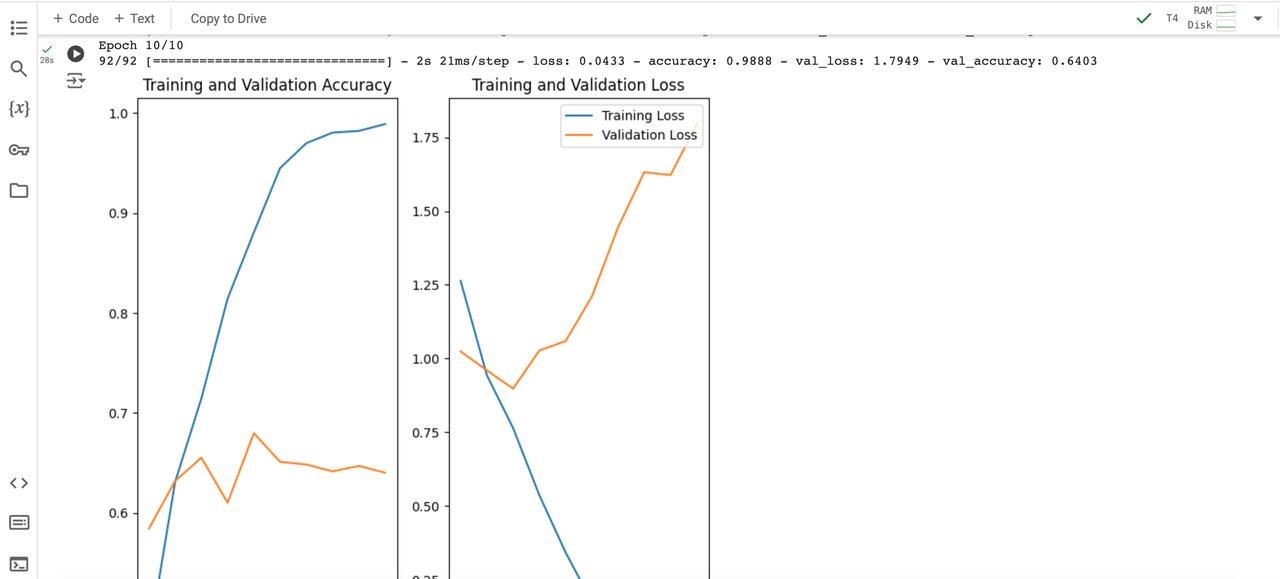
Клиент — сеть электроники «ТехноМаркет» — вручную раскладывал 40 000 SKU по категориям Wildberries, Ozon и Яндекс.Маркета, тратя на это неделю после каждого обновления ассортимента, причём около 20% карточек попадали не в ту категорию и теряли продажи. Я начал не с модели, а с аудита данных: описания у 30% товаров были куцыми, бренды записаны вразнобой, атрибуты отсутствовали, поэтому первые две недели ушли на нормализацию каталога и ручную разметку 3000 товаров как «золотого стандарта» — это спасло проект от обучения на мусоре. Дальше я пошёл от простого к сложному: бейзлайн TF-IDF + логистическая регрессия дал ~87%, fine-tuned RuBERT поднял точность до 92%, а добавление эмбеддингов изображений помогло различать визуально похожие аксессуары вроде чехлов и защитных стёкол. Вместо «полной автоматизации», которую просил клиент, я убедил его внедрить трёхуровневую схему: высокая уверенность (>0.9) — автопринятие (70% каталога), средняя (0.6–0.9) — топ-3 подсказки с подтверждением менеджером (25%), низкая — ручная разметка (5%), а саму модель обернул в FastAPI-сервис, интегрированный с PIM-системой. Через три месяца время раскладки каталога сократилось с недели до нескольких часов, доля ошибочных категорий упала с 20% до 4%, продажи по трём проблемным группам выросли на 12–18%, а ручная разметка — на 80% меньше; главный вывод: решающий вклад дал не выбор модели, а наведение порядка в данных и готовность говорить клиенту «нет» ради качества результата.
Через три месяца после внедрения время раскладки каталога на маркетплейсы сократилось с недели до нескольких часов, поскольку 70% карточек теперь классифицируются автоматически, а менеджер лишь подтверждает топ-3 подсказки для ещё 25%; доля товаров, попавших не в ту категорию, упала с ~20% до ~4%, продажи по трём проблемным группам (аксессуары для смартфонов, комплектующие для ПК и товары для умного дома) выросли на 12–18% просто за счёт видимости в правильных разделах, а объём ручной разметки сократился примерно на 80%, при этом главным драйвером результата оказался не выбор модели, а наведение порядка в данных и честная разметка «золотого стандарта» — именно это, а не модный алгоритм, определило успех проекта.
 Coffeelogia — интернет-магазин кофе и SEO в топ-10 по Астане
Как мы перезапустили сайт компании с помощью ИИ-агентов за 33 часа

