
Тендеры и лиды
Информация
Информационные технологии и интернет
Июль 2026
Для длительных AI-процессов было недостаточно просто запустить одну локальную модель.
Разные задачи предъявляют разные требования: где-то нужен сильный reasoning, где-то — качественная генерация текста, где-то — работа с длинным контекстом, где-то — vision или компрессия контекста. При этом локальная инфраструктура ограничена доступной GPU-памятью и должна оставаться стабильной при переключении между моделями и длинных сессиях.
Задача состояла в том, чтобы собрать единый локальный AI-runtime, через который разные проекты смогут обращаться к специализированным моделям как к общей инфраструктуре, не привязываясь к одному облачному провайдеру и не передавая все данные наружу.
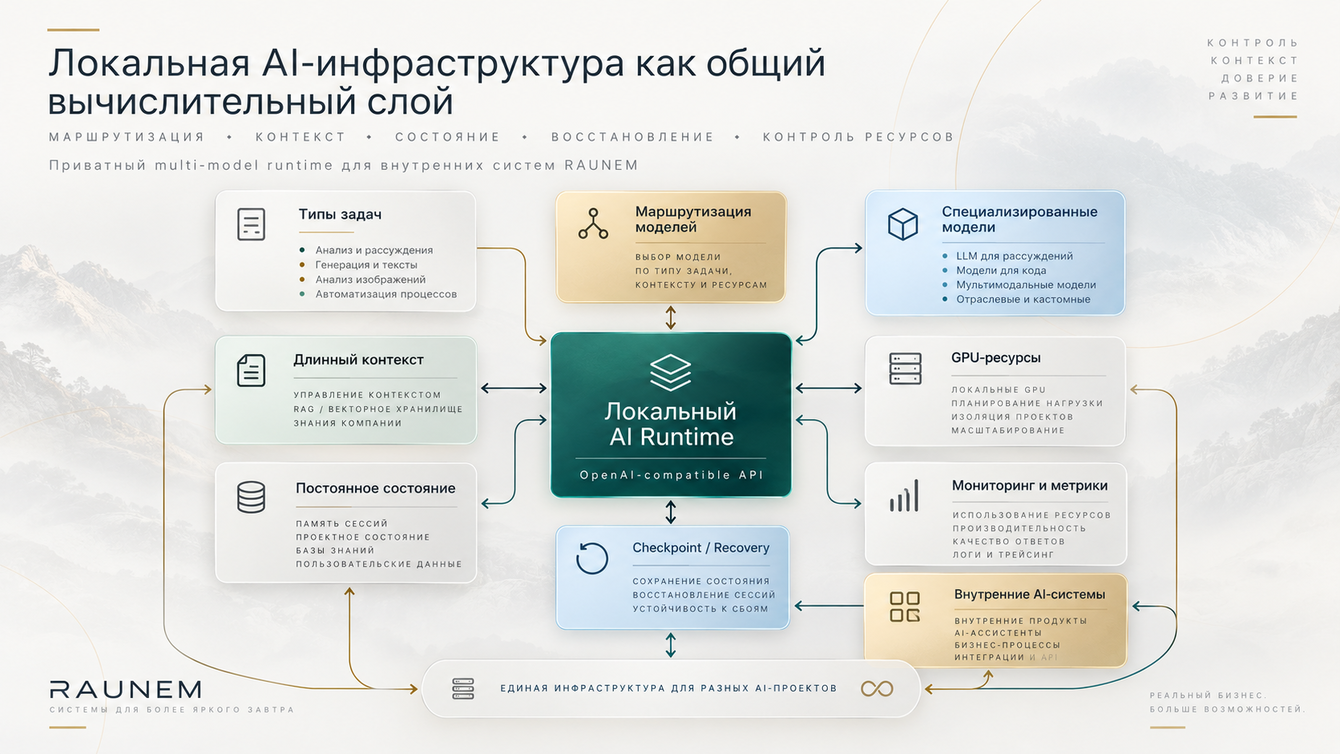
Построил единый OpenAI-compatible локальный runtime поверх llama.cpp с маршрутизацией между специализированными моделями.
Архитектура разделяет несколько классов нагрузки:
— general/reasoning задачи;
— software-engineering и архитектурный анализ;
— writing и редакторские задачи;
— vision/context/compression задачи.
Для разных моделей используются отдельные профили контекста, GPU-размещения и параметров inference.
На уровне runtime реализованы:
— единая OpenAI-compatible точка доступа;
— multi-model routing;
— GPU-backed inference;
— динамическая загрузка и выгрузка моделей в зависимости от задачи;
— ограничение одновременной загрузки, чтобы исключить конкуренцию за VRAM;
— длинный контекст для сложных инженерных сессий;
— checkpoint/recovery и сохранение состояния длинных процессов;
— project-scoped контекст и работа между несколькими сессиями;
— metrics и наблюдаемость runtime.
Инфраструктура построена так, чтобы разные AI-системы могли использовать её как общий inference backbone, а выбор конкретной модели оставался внутренней деталью реализации.
В результате появилась единая локальная AI-инфраструктура, которую можно использовать как общую вычислительную основу для разных проектов.
Вместо запуска отдельных моделей вручную каждая система обращается к совместимому API и получает подходящий inference-контур под свой тип задачи.
Это позволяет:
— использовать локальные модели для чувствительных данных;
— выбирать более подходящую модель под конкретную нагрузку;
— поддерживать длинные сессии и большие контексты;
— переносить часть нагрузки с облачных AI-сервисов на собственное оборудование;
— сохранять контроль над конфигурацией, стоимостью и поведением inference;
— строить длительные AI-workflows, которые не зависят от одной интерактивной сессии.
Runtime используется как инфраструктурная основа для внутренних AI-проектов RAUNEM и Fintehplus.

Сергей Боровков
Россия Воронеж
Главный вывод этого проекта — локальный AI имеет смысл не тогда, когда пытаешься просто заменить облачную модель локальной.
Реальная ценность появляется, когда локальные модели становятся частью общей архитектуры: разные модели решают разные типы задач, а бизнес-система работает через стабильный интерфейс и не зависит от конкретной модели.
Поэтому здесь важнее не название модели, а маршрутизация нагрузки, управление контекстом, состояние долгих процессов и возможность заменять компоненты без перестройки всей системы.
 MAX Mini App для 17 управляющих компаний: сервис жителя с интеграцией 1С:ЖКХ
Grib.Map — редизайн UX/UI мобильного приложения для iOS


