

Тендеры и лиды
Информация
С 1 сентября 2026 года в России начал работать первый закон об искусственном интеллекте. Имеется в виду Федеральный закон от 26 июля 2026 года № 243-ФЗ «О поддержке развития технологий искусственного интеллекта в Российской Федерации». В тексте ниже: что в нём действительно написано, что заработает позже и откуда взялись самые громкие ошибки в пересказах.
За полтора месяца после появления закона вышли сотни заметок, и многие пересказывают вовсе не его. Одни пишут про обязательную маркировку контента от нейросетей, хотя такой нормы в документе нет. Другие ждут запрета ChatGPT, о котором там не сказано ни слова.
А ещё повторяют 675 тысяч «преступлений с дипфейками» за 2025 год. Цифра взята из пояснительной записки к законопроекту и считает вообще все преступления в сфере ИТ, а не только дипфейки.
Текст я прочитал полностью и сверил две независимые публикации между собой: расхождений не нашлось, они совпали дословно. Потом открыл карточку законопроекта в думской базе и сравнил её с мартовской версией Минцифры, чтобы увидеть, что из той версии выпало по дороге. Отдельно разобрал два законопроекта, внесённых уже после подписания, а также официальные отзывы правительства и Верховного суда. Подзаконную часть собирал по материалам «Коммерсанта», «Ведомостей» и ComNews: окончательных постановлений в открытом доступе до сих пор не опубликовано.
Всё сказанное ниже верно на 17 октября 2026 года. Юристом я не работаю, и этот текст не заменит консультацию специалиста. Зато любую фразу о законе вы сверите по номеру статьи.
Пять пунктов ниже покрывают почти всё содержание документа.
Закон рамочный и узкий. Под действие попадают только большие базовые модели. Это модели от миллиарда параметров, рассчитанные на множество разных задач и пригодные как основа для другого софта. Под регулирование не попадают небольшие модели, распознавание лиц, антифрод и кредитный скоринг.
Главное содержание закона составляют два статуса. Минимум один из них, суверенная модель, полностью своя и размещена в дата-центрах внутри России. Второй статус, национальная модель, тоже за российской компанией, однако собирать её разрешено из чужих компонентов с открытой лицензией. Тот и другой статус дают меры господдержки, доступ к данным государства и разрешение учиться на чужих произведениях, не спрашивая авторов.
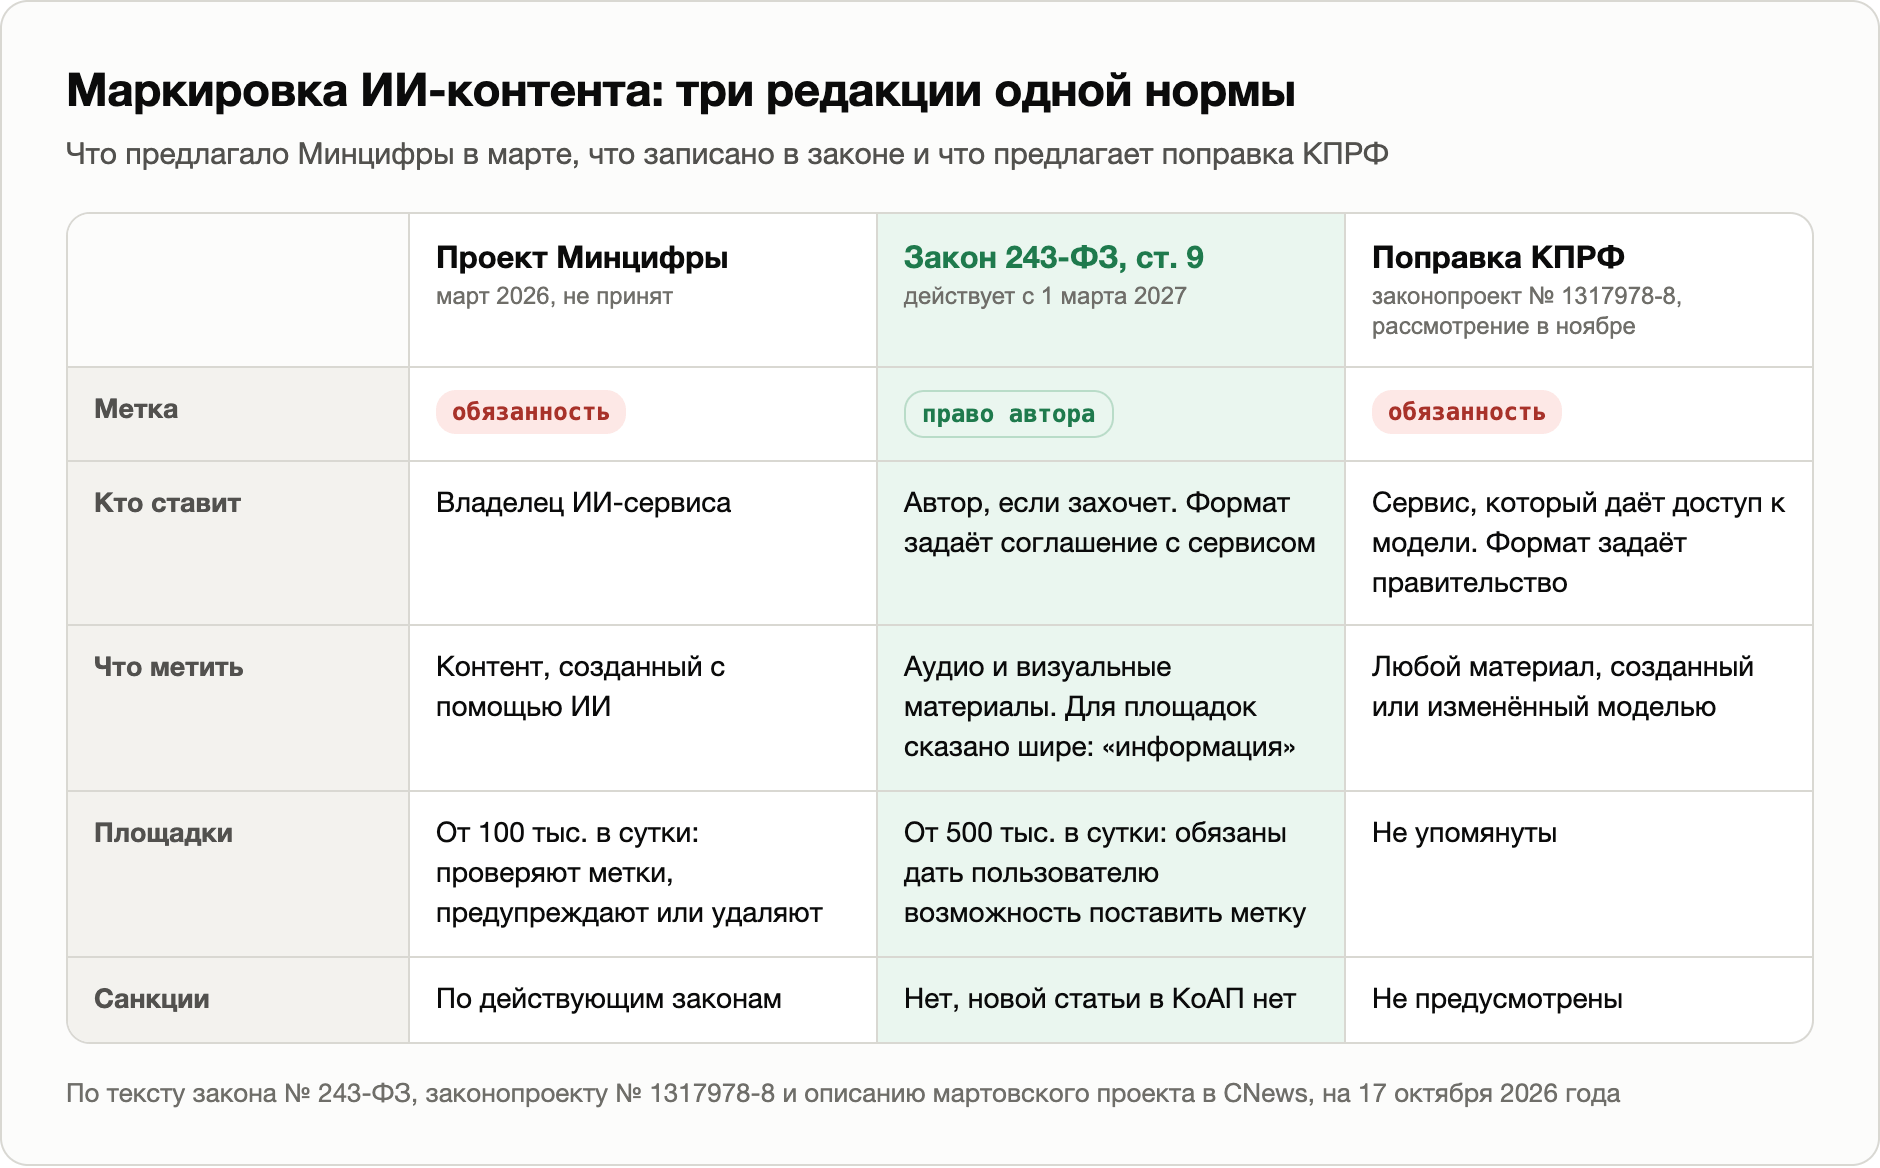
Маркировка добровольная. С 1 марта 2027 года у крупных площадок появится обязанность: пользователь должен получить возможность поставить на материал пометку о том, что его создал ИИ. Сам материал помечать при этом не обязан никто.
Штрафов закон не вводит. В части ответственности он ссылается на уже действующие нормы, своих санкций в тексте нет.
Большая часть конкретики включится 1 марта 2027 года и придёт постановлениями правительства. Их проекты уже обсуждают: для каких сфер оставят лишь российские модели, что станет основанием для присвоения статуса, нужен ли ИИ-помощник на смартфоне по умолчанию. До этой даты многое держится на общих формулировках.
Отдельного закона об ИИ до сентября 2026 года не существовало, зато правила накапливались фрагментами. Сначала появились стратегия и эксперименты, позже подтянулись данные и этика. Каждый кусок закрывал свою задачу, общей рамки не было. Без этой предыстории сжатость 243-ФЗ выглядит странно.
Национальная стратегия развития ИИ. Появилась указом президента в 2019 году, в феврале 2024-го её обновили. Именно из неё в закон перешло определение искусственного интеллекта.
Экспериментальные правовые режимы. Закон 258-ФЗ, принятый в 2020 году, разрешает пилотным проектам на время отходить от общих правил. Тогда же, в 2020-м, появился отдельный закон об эксперименте с ИИ в Москве.
Обезличенные персональные данные. Обрабатывать их в государственной информационной системе без согласия граждан можно с 1 сентября 2025 года. Разрешено это и для обучения моделей.
Кодекс этики в сфере ИИ. Документ 2021 года, добровольный; под ним стоят подписи крупных компаний отрасли.
Поручение президента от 1 апреля 2025 года № Пр-706. В пункте 5 предлагалось взвесить, не сделать ли применение ИИ отягчающим обстоятельством. Об этом ещё пойдёт речь в разделе про ответственность.
Всё перечисленное касалось данных, экспериментов и этики. Сами модели как объект права в законодательстве отсутствовали вплоть до 243-ФЗ.
Первую версию Минцифры опубликовало 18 марта 2026 года. Имя у неё было другое: «Об основах государственного регулирования сфер применения технологий искусственного интеллекта». Вступить в силу документ должен был 1 сентября 2027 года. По сравнению с итоговым законом это был текст о контроле.
В мартовском проекте было:
все модели делились на три категории: суверенные, национальные, доверенные. Модели из последней категории готовили для государственных информационных систем и значимых объектов критической информационной инфраструктуры; проверку в ФСБ и ФСТЭК они проходили, а затем попадали в реестр;
обязанность владельца ИИ-сервиса маркировать созданный контент;
платформы, чья суточная аудитория превышает 100 тысяч человек, должны были проверять пометки, а если их нет, предупреждать автора либо удалять материал;
разработчику, оператору и владельцу сервиса вменялись оценка рисков, отказ от необоснованной дискриминации, тестирование и остановка системы при возникновении киберугрозы;
ИИ-сервисы, которые собирали в сутки больше 500 тысяч человек, попадали под требования «закона Яровой»: данные следовало хранить и передавать силовым структурам;
каждый участник цепочки отвечал соразмерно вине, если о возможном противоправном результате он знал или мог знать;
возможность запрещать или ограничивать трансграничные ИИ-технологии;
дата-центрам под ИИ обещали послабления: сети подключают бесплатно, электричество идёт по тарифу ниже промышленного, договоры заключаются долгосрочные и с предельной ценой.
В апреле на проект обрушился Совет при президенте по кодификации и совершенствованию гражданского законодательства. Часть норм, как решил совет, расходилась с Гражданским кодексом и подрывала фундамент авторского права.
Новую редакцию кабинет министров выложил 22 июня. Она ужалась до 13 страниц и 13 статей и получила нынешнее название. Из текста выпали реестр и доверенные модели, обязательная маркировка, льготы дата-центрам, ограничения для трансграничных моделей и распределение ответственности. Вице-премьер Дмитрий Григоренко объяснял тогда: «Речь не идет о запрете или ограничении доступа к иностранным нейросетям».
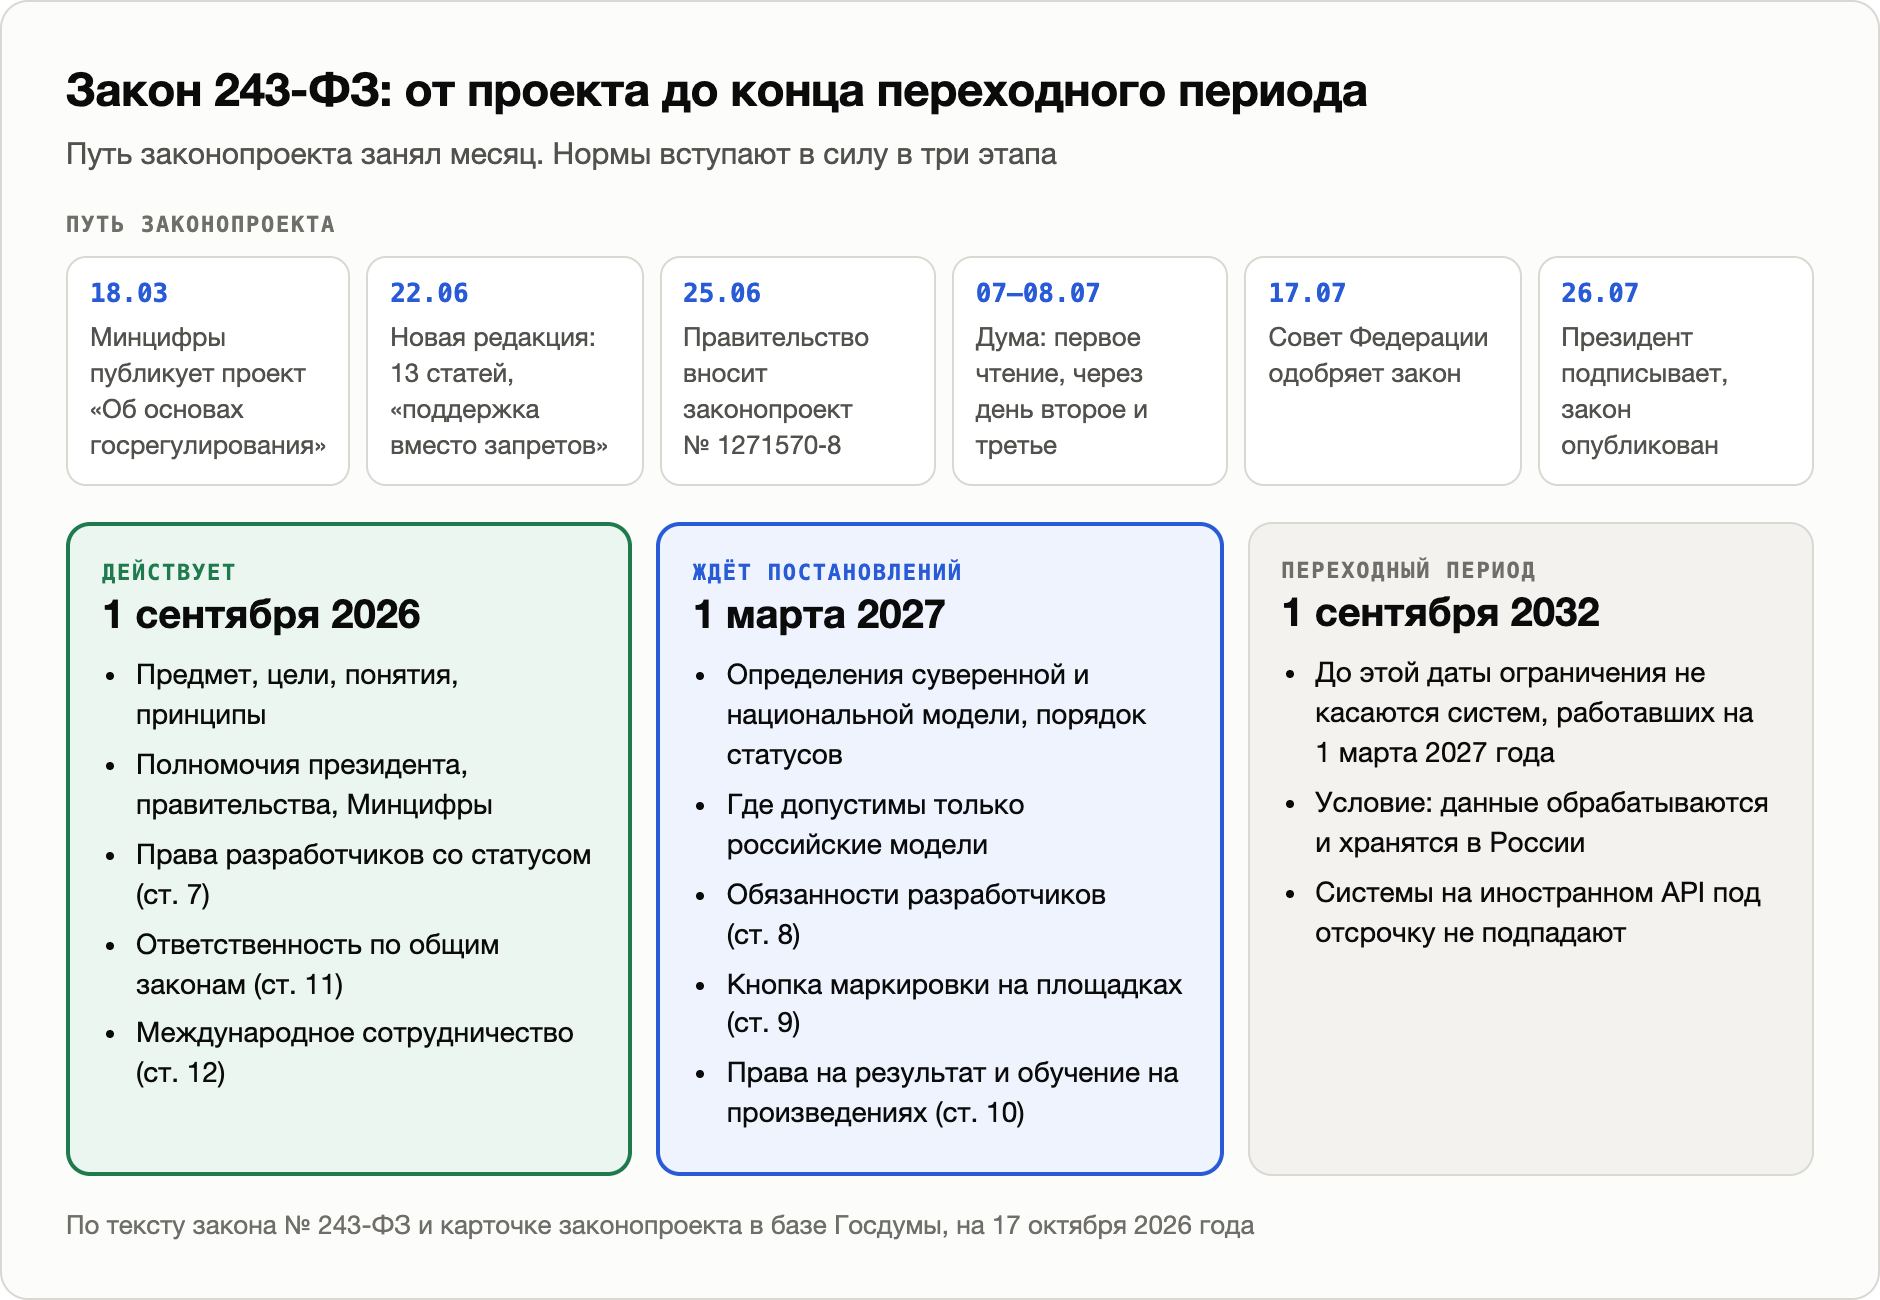
Остальное заняло очень мало времени. В базе Госдумы у документа номер 1271570-8, и его карточка фиксирует такую хронологию:
25 июня 2026 года: правительство вносит законопроект;
7 июля: первое чтение в Думе, поправки собирали ровно сутки;
8 июля: депутаты голосуют второе и третье чтения подряд;
17 июля: документ поддержал Совет Федерации;
26 июля: подпись президента, и в тот же день текст опубликован.
Внесение и подпись разделил месяц. Ко второму чтению из предмета регулирования убрали слово «использование», оставив «разработку, внедрение и применение». Термин «состав данных» заменил прежний «Набор данных», а «настройка» параметров превратилась в «подбор». Требования к суверенной модели лишились «матрицы исходных коэффициентов», единственным пунктом там осталось обучение. Норму о площадках с кнопкой маркировки переписали: теперь она адресована владельцам сайтов, информационных систем и программ, чья суточная аудитория превышает 500 тысяч человек, а не владельцам соцсетей. Поправка депутата Михаила Шеремета, предлагавшая упростить получение статуса национальной модели для малого и среднего бизнеса, не набрала голосов.
В третьем чтении фракция «Справедливая Россия» воздержалась. Закон рамочным назвал председатель Думы Вячеслав Володин: конкретику пропишет правительство в подзаконных актах, а к основным положениям Дума пообещала вернуться до конца года.
Предмет у статьи 1 узкий: разработка, внедрение и применение больших фундаментальных моделей ИИ. Модели, которые под это описание не попадают, закон не касается.
Определение дано в пункте 2 статьи 3. Большая фундаментальная модель есть программа для ЭВМ, которая одновременно:
справляется с интеллектуальными задачами на человеческом уровне либо выше него;
обучена на составах данных, чтобы по заданным человеком целям выводить закономерности, давать информацию, принимать решения или прогнозировать;
на её основе создают и дорабатывают другое программное обеспечение;
насчитывает не менее 1 миллиарда параметров;
применяется для множества самых разных задач.
Совпадать должны все признаки разом. Возьмём модель с 7 миллиардами параметров, распознающую только автомобильные номера: задача у неё одна, и под определение она не попадает. Универсальной модели на 500 миллионов параметров не хватает размера. Вне закона остаются кредитный скоринг и антифрод, компьютерное зрение, сценарные чат-боты и классификаторы. По оценке АНО «Цифровая экономика», таких больших фундаментальных моделей в стране несколько десятков.
Разработчиком закон видит юрлицо или индивидуального предпринимателя, если они такую модель проектируют, обучают либо модифицируют. Всё держится на слове «модификация». Если компания дообучает открытую модель с 8 миллиардами параметров под себя, по определению она и есть разработчик. Правда, до появления статуса никаких обязанностей у неё нет.
В пункте 1 статьи 3 определение самого ИИ опирается на Национальную стратегию и чуть расширено. Под ИИ закон понимает «комплекс технологических решений, позволяющий имитировать когнитивные функции человека»; к этому добавляется способность выдавать при решении конкретных задач результаты, сопоставимые с человеческими или превосходящие их. Скобки добавляют три свойства: искать решения без заранее заданного алгоритма, повышать точность за счёт новых данных и самостоятельно совершенствовать свои функции. Из чего складывается комплекс? Из инфраструктуры, программ, сервисов обработки данных и процессов.
Отдельное регулирование сохраняет часть 3 статьи 1: оборону и безопасность, оперативно-разыскную деятельность, охрану порядка и безопасность дорожного движения, противодействие отмыванию денег и финансированию терроризма, предотвращение чрезвычайных ситуаций, дипломатию и государственное управление. Другие федеральные законы и акты президента вправе прописать там особенности.
В статье 4 названы девять принципов. Несколько из них предсказуемы: развитию обещают благоприятные условия, человеку гарантируют права и свободы и уважение к его автономии и свободе воли, отдельно упомянуты безопасность, сотрудничество с другими странами и поддержка отечественных разработчиков.
Три принципа задают характер закона.
Технологическая независимость. Разработка моделей «при сохранении национального контроля над критическими и сквозными технологиями на основе собственных линий разработки технологий» ради экспорта и замещения на внутреннем рынке продукции на «устаревших и (или) иностранных технологиях».
Риск-ориентированный подход. Насколько строгими будут требования к применению модели, зависит от того, насколько вероятен и масштабен вред: людям (жизни и здоровью), их деловой репутации, имуществу, окружающей среде, а также технологической независимости государства. Европейский AI Act устроен по той же логике. Однако перечня запрещённых применений и классов риска российский закон не вводит: правительство всего лишь получает право устанавливать отраслевые требования.
Традиционные российские духовно-нравственные ценности. В законе они выписаны целиком: жизнь и достоинство человека, его права и свободы; гражданственность, патриотизм, служение Отечеству и ответственность за его судьбу; созидательный труд, высокие нравственные идеалы, крепкая семья, приоритет духовного над материальным; справедливость, гуманизм и милосердие, коллективизм, взаимопомощь, взаимоуважение; преемственность поколений и историческая память, единство народов России.
Пока принцип существует сам по себе, это чистая декларация. Другое дело статья 6: там он превращается в условие статуса, и это, пожалуй, самая рабочая норма всего документа.
Полномочия разложены в статье 5. Национальную стратегию развития ИИ утверждает президент. Правительству достались координация ведомств, меры поддержки и случаи, когда применение российских моделей обязательно; отраслевые требования по рискам оно тоже вправе вводить. По банкам и финансовому рынку оба решения проходят согласование с Банком России.
Минцифры как уполномоченный орган в сфере информационных технологий следит за развитием больших моделей, предлагает поправки в регулирование, помогает госорганам и муниципалитетам осваивать их и готовит меры стимулирования. Контроля по этому закону у ведомства нет: проверять оно не может, реестра не ведёт, штрафовать не вправе.
Большие модели в основных отраслях, социальной сфере и управлении осваивают госорганы, муниципалитеты, госкорпорации и Центробанк, каждый в своей сфере. Под это подогнаны цели из статьи 2: ускоренное развёртывание, государственная поддержка исследований, независимость в технологиях, эффективное управление, конкурентоспособность «на мировом уровне» и вывод российских технологий на зарубежные рынки. Пользователя тоже вспомнили, но лишь общей формулой о безопасности личности, общества и государства.
В статье 6 появляются два статуса. Набор требований у них почти одинаковый, а расходятся они по двум пунктам.
Суверенная модель должна выполнить пять условий:
разработчиком выступает российское юридическое лицо;
тот же разработчик задаёт характеристики модели и меняет их на любой стадии жизненного цикла;
он обеспечивает техническую и технологическую воспроизводимость всего цикла разработки, включая обучение, в полном объёме;
ответы пользователям формируются, а данные хранятся в дата-центрах, расположенных в России и принадлежащих российским юрлицам;
модель подтвердила соответствие российскому законодательству и традиционным ценностям по процедуре, которую определит правительство.
У национальной модели владелец тот же: российское юрлицо, дата-центры тоже отечественные, подтверждение соответствия законодательству и ценностям тоже требуется. Разница кроется во втором и третьем требованиях. Здесь компания из России самостоятельно задаёт и меняет лишь существенные характеристики, а их список утвердит правительство: программное обеспечение, структуру, настраиваемые параметры. Компоненты для разработки допустимы любые, включая чужие большие модели, лишь бы они распространялись по открытой лицензии.
Если коротко: суверенную модель обучают с нуля, и весь цикл воспроизводится силами одной компании. Национальной разрешено опираться на чужую открытую основу, но структура, код и параметры должны оставаться в руках российского разработчика.
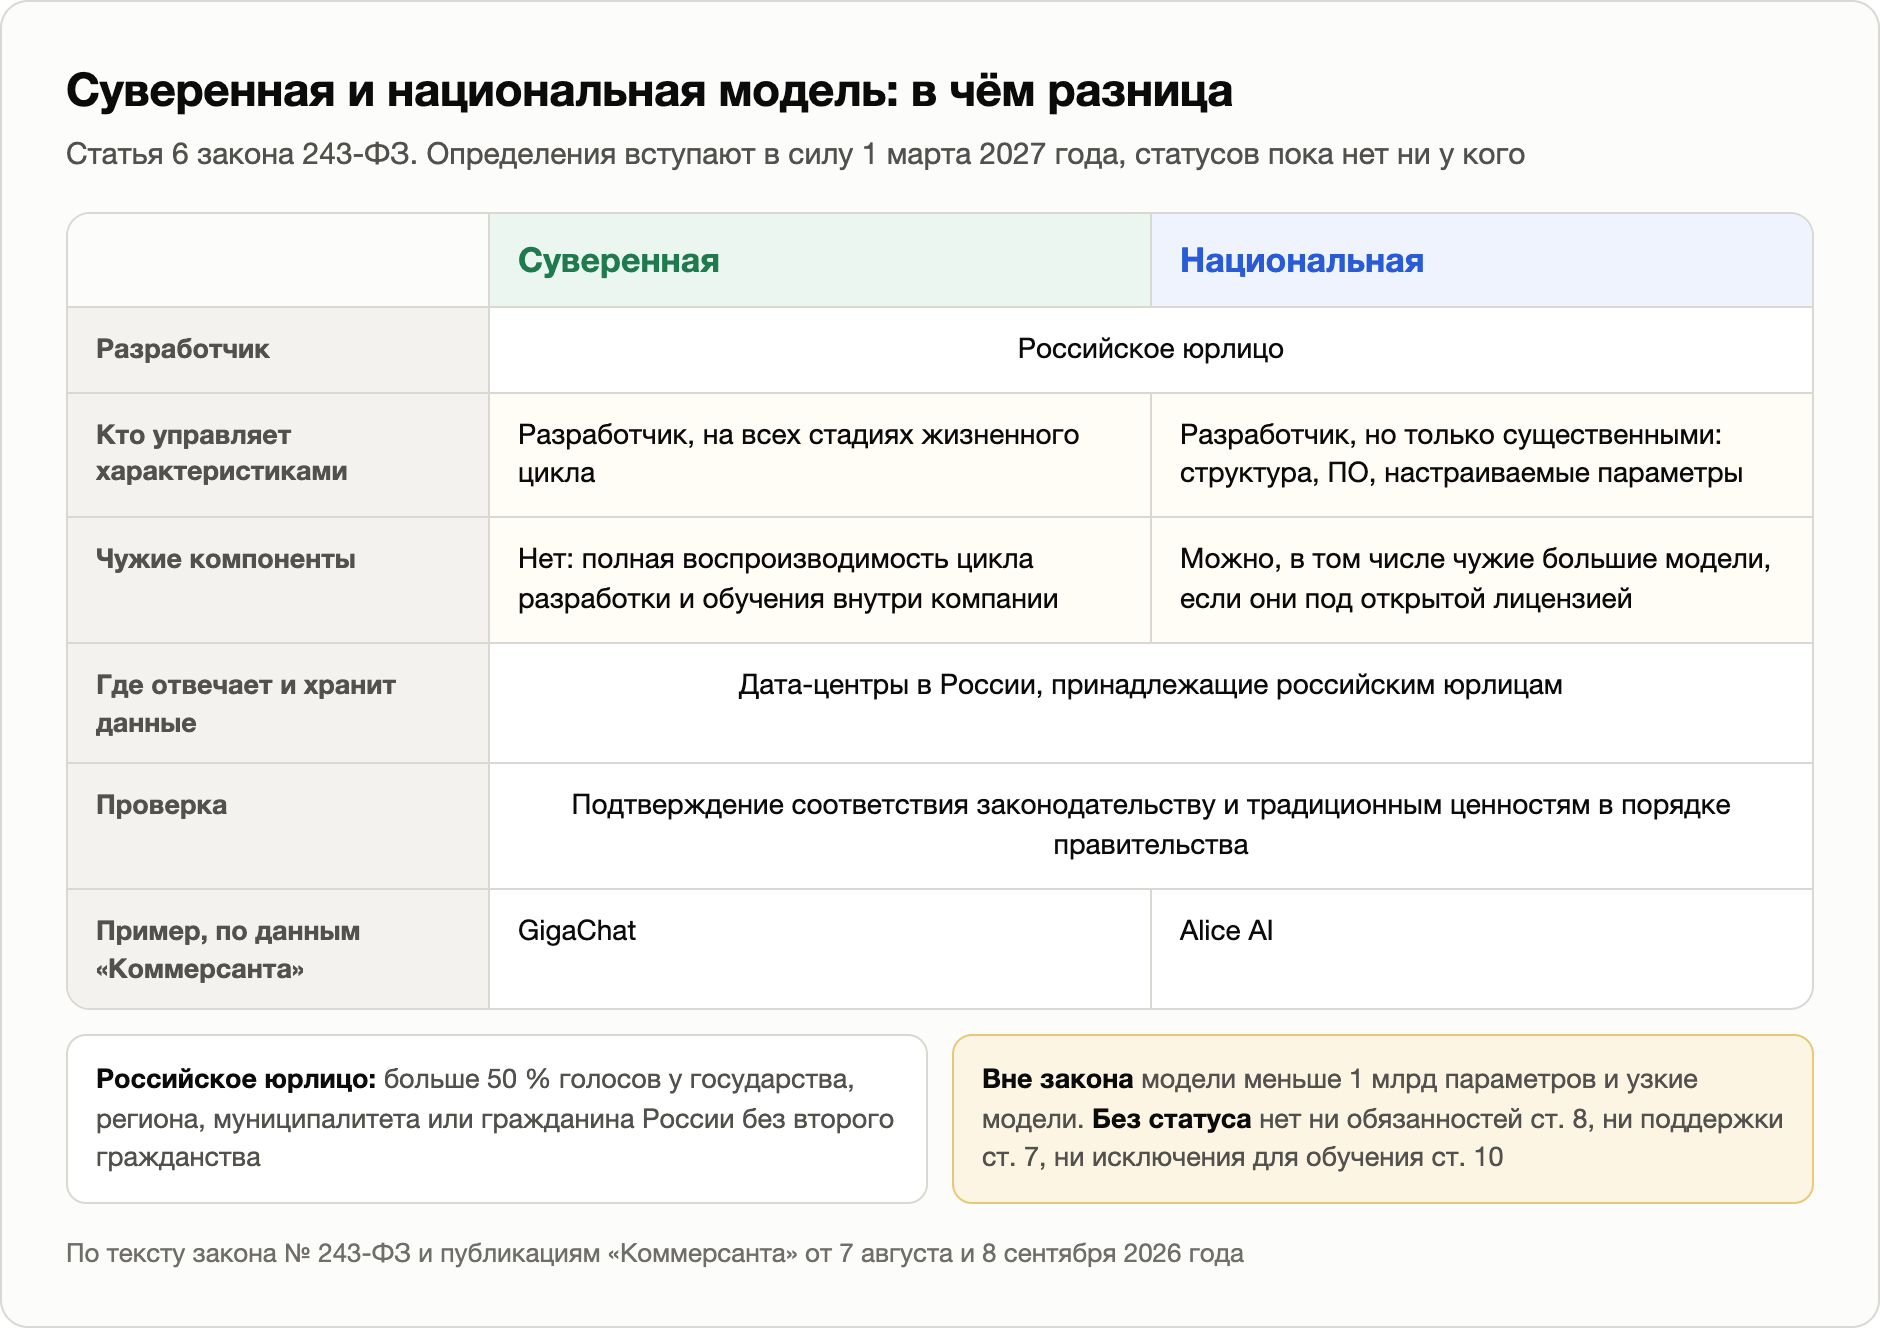
Российское юрлицо в понимании закона это компания, которую контролирует государство, регион, муниципалитет или гражданин России, не имеющий второго гражданства, по отдельности либо вместе. Контроль означает возможность прямо или косвенно распоряжаться более чем 50 % голосов. Компания с иностранным мажоритарием статус не получит, если международный договор не предусматривает иного, даже когда она зарегистрирована в Москве, а серверы стоят в Подмосковье.
На пятом требовании стоит задержаться. Соответствие «традиционным российским духовно-нравственным ценностям» становится условием получения статуса. Кто и по каким критериям будет это проверять, как пройдёт процедура, в законе не сказано: порядок определит правительство. Ему же достаются учёт моделей и присвоение статусов. Сегодня ни одного статуса не существует и появиться не может: части 2–5 статьи 6 с самими определениями начнут действовать только 1 марта 2027 года.
Официальный перечень пока не опубликован. Со ссылкой на участников рабочей группы «Коммерсантъ» 8 сентября сообщал: под определение суверенной модели сегодня попадает одна GigaChat Сбера. Alice AI «Яндекса» та же газета назвала примером модели национальной.
Критерии национальной модели из ещё не принятого проекта постановления это же издание разобрало 7 августа. Исключительные права разработчику нужны на:
архитектуру и обучаемые параметры, в том числе топологию сети и конфигурационные файлы;
исходный код, на котором модель обучают и эксплуатируют;
настройку контекстного окна.
Всё прочее может быть иностранным, открытым или чужим. Руководитель проектов по аналитике ИИ Тимофей Воронин оценивает, что подобные условия отсекут порядка 90 % российских компаний и ИИ-стартапов. Продукты большинство из них собирает на открытом коде, так что на статус в реальности способны претендовать лишь крупные экосистемы. Владимир Нелюб, директор по науке и ИИ «Группы Астра», видит в статусе инструмент доступа к государственным данным и крупным госконтрактам, а не обязательное условие работы на рынке. Малым языковым моделям, по словам АНО «Цифровая экономика», статус не предусмотрен вовсе.
Всплывает в спорах о статусах и цена. Сервис AIANA, на данные которого ссылается «Коммерсантъ», оценивает тысячу токенов GigaChat Max в 0,65 рубля; у YandexGPT Pro 5.1 это 0,8 рубля, у открытых моделей примерно 0,2–0,3 рубля. Сергей Кобелев из «Яков и партнёры» в том же материале обратил внимание, что деньги уходят главным образом на внедрение, человеческую проверку результата и доработки, а не на токены.
Статья 7 описывает, что вправе делать разработчик суверенной или национальной модели. Прав у него пять:
рассчитывать на меры государственной поддержки;
учить модель на чужих произведениях, соблюдая правила статьи 10;
входить в отраслевые организации, участвовать в разработке этических правил, предлагать идеи для государственной политики в области ИИ;
сотрудничать с зарубежными партнёрами, вести совместные исследования и экспортировать технологии;
страховать имущественные интересы и ответственность за вред, который может возникнуть при применении модели.
Что это за меры, закон не говорит. Определяет их правительство, и статья 5 даёт ему широкие полномочия: поддержка финансовая, имущественная, гарантийная и информационная.
Но есть ресурс дороже денег — данные. Порядок доступа к ним установит правительство, согласовав его с ФСБ. Речь о том, откуда брать данные: из федеральных информационных систем, а также из систем унитарных предприятий федерального уровня и учреждений. Такие наборы нужны, чтобы обучать суверенные и национальные модели. Регионам разрешили так же поступать с данными собственных систем и подведомственных организаций. Григоренко 24 сентября отнёс доступ к данным, в том числе к государственным, к числу главных вопросов, которые предстоит решить в подзаконных актах.
Статья 12 говорит и о другом: российским гражданам и компаниям нельзя запрещать сотрудничать с зарубежными партнёрами в сфере больших моделей. Исключением станут отдельные значимые направления, которые определит правительство.
Со сроками у статьи 7 вышла странность. Силу она набрала 1 сентября 2026 года, а определения того, что считать суверенной и национальной моделью, появятся лишь 1 марта 2027-го. Выходит, полгода права разработчиков со статусом действуют, а самих разработчиков со статусом ещё нет.
Наша система сама подберет вам исполнителей на услуги, связанные с разработкой сайта или приложения, поисковой оптимизацией, контекстной рекламой, маркетингом, SMM и PR.
Заполнить заявку
13801 тендер
проведено за восемь лет работы нашего сайта.
Статья 8 занимает немного места. Разработчику суверенной или национальной модели вменяется в обязанность:
обеспечить безопасность модели, приняв технические и организационные меры;
задать правила эксплуатации, включая ограничения и условия, на которых модель применяют, обновляют и выводят из эксплуатации;
вести техническую документацию, где описаны основные параметры и ограничения в объёме, которого хватит, чтобы можно было оценить безопасность применения.
Действуют эти обязанности с 1 марта 2027 года и касаются только тех, у кого есть статус. Разработчик без статуса, будь он российский или иностранный, по этому закону не должен ничего. Такова логика документа: требования здесь — условие участия в господдержке, а не общие правила для рынка.
Больше всего вопросов возникло вокруг статьи 9. Разбирать её удобнее по частям.
Часть 1. Если человек делает аудио- или видеоматериал при помощи большой модели, ему обеспечивают возможность поставить информационное предупреждение о том, что применены технологии искусственного интеллекта. Это право, а не обязанность. Про тексты в этой части нет ни слова.
Часть 2. Как предупреждение выглядит, что в нём написано и куда его помещать, определяет договор между тем, кто даёт доступ к модели, и её пользователем. Обычно это пользовательское соглашение сервиса.
Часть 3. И только здесь возникает единственная обязанность. Хозяин сайта, отдельной страницы, информационной системы или программы должен позволить людям размещать предупреждение о том, что задействованы большие модели. Но лишь при условии, что ресурс отвечает сразу четырём признакам:
через персональные страницы, которые создают сами пользователи, на нём распространяют информацию;
он работает на русском, на государственных языках республик либо на других языках народов России;
на нём может показываться реклама, нацеленная на потребителей в России;
его посещают свыше 500 тысяч пользователей из России за сутки.
Ровно по таким же критериям, персональные страницы, реклама и порог в 500 тысяч пользователей за сутки, Роскомнадзор с 2021 года ведёт реестр социальных сетей. Основание — статья 10.6 закона об информации. В реестре ВКонтакте, Одноклассники, YouTube, Telegram и другие. Прямой отсылки к этому реестру в законе нет, поэтому точный список площадок покажет практика.
Заметьте, части расходятся между собой. В части 1 речь об аудио и визуальных материалах. Часть 3 смотрит шире: речь идёт об информации, которую произвели при помощи больших фундаментальных моделей ИИ. Если читать буквально, площадка должна дать возможность пометить даже текстовый пост. Что скажут проверяющие, выяснится не раньше марта.
Наказания за то, что кнопки не будет, закон не предусматривает: в КоАП новой статьи не появилось. Силу статья 9 набирает 1 марта 2027 года.
Идея обязательной маркировки в Думе уже проваливалась. Депутаты Дмитрий Гусев, Алексей Журавлёв и Михаил Делягин внесли законопроект № 1069302-8: они хотели, чтобы на сгенерированном видео стояла надпись «Сделано ИИ». 24 апреля профильный комитет посоветовал проект отклонить, и 10 июня 2026 года Дума так и поступила. Антон Горелкин объяснял тогда, что мера трудновыполнима: авторы не решили, на каком шаге появляется метка и на кого ложится ответственность за ошибку в ней.
Вопросы из практики никуда не делись. Кто поставит метку, когда ролик смонтировал один человек, а выложил совсем другой? Уцелеет ли она, когда файл загрузят на другую площадку? И кто всё это проверяет? Алексей Шпильман из «Т-Технологий» назвал главную трудность: дело не в том, чтобы метку поставить, а в том, чтобы она сохранилась. Видимую надпись ничего не стоит обрезать, а невидимый водяной знак сумеет убрать другая модель.
17 августа 2026 года депутаты от КПРФ Нина Останина, Сергей Обухов, Алексей Корниенко и Михаил Матвеев предложили поправку к уже принятому закону. Статью 9 они хотят изложить заново, целиком.
Начать действовать поправка должна 1 марта 2027 года, вместе с исходной статьёй. Отвечать за метку будет сервис, открывающий доступ к модели, а не автор и не площадка. В проекте нет ограничений по аудио и видео, поэтому формально метить пришлось бы и тексты. Из новой редакции убрали и право пользователя на такое предупреждение, и обязанности площадок. При этом проект не вводит и наказаний за нарушение.
Авторы в пояснительной записке опираются на мировой опыт. Китай с 1 сентября 2025 года ввёл два уровня маркировки: видимый и скрытый, в метаданных. Индия с 20 февраля 2026 года потребовала от платформ видимой метки на сгенерированных материалах и сохранения источника в метаданных. Европейский AI Act требует, чтобы маркировка была машиночитаемой.
12 октября Совет Думы передал проект в новый комитет по цифровому развитию и искусственному интеллекту. Отзывы собирают до 11 ноября, а рассмотрение уже стоит в примерной программе на ноябрь.
В статье 10 две части, и обе начнут действовать 1 марта 2027 года.
Первая часть распространяется на любой сервис, в том числе на компании без статуса. Каждый, кто открывает доступ к большой модели, должен сообщить пользователю следующее, если закон не устанавливает иного:
кому принадлежат права на то, что получилось с помощью модели;
по каким условиям он получает к результатам доступ, может ими пользоваться и хранить их, когда это позволяет техника.
На деле это превращается в пункт пользовательского соглашения. Норма формально охватывает и зарубежные сервисы, которые работают в России, но механизм применения к ним в законе не описан.
Вторая часть добавляет изъятие из авторского права. Нарушением авторских и смежных прав не считается работа с информацией из произведений: её машинное извлечение, сравнение, классификация, поиск закономерностей, тенденций и корреляций, а также кратковременная запись в память компьютера. Условий два:
задача сводится только к обучению суверенной или национальной модели;
разработчик получил копию произведения законно, либо произведение обнародовано и открыто для анализа, не закрытого техническими средствами.
Получается, запретить обучение правообладатель способен лишь технически: спрятать текст за пейволлом, входом по логину или другой защитой. Записи на сайте о запрете недостаточно. Попадает ли под техническое средство директива в robots.txt или машиночитаемая оговорка, как это работает в Европе с анализом текстов и данных, закон не объясняет. Платы за такое использование тоже нет.
Изъятие действует лишь для суверенных и национальных моделей. Все прочие разработчики остаются при общих нормах Гражданского кодекса, а там подобной оговорки нет.
Согласно пункту 5 статьи 1229 ГК, рамки исключительных прав задаёт только сам кодекс. Правило об обучении прописали в другом законе, и на этот разрыв обратила внимание Лидия Михеева, заместитель председателя Совета по кодификации.
До второго чтения правообладатели настаивали на плате за обучение или на согласии автора. В финальной редакции ничего подобного нет. Дальше события разворачивались так:
в конце июля президент, по сведениям «Ведомостей», дал поручение готовить поправки, которые урегулируют отношения разработчиков нейросетей и правообладателей;
Совет по кодификации собрал рабочую группу по правкам в четвёртую часть ГК, от неё ждали предложений к концу сентября. Сопредседатель совета Павел Крашенинников: «Нужен баланс, мы попробуем его выстроить»;
5 августа появилась отдельная правительственная группа по ИИ и авторскому праву для медиа и творческих сфер;
звучали варианты: прямое лицензирование, коллективное управление правами, отчисления по модели «налога на болванки», который в авторском праве даёт 1 % от цены техники и носителей. Аналогию предложил Игорь Дроздов, зампред ВЭБ.РФ.
Открытого текста поправок на 17 октября я не нашёл. Дмитрий Шатунов, депутат нового думского комитета по ИИ, назвал авторское право одной из тем, по которым закон будут дорабатывать.
Вся статья 11 умещается в одну фразу: нарушив закон или подзаконные акты, участники отношений «несут ответственность в соответствии с законодательством Российской Федерации». Свежих составов в КоАП или УК документ не добавляет.
Из этого не следует, что за ИИ теперь ничего не будет. Обман с поддельным голосом остаётся мошенничеством, ложь в подделанном ролике остаётся клеветой, а утечка персональных данных через чат-бота идёт по статьям о персональных данных. Своих новых составов закон к ним не прибавляет.
14 июля 2026 года законопроект № 1288702-8 внесли депутаты фракции ЛДПР во главе с Леонидом Слуцким и два сенатора. Документ добавляет в часть 1 статьи 63 УК пункт «х»:
совершение преступления с использованием видеозаписи, аудиозаписи, изображения (в том числе электронного) или иных аудиовизуальных материалов, созданных с применением технологий искусственного интеллекта или иных технических средств обработки информации, если такие материалы воспроизводят или имитируют высказывания или действия лица, фактически им не совершенные, либо демонстрируют человека, личность которого сгенерирована технологиями.
Заработать поправка должна была 1 сентября 2026 года. Дата прошла, но комитет по государственному строительству и законодательству решения по проекту до сих пор не вынес.
К проекту приложили два официальных отзыва, и оба критические. Верховный суд в отзыве от 19 марта 2026 года за подписью заместителя председателя Н. В. Тимошина пишет, что по тому самому поручению № Пр-706 разобрал судебную практику и провёл опрос судей. Что показали суды:
дела, где преступники применяли технологии, которые можно отнести к ИИ, оказались единичными;
такой признак логичнее встроить в конкретные статьи, например о мошенничестве, как квалифицирующий или составообразующий, а не делать общим отягчающим;
нынешняя формулировка не разделяет правомерное и неправомерное использование и «может повлечь необоснованное расширение уголовно-правовой репрессии».
Правительство в отзыве от 14 апреля 2026 года ответило скупо. Похожие инициативы уже проходили через его отзывы от 22 июля 2024 года и 22 августа 2025 года, замечания оттуда не устарели, а «позиция Правительства Российской Федерации не изменилась».
По пересказам законопроекта кочует цифра 675,4 тысячи «преступлений с использованием дипфейков» за 2025 год. В пояснительной записке сказано иначе. По данным МВД, столько составили все преступления, где задействованы информационно-телекоммуникационные технологии либо компьютерная информация: 38,1 % от зарегистрированных. Внутри 348 тысяч приходится на мошенничество, 138,7 тысячи на незаконный оборот наркотиков, 81 тысяча на кражи.
О самих дипфейках в записке другие числа. АНО «Диалог Регионы» насчитало за девять месяцев 2025 года 342 уникальных дипфейка в рунете, тогда как за весь 2024 год их было 84. Копий набралось порядка 55 тысяч, а суммарный охват перевалил за 122,5 миллиона просмотров. VisionLabs по материалам «Известий» от 16 октября нашла 627 дипфейков за 2025 год и около 900 за 2026-й к сентябрю. Методики у источников расходятся, однако рост видно по любой. Но речь идёт о сотнях уникальных подделок, а не о сотнях тысяч преступлений.
Одно ограничение по ИИ работает уже сейчас, и прописано оно не в 243-ФЗ. Закон подписали 2 мая 2026 года, Дума приняла его 21 апреля по проекту № 1155581-8. Агитация в кампании не может опираться на изображения и голоса людей, созданные информационными технологиями, а также на образы вымышленных и умерших персон. Исключение сделано для самого кандидата, для выдвинувшей его партии и для совершеннолетних граждан, которые дали письменное согласие по форме ЦИК.
Статья 13 сдвигает на 1 марта 2027 года ряд норм:
право правительства решать, когда допустимы только суверенные или национальные модели;
право правительства вводить отраслевые требования, связанные с предотвращением рисков;
порядок доступа к государственным данным для обучения моделей;
определения суверенной и национальной модели и российского юрлица, порядок присвоения статусов;
обязанности разработчиков, маркировку и авторско-правовые нормы.
Дата не случайна. Закон об обязательных требованиях № 247-ФЗ задаёт общее правило: новые обязательные требования вступают в силу 1 марта или 1 сентября, причём не раньше чем через 90 дней после публикации. Значит, постановления должны выйти примерно до начала декабря. Иначе требования не заработают 1 марта 2027 года, и следующей датой станет 1 сентября 2027 года.
Главное из ожидаемых постановлений определит, где допустимы исключительно суверенные или национальные модели. Для банков и финансового рынка эти случаи согласуют с Банком России.
В рабочей версии перечня, о которой «Коммерсантъ» писал 8 сентября, восемь направлений:
критическая информационная инфраструктура;
стратегическое планирование;
государственные программы и национальные проекты;
подготовка нормативных актов госорганами;
налоговая, таможенная и бюджетная сферы;
образование;
здравоохранение;
государственные услуги.
Обсуждали также безопасность, выборы и государственное управление. Самый спорный пункт рабочей версии: если суверенная модель дороже сопоставимой национальной не более чем в полтора раза, компания обязана выбрать именно её. Источник издания говорил, что предложение шло от Сбера, который владеет единственной моделью, подходящей сейчас под суверенную. В Сбере это опровергают и называют перечень сводом идей всех участников рабочей группы.
Позиции участников разошлись:
Минцифры обсуждение подтвердило, но заявило, что говорить о сформированном перечне рано;
«Яндекс» выступил за конкуренцию и за право отраслей самостоятельно выбирать технологические решения;
MWS AI предупредила: для некоторых задач в критических отраслях моделей, подходящих по качеству и экономике, может не найтись;
Антон Сипачёв из Just AI отметил, что на прикладных задачах компактные модели вроде GigaChat Lightning или YandexGPT Lite дают сопоставимое качество дешевле, а главным выгодоприобретателем правила назвал одну компанию.
Часть 3 статьи 13 прикрывает системы, которые уже работают. Ограничение на применение только российских моделей не действует до 1 сентября 2032 года для информационных систем, созданных или эксплуатируемых на день вступления нормы в силу, то есть на 1 марта 2027 года. Условие одно: обработка и хранение данных идут в России.
Отсюда практика. Если система из будущей сферы обращается к иностранной модели по API, данные уходят за рубеж, и переходный период на неё не распространяется. Если же модель развёрнута на собственных серверах в России, у владельца остаётся ещё пять с половиной лет.
Часть 4 той же статьи разрешает особенности применения статей 3 и 6 в экспериментальных правовых режимах, но по согласованию с Минцифры. Для пилотных проектов программа режима способна смягчить требования к статусу или само определение большой модели.
Ещё один проект постановления Минцифры переписывает правила обязательной предустановки программ, постановление № 1867. Категорию «голосовой помощник» хотят заменить «системным помощником»: это ИИ-программа, которая работает с устройством, операционной системой и приложениями через голос, текст и изображения. Предустанавливать обяжут программу с моделью, получившей национальный или суверенный статус.
«Коммерсантъ» писал, что такому помощнику предлагали запретить удаление, какое сейчас есть только у магазина приложений, и выдать «все специальные разрешения»: фоновое обновление, фоновые службы push-уведомлений, голосовую активацию. Речь прежде всего об «Алисе AI»: по данным «Яндекса», в сентябре её недельная аудитория дошла до 41 миллиона человек.
«Яндекс» настаивает: пункта о неудаляемости в тексте проекта нет, зато есть возможность отключить помощника, и просит равных условий для российских и иностранных сервисов. Минцифры отвечает, что пользоваться помощником человек должен добровольно.
Ассоциация РАТЭК просит притормозить проект до оценки регулирующего воздействия и сдвинуть вступление в силу минимум на пять месяцев. По её мнению, сквозной доступ помощника к системе спорит с правом пользователя такой доступ закрыть. Фоновое обновление без разрешения технически неисполнимо на закрытых сертифицированных ОС. Проект на доработке.
Аппарат вице-премьера в августе говорил, что подзаконные акты примут «уже осенью». 24 сентября Григоренко сказал: «Мы сейчас готовим подзаконные акты в развитии закона, который принят» и «сейчас о втором пакете мер речи, конечно, не идет».
По его словам, закон будут внедрять несколько лет, проблемы решать по мере практики, а цель — «не отрегулировать ради регулирования». Финальных текстов постановлений к 17 октября я не нашёл. Спор идёт в восьми рабочих группах комиссии правительства по развитию ИИ и на площадке АНО «Цифровая экономика».
Дума девятого созыва, избранная в сентябре, образовала комитет по цифровому развитию и искусственному интеллекту. Возглавил его Александр Сидякин, первым заместителем стал Антон Немкин, оба из «Единой России». Помимо ИИ комитет курирует маркетплейсы, беспилотники и креативную экономику.
Сам закон об ИИ проходил через комитет по информационной политике. Новые законопроекты об ИИ попадают уже в новый комитет, и первой туда ушла поправка КПРФ о маркировке.
Понять короткий закон легче через перечень того, чего в нём не оказалось. Рядом с мартовской версией эти пробелы видны особенно отчётливо.
Реестр моделей. Порядок учёта и правила присвоения статусов определит правительство, однако обязательной регистрации больших моделей документ не вводит.
Классы риска и запрещённые практики. Риск-ориентированный подход записан как принцип, а механизма под него не дали.
Модели без статуса. Иностранный сервис и российская модель, статус не получившая, по этому закону почти ничем не связаны. Исключение одно: пользователя надо уведомить о правах на результат.
Кто за что отвечает. В мартовском проекте роли разработчика, оператора и пользователя были разведены. В принятом тексте такого деления нет.
Автор сгенерированного. Закон требует лишь сообщить пользователю, у кого права на результат. Сам вопрос отдан Гражданскому кодексу: по статье 1228 автором считается гражданин, создавший результат творческим трудом. Картинка, целиком сделанная моделью по короткому запросу, под эту формулу подходит плохо.
Отраслевые правила. Медицина, образование и финансы получат требования только тогда, когда правительство решит воспользоваться правом их ввести.
Запрет иностранных моделей. Ограничения допускаются лишь в сферах, которые определит правительство, и не раньше 1 марта 2027 года.
Российский документ устроен не так, как европейский и китайский. Сравнение помогает понять, что в него заложено.
Евросоюз. AI Act делит системы ИИ по риску применения: запрещённые практики, затем высокий, ограниченный и минимальный риск. Требования к прозрачности из статьи 50, включая машиночитаемую маркировку синтетики, действуют с 2 августа 2026 года. Нарушителю грозит до 15 миллионов евро или 3 % мирового оборота. Для систем высокого риска сроки сдвигает пакет поправок Digital Omnibus, теперь это конец 2027 года.
Китай. С 1 сентября 2025 года там применяют меры по идентификации сгенерированного контента. Метки ставят на двух уровнях: одну человек видит, вторая прячется в метаданных файла. Требование покрывает и текст, и картинки, и звук, и ролики. Площадки обязаны проверять метки, а снимать или подделывать их нельзя.
Индия и Южная Корея. Индия с 20 февраля 2026 года обязывает платформы ставить видимую метку на сгенерированных аудиовизуальных материалах, где имитируются реальные люди, и записывать источник в метаданные так, чтобы удалить запись было нельзя. В Южной Корее маркировка сгенерированного контента действует с января 2026 года.
Россия. Здесь закон берёт в расчёт не применение, а сами модели, и делит их не по риску, а по размеру и происхождению. Маркировка остаётся доброй волей автора, наказания за её отсутствие нет. Содержание сводится к статусам, мерам господдержки, доступу к данным и отложенному требованию брать отечественные модели в госсекторе. По сути это документ о промышленной политике в сфере ИИ, а не о защите пользователей.
Если вы обычный пользователь нейросетей. Пока для вас ничего не меняется. Иностранные модели закон не запрещает и помечать сгенерированное не требует. С 1 марта 2027 года сервисам придётся прямо написать, кто получает права на результат, а крупные соцсети обязаны дать возможность отметить пост как сделанный с помощью ИИ.
Если у вас есть блог или канал. Сгенерированные картинки и ролики по закону помечать не нужно, пока не прошла поправка КПРФ. Только правила площадок нередко строже закона, и читать их приходится отдельно. А в предвыборной агитации сгенерированные лица и голоса под запретом уже сегодня.
Если компания внедряет ИИ. Когда вы не в госсекторе, не в критической инфраструктуре, не в образовании и не в здравоохранении, закон вас почти не задевает. Если ваша сфера из этого списка или вы работаете на госзаказе, держите в поле зрения постановление о случаях обязательного применения. Система, которая к 1 марта 2027 года уже работает на модели, развёрнутой в России, останется защищённой до сентября 2032 года. Тем, кто сидит на иностранном API, такая защита не достаётся.
Если вы разрабатываете модели. Модель с числом параметров меньше миллиарда или узкоспециализированная модель под действие закона не попадает. Дообучив открытую модель, вы формально становитесь разработчиком, но обязанности придут только вместе со статусом. На статус национальной модели можно рассчитывать, если архитектура, параметры и код принадлежат вам, а сторонние компоненты идут по открытой лицензии. Взамен полагаются господдержка, доступ к государственным данным и право учиться на чужих произведениях, не спрашивая согласия авторов.
Если вы правообладатель. С 1 марта 2027 года разработчик модели со статусом сможет учиться на ваших открытых текстах, на картинках и на музыке. Защититься получится только техническими средствами. Поправки в Гражданский кодекс пишутся, но их текста пока нет.
Крупной площадке с личными страницами пользователей. Заложите в продукт возможность пометить публикацию как созданную с помощью ИИ. Речь идёт не об одних картинках и видео: часть 3 статьи 9 охватывает информацию в целом.
Сервису, который пускает к большой модели, в том числе через чужой API. Допишите в условия использования, в каких пределах пользователь вправе его применять и сохранять, и кто получает права на результат. Буквальный смысл части 1 статьи 10 распространяет это на всех, кто даёт возможность применять модель.
Компании из госсектора, критической инфраструктуры, образования или медицины. Составьте перечень систем, в которых работают большие модели, и выясните, где обрабатываются данные. Попадёт ли система в переходный период до 2032 года, зависит именно от этого.
Разработчику, который метит в статус. Разберитесь, как устроена собственность и выдержан ли порог в 50 %, кому принадлежат параметры, архитектура и код, какими лицензиями закрыты сторонние компоненты и в российских ли дата-центрах размещён инференс.
Всем остальным. Следите за regulation.gov.ru. Постановления, которым положено заработать 1 марта, обычно выкладывают туда до декабря.
Текст закона. Это Федеральный закон от 26.07.2026 № 243-ФЗ. Опубликован на официальном портале правовой информации pravo.gov.ru и в Собрании законодательства РФ, 2026, № 30, ст. 4089.
Карточка законопроекта № 1271570-8 живёт в системе sozd.duma.gov.ru. Там есть даты, тексты всех чтений и таблицы поправок.
Законопроекты № 1317978-8 о маркировке и № 1288702-8 о дипфейках лежат там же, плюс к ним пояснительные записки и официальные отзывы.
Проекты постановлений выкладывают на regulation.gov.ru. На момент публикации финальных редакций там не было.
Первым российским законом об ИИ стал короткий и осторожный документ. До марта 2027 года он почти никого ни к чему не обязывает и почти ничего не запрещает, а решать, где останутся только отечественные модели, будет правительство. Значит, настоящее регулирование придёт не с текстом закона, а с постановлениями, которым положено выйти до декабря. Читать их придётся внимательнее самого закона.
Полная версия: http://bigpanda.mirtesen.ru/blog/43510463046/Zakon-ob-II-v-Rossii-chto-deystvUyet-s-1-sentyabrya-2026-goda-i-